
 Krzysztof Burejza
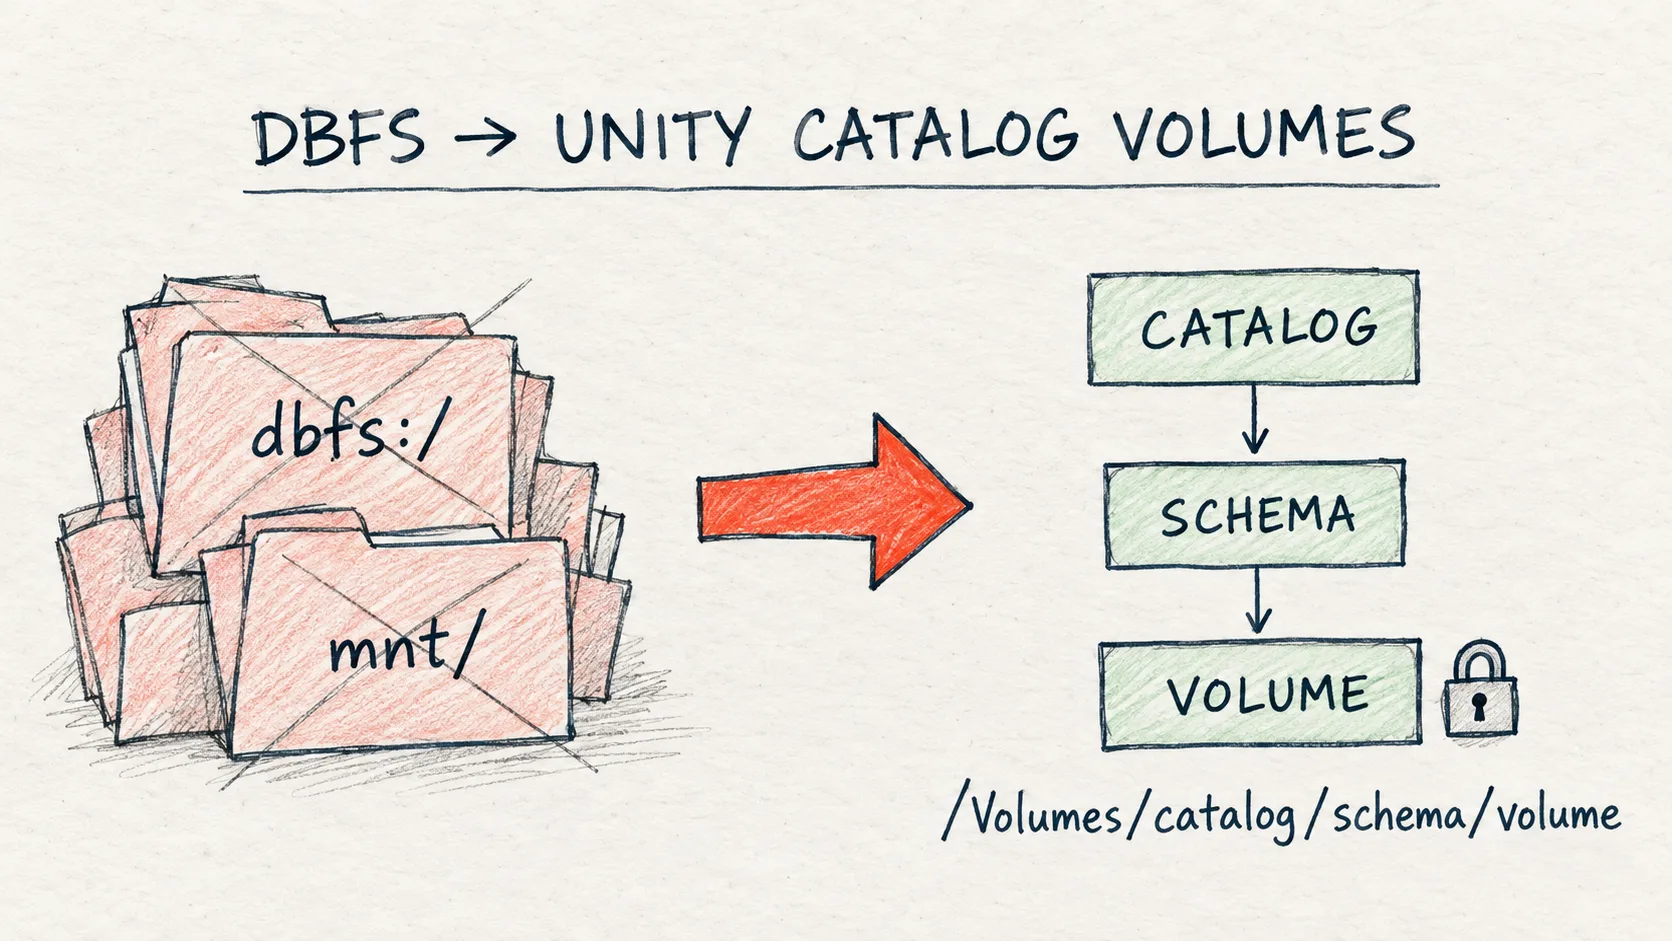
dbfs:/FileStore/... i /mnt/....Aktualizacja (2026-11-02): Databricks podaje teraz w dokumentacji datę 8 października 2026, nie 30 września.
Problem
Bardzo często widzę kod z tutoriali i starszych projektów, w których wszystko leży w dbfs:/FileStore/... albo w /mnt/.... Na workspace'ie, który pracuje w trybie legacy, taki kod dalej działa. Na nowym workspace'ie już nie, bo tych ścieżek tam po prostu nie ma.
Dotyczy to też projektów u klientów, bo wiele systemów to wciąż legacy. Dochodzi do tego AI: asystenci do kodu dalej podpowiadają ścieżki dbfs:/ i /mnt/, choć to już nie jest dobra praktyka.
DBFS (Databricks File System) to wirtualny system plików nad storage'em w chmurze. Jego problemem jest brak governance: każdy użytkownik workspace'u widzi wszystko, co leży w DBFS root, a mount z kluczem do storage'u daje dostęp każdemu, kto zna ścieżkę. Unity Catalog rozwiązuje to przez Volumes, czyli obiekty, które obejmują pliki uprawnieniami, audytem i lineage.
Warto tutaj od razu sprostować jedną rzecz, bo w sieci krąży uproszczona wersja: 8 października 2026 Databricks nie wyłączył DBFS wszędzie. Zmieniło się to, jak powstają nowe workspace'y.
Co dokładnie się zmienia
| Sytuacja | DBFS root / mounty / Hive Metastore |
|---|---|
| Konto Azure Databricks założone po 18.12.2025 | Brak od początku |
| Nowy workspace od 8.10.2026 (w każdym koncie, także starszym) | Brak |
| Istniejący workspace | Działa jak dotąd, migracja jest zalecana |
Jedno zastrzeżenie do tej tabeli (daty podaję za dokumentacją): ustawienia workspace'u pozwalają wyłączyć te funkcje w istniejącym workspace'ie. Czy w nowym da się je włączyć z powrotem, dokumentacja już nie mówi, a na labie tego nie przełączałem. Nie zakładam więc takiej furtki w planie migracji; ustawienia Security każdego workspace'u warto mimo to okresowo przeglądać.
Poprzedni workspace labu, założony 29.09.2026, czyli przed terminem, miał jeszcze domyślny katalog hive_metastore. Workspace labu, na którym nagrałem film, powstał 15.10.2026 w koncie, którego metastore istnieje od listopada 2025, czyli sprzed 18.12.2025. Terraform, którym go stawiamy, tych ustawień nie zmienia. Oba ustawienia workspace'u, disable_legacy_dbfs i disable_legacy_access, miały wartość true, a w SHOW CATALOGS nie było hive_metastore. Nie sprawdzałem, czy na koncie było włączone ustawienie Disable legacy features, więc lab pokazuje, jak wygląda workspace bez funkcji legacy, ale sam w sobie nie dowodzi zmiany z 8.10.
Próbujemy przeczytać plik z DBFS root i pokazać schematy w hive_metastore, a błąd wypisujemy, zamiast przerywać notebook.
✓ Sprawdzone na Free Edition (2026-10-17): te same dwa błędy co na labie
try:
    spark.sql("SELECT * FROM read_files('dbfs:/FileStore/stores.csv', format => 'csv')").show()
except Exception as e:
    print(str(e).split("\n")[0])

try:
    spark.sql("SHOW SCHEMAS IN hive_metastore").show()
except Exception as e:
    print(str(e).split("\n")[0])
Obie komendy kończą się błędem:
[DBFS_DISABLED] Public DBFS root is disabled. Access is denied on path: /FileStore/stores.csv/_delta_log SQLSTATE: 56038
[UC_HIVE_METASTORE_DISABLED_EXCEPTION] The operation attempted to use Hive Metastore, which is disabled due to legacy access being turned off in your account or workspace. ...
Pliku stores.csv w DBFS root w ogóle nie ma, ale blokada i tak dotyczy całej ścieżki w DBFS root. _delta_log w komunikacie to tylko sprawdzenie, czy pod tą ścieżką nie ma tabeli Delta.
W nowych workspace'ach nie ma czterech rzeczy:
- DBFS root i mountów (
dbutils.fs.mount,/mnt/...), - Hive Metastore (
hive_metastorejako katalog), - klastrów w trybie no-isolation shared,
- Databricks Runtime starszego niż 13.3 LTS.
Dla nas oznacza to, że workspace „UC-only” staje się standardem. Jeśli nasz kod, init scripty albo automatyzacja zakładają obecność którejś z tych rzeczy, przy następnym nowym środowisku coś się posypie.
Volumes zamiast DBFS
Volume to obiekt Unity Catalog przeznaczony na pliki (CSV, JSON, obrazy, modele, biblioteki). Ma ścieżkę w postaci /Volumes/<katalog>/<schemat>/<volume> i podlega tym samym zasadom co tabele: ma właściciela. Do utworzenia volume'u potrzebujemy USE CATALOG, USE SCHEMA i CREATE VOLUME. Do odczytu plików dochodzi READ VOLUME, a do zapisu także WRITE VOLUME.
| DBFS (legacy) | Volume w Unity Catalog | |
|---|---|---|
| Ścieżka | dbfs:/... (DBFS root), dbfs:/mnt/... |
/Volumes/katalog/schemat/volume (albo dbfs:/Volumes/...) |
| Governance | Brak, każdy użytkownik workspace'u widzi wszystko | Uprawnienia UC, audyt, lineage |
| Nowe workspace'y | Niedostępny | Domyślny |
| Status | Deprecated | Zalecany |
Zaczynamy od utworzenia volume'u.
✓ Sprawdzone na Free Edition (2026-10-17)
CREATE VOLUME IF NOT EXISTS <your_catalog>.default.landing
COMMENT 'Manually uploaded files';
Plik możemy wgrać przez Catalog Explorer: Catalog → nasz katalog → default → landing → Upload to this volume. Alternatywnie: New → Add or upload data → Upload files to a volume.
Potem czytamy go zwykłą ścieżką, bez mountu i bez klucza do storage'u. Najpierw dbutils.fs.ls pokazuje, jakie pliki są w volume, a potem read_files() czyta CSV z nagłówkiem.
✓ Sprawdzone na Free Edition (2026-10-17)
LANDING_PATH = "/Volumes/<your_catalog>/default/landing"

# What is in the volume? (same as LIST '/Volumes/...' in SQL)
for f in dbutils.fs.ls(LANDING_PATH):
    print(f"{f.name:<20} {f.size:>8,} bytes")

display(spark.sql(f"""
    SELECT *
    FROM read_files('{LANDING_PATH}/stores.csv', format => 'csv', header => true)
    LIMIT 5
"""))
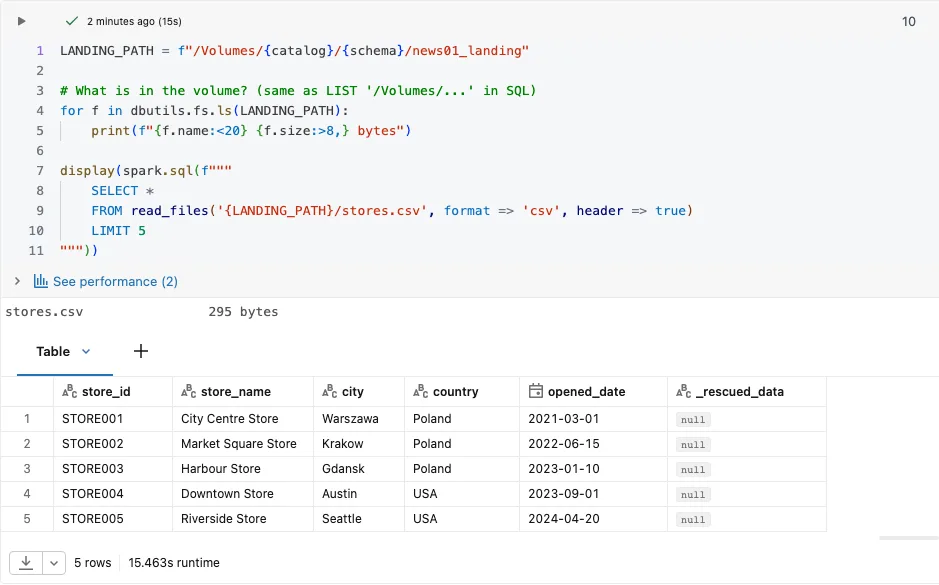
Dodatkowa kolumna _rescued_data to miejsce na wartości, które nie pasują do schematu; tutaj jest pusta. W notebooku z nagrania volume nazywa się news01_landing, tabela z dalszej części news01_stores, ścieżka ma nasz schemat zamiast default, a plik zapisuje dbutils.fs.put zamiast uploadu.
Volume możemy opisać tak samo jak tabelę. DESCRIBE VOLUME pokazuje m.in. właściciela, typ (MANAGED) i miejsce w storage'u (na Free Edition pole storage_location jest puste).
✓ Sprawdzone na Free Edition (2026-10-17)
SHOW VOLUMES IN <your_catalog>.default;
DESCRIBE VOLUME <your_catalog>.default.landing;
Jedna rzecz, o którą pada najwięcej pytań: plik w volume nie jest tabelą. read_files() i spark.read czytają go przy każdym zapytaniu od nowa. Jeśli chcemy pracować na danych jak na tabeli, ładujemy je do Delta. Przy jednym pliku wystarczy CREATE TABLE ... AS SELECT, przy plikach, które dochodzą co jakiś czas, lepszy jest Auto Loader.
✓ Sprawdzone na Free Edition (2026-10-17)
spark.sql(f"""
    CREATE OR REPLACE TABLE <your_catalog>.default.stores AS
    SELECT * FROM read_files('{LANDING_PATH}/stores.csv', format => 'csv', header => true)
""")
display(spark.sql("SELECT count(*) AS stores FROM <your_catalog>.default.stores"))
Zapytanie zwraca 5, czyli tyle, ile wierszy było w pliku. Od tej chwili stores jest zwykłą tabelą Delta w Unity Catalog, a plik w volume możemy podmienić albo usunąć, nie ruszając tabeli.
Checklista migracji: od czego zacząć
Pierwszą listę starych ścieżek daje zwykły grep po repozytorium:
✓ Działa lokalnie, bez Databricks (sprawdzone na małym repo testowym)
grep -rnE "dbfs:/|/dbfs/|/mnt/|dbutils\.fs\.mount|FileStore|%fs" .
Na małym repo testowym grep znalazł dbfs:/FileStore/... w spark.read, dbutils.fs.mount z /mnt/raw, pd.read_csv("/dbfs/tmp/..."), komórkę %fs ls /FileStore/... i destination: dbfs:/init/setup.sh w YAML-u joba, a pominął "/checkpoints/orders", czyli ścieżkę bez schematu (o tym niżej).
- Szukamy starych ścieżek w repo, notebookach i konfiguracji jobów, zaczynając od grepa powyżej. To inwentaryzacja, a wyniki najpierw klasyfikujemy, bo nie wszystko trzeba przepisać. Prefiks
dbfs:sam w sobie nie znika:dbfs:/Volumes/...,dbfs:/databricks-datasets/i ścieżki systemowe (np. MLflow) działają dalej także po wyłączeniu DBFS root i mountów. Migracji wymaga kod, który czyta albo zapisuje DBFS root (np.dbfs:/FileStore/,dbfs:/tmp/) i mounty (/mnt/...,dbfs:/mnt/...). Grep nie znajdzie natomiast ścieżek bez schematu: prefiksdbfs:jest opcjonalny, więc na starym workspace'ie"/tmp/..."albo"/checkpoints/..."w Sparku też oznacza DBFS root. Szczególnie sprawdzamycheckpointLocationischemaLocationw streamingu i Auto Loaderze. Nowy checkpoint oznacza, że stream zacznie od nowa, więc przy migracji ustalamy, od którego miejsca ma czytać. - Init scripty i biblioteki trzymane na DBFS przenosimy do Volumes albo do workspace files (w workspace'ie bez DBFS workspace files są też widoczne pod
dbfs:/Workspace/..., od DBR 13.3 LTS). Na compute w trybie Standard ścieżkę init scriptu albo JAR-a z volume'u trzeba jeszcze dodać do allowlisty metastore'u. DBFS bywa też wskazany jako miejsce zapisu w ustawieniach, których w kodzie nie widać: cluster log delivery, biblioteki klastra, eksperymenty MLflow i AutoML poza Unity Catalog. Domyślnie do DBFS root piszą pipeline'y Lakeflow na Hive Metastore bez ustawionegostorage(dbfs:/pipelines/). Taki pipeline trzyma tabele i checkpointy w DBFS root, więc nie przenosimy go zmianą ścieżki, tylko zakładamy od nowa z katalogiem Unity Catalog. - Mounty z kluczami storage'u zastępujemy przez Storage Credential (na Azure: Access Connector z managed identity) + External Location na ten sam kontener, a pliki rejestrujemy jako external volume na podścieżce (
CREATE EXTERNAL VOLUME ... LOCATION ...). Danych z mountów nie kopiujemy, kopiujemy tylko to, co leżało w DBFS root. Dostęp nadajemy grantami, sama znajomość ścieżki już nie wystarcza. Po przełączeniu kodu robimydbutils.fs.unmount, żeby stary mount nie omijał uprawnień ustawionych na External Location. Tej ścieżki nie sprawdzałem na labie: workspace testowy nie ma Storage Credentiala ani External Location na własnym kontenerze, więc kroki są z dokumentacji. - Tabele z Hive Metastore przenosimy do Unity Catalog (
SYNC, UCX albo HMS federation). To temat na osobny artykuł. Jedna uwaga:SYNCnie przeniesie tabel managed, które leżą w DBFS root (statusDBFS_ROOT_LOCATION). Takie tabele kopiujemy przezCREATE TABLE ... DEEP CLONE. Dostęp do Hive Metastore możemy też wyłączać stopniowo, klaster po klastrze:spark.databricks.unityCatalogOnlyMode truerazem zspark.databricks.sql.initial.catalog.namespace <your_catalog>, bo bezhive_metastoreklaster potrzebuje innego domyślnego katalogu. Na labie nie ma Hive Metastore, więcSYNC,DEEP CLONEiunityCatalogOnlyModeopisuję według dokumentacji. - Klastry no-isolation shared zamieniamy na tryby dostępu Standard albo Dedicated, a Databricks Runtime podnosimy co najmniej do 13.3 LTS.
- Automatyzacja tworzenia workspace'ów (Terraform, CI/CD): usuwamy zależności od DBFS i Hive Metastore oraz ustawiamy automatyczne przypisanie metastore'u (auto-assign) w każdym regionie, w którym tworzymy workspace'y. W IaC szukamy konkretnie:
init_scriptszdbfs, bibliotek zdbfs:/,artifact_pathw bundle'ach,spark_versionponiżej 13.3 idata_security_mode = NONEw jobach i politykach klastrów. -
Test „jak w nowym workspace'ie”: najprościej założyć nowy workspace testowy, bo od 8.10 i tak powstaje bez funkcji legacy. Na istniejącym workspace'ie testowym workspace admin przełącza w Settings → Workspace admin → Security dwa ustawienia: Disable DBFS root and mounts i wyłączenie dostępu do Hive Metastore (Disable legacy access), a w zakładce Compute trzecie: wymuszenie trybów z izolacją użytkowników (Enforce user isolation), bo klastry no-isolation shared nie respektują wyłączenia Hive Metastore. Ustawienie konta Disable legacy features jest od października 2026 wycofane: zostaje widoczne, ale włączone i zablokowane. Po wyłączeniu DBFS czekamy do 20 minut, po wyłączeniu Hive Metastore około 5 minut, a potem ręcznie restartujemy działające klastry all-purpose i SQL warehouse'y. Bez restartu dalej widzą DBFS i Hive Metastore, a test wychodzi dobrze, choć nie powinien. Samą procedurę przełączania opisuję na podstawie dokumentacji; nie sprawdzałem jej na labie, bo workspace labu powstaje już bez funkcji legacy.
Kod, który dalej czyta albo zapisuje DBFS root lub mounty, kończy się błędem, a komunikat w logach jobów zależy od API i compute. Na naszym labie (serverless, workspace bez funkcji legacy)
read_files('dbfs:/FileStore/...')zwraca[DBFS_DISABLED] Public DBFS root is disabled,spark.readidbutils.fs.lsnadbfs:/FileStore,dbfs:/tmpi/mntzwracają[INSUFFICIENT_PERMISSIONS] ... User does not have permission SELECT on any file(testowałem z konta bez admina),pd.read_csv("/dbfs/...")kończy sięFileNotFoundError, a zapytanie dohive_metastorezwracaUC_HIVE_METASTORE_DISABLED_EXCEPTION. Uwaga naINSUFFICIENT_PERMISSIONS ... SELECT on any file: to brak uprawnieniaANY FILE. Według dokumentacji tryb Standard wymagaANY FILEdo bezpośredniej pracy z plikami w DBFS, a na serverless dostęp do DBFS jest ograniczony, więc ten błąd możemy dostać także na starym workspace'ie. Wyłączony DBFS root potwierdza tylkoDBFS_DISABLED.Uwaga przy Hive Metastore: według dokumentacji po 30 dniach z wyłączonym dostępem workspace na stałe staje się UC-only i nie da się go już włączyć z powrotem, więc ten test robimy na workspace'ie, którego nie będziemy żałować.
Pułapki: kiedy migracja się komplikuje
- Pandas i lokalne API czytające
/dbfs/.... Pandas czyta plik z lokalnego systemu plików, bez Sparka. Na starym workspace'ie DBFS był widoczny pod/dbfs/..., a na nowym tego katalogu już nie ma, więc kod typupd.read_csv("/dbfs/FileStore/...")trzeba przepisać na ścieżkę/Volumes/.... W notebooku sprawdzamy obie ścieżki:
✓ Sprawdzone na Free Edition (2026-10-17)
import pandas as pd

# Old path through /dbfs: there is no DBFS root on this workspace
try:
    pd.read_csv("/dbfs/FileStore/stores.csv")
except Exception as e:
    print(type(e).__name__, e)

# New path: the volume
pdf = pd.read_csv(f"{LANDING_PATH}/stores.csv")
print(len(pdf), "rows")
Stara ścieżka kończy się FileNotFoundError [Errno 2] No such file or directory: '/dbfs/FileStore/stores.csv', a nowa zwraca 5 rows.
- Ścieżki zaszyte w bibliotekach i configach. Grep po repozytorium nie wystarczy, jeśli ścieżka siedzi w parametrach jobów, zmiennych środowiskowych klastra albo w konfiguracji narzędzia zewnętrznego. Dodatkowo warto przejrzeć definicje jobów i historię uruchomień. Na większym workspace'ie lepiej zacząć od narzędzi: dokumentacja poleca skrypty
dbfs-scannerz Databricks Labs (repodatabrickslabs/sandbox), które pokazują faktyczne użycie DBFS root i mountów, a workflow assessment z UCX zbiera mounty, init scripty, klastry no-isolation i tabele Hive Metastore w jednym raporcie. Oba to projekty Labs bez oficjalnego wsparcia. Na labie ich nie uruchomiłem, bo to workspace bez DBFS root i bez Hive Metastore, więc nie miałyby czego znaleźć. - Mounty dające dostęp „wszystkim”. Po przejściu na External Location nagle potrzebne są granty dla konkretnych grup. To dobra zmiana, ale bez planu pierwszego dnia po migracji dostaniemy serię
PERMISSION_DENIED. Granty nadajemy grupom konta. Jeśli dostęp na starym workspace'ie szedł przez grupy lokalne workspace'u, najpierw zamieniamy je na grupy konta (UCX ma do tego workflow), a dopiero potem nadajemyUSE CATALOG,USE SCHEMAiREAD VOLUME/WRITE VOLUME. - Metastore na Azure. W naszym Terraformie do środowisk testowych nie tworzymy metastore'u ręcznie, bo na Azure może powstać automatycznie. To jednak nie znaczy, że jest automatycznie przypisywany. Sprawdzamy w account console, czy ma włączone auto-assign w każdym regionie, w którym stawiamy workspace'y. Jeśli nie, Terraform musi mieć
databricks_metastore_assignment, a jeśli próbuje metastore tworzyć, przy istniejącym dostaniemy konflikt. Według dokumentacji Unity Catalog jest włączany automatycznie dla workspace'ów założonych na AWS po 08.11.2023, a na GCP po 06.03.2024. Na labie sprawdzałem tylko Azure. - Joby na klastrach no-isolation shared. Według dokumentacji po przeniesieniu do nowego workspace'u taki job nie wystartuje, bo tego trybu dostępu tam nie ma. Na labie tego nie sprawdzałem.
- DR i nowe środowiska obok starych. Jeśli plan disaster recovery zakłada postawienie nowego workspace'u i ponowne wdrożenie kodu, to od 8.10 ten workspace powstanie bez DBFS root, mountów i Hive Metastore. To samo dotyczy nowego dev/test obok starej produkcji: test przejdzie albo padnie z innych powodów niż na produkcji. Dlatego migrację najlepiej zacząć od środowisk, które tworzymy od zera.
Kiedy NIE panikować
Istniejący workspace działa dalej. Jeśli w najbliższym czasie nie tworzymy nowych workspace'ów, mamy czas na spokojną migrację. Warto ją jednak zaplanować teraz, a nie w dniu, w którym ktoś postawi nowe środowisko i okaże się, że połowa notebooków odwołuje się do /mnt/.
Jedno zastrzeżenie: według dokumentacji od lipca 2026 Databricks może stopniowo wyłączać bezpośredni dostęp do Hive Metastore w istniejących workspace'ach, które z niego nie korzystają. Dokumentacja nie mówi, po jakim czasie bez aktywności, ani czy takie automatyczne wyłączenie liczy się do 30 dni, po których workspace na stałe zostaje UC-only (punkt 7 checklisty). Ja zakładam, że tak, więc rzadkie joby (np. kwartalne) na Hive Metastore sprawdzam już teraz.
Jeśli nasze joby i notebooki już działają na serverless, w dużej mierze są gotowe: serverless ma ograniczony dostęp do DBFS i od początku wymaga Unity Catalog.
Nie każdy plik musi od razu trafić do Volume. Jednorazowy eksperyment na starym workspace'ie może po prostu tam zostać.
Zobacz, jak to działa
Na nagraniu cały notebook uruchomiony na serverless, na workspace'ie bez funkcji legacy, od błędów przy starych ścieżkach do sprzątania. Nagrywałem go 17.10, przed zmianą daty w dokumentacji, dlatego w filmie pada jeszcze 30 września.
Kod z tego artykułu na GitHubie →notebook i README krok po kroku · dbfs-september-30-2026
Podsumowanie
- Od 8.10.2026 nowe workspace'y powstają bez czterech funkcji legacy z listy wyżej, a konta Azure założone po 18.12.2025 nigdy ich nie miały. Istniejące workspace'y nie są objęte zmianą (poza tym, że od lipca 2026 Databricks może wyłączać nieużywany Hive Metastore), ale kod, który korzysta z DBFS root albo mountów, nie zadziała w nowym środowisku. Ścieżki
dbfs:/Volumes/...działają dalej. - Zaczynamy od inwentaryzacji (grep, ścieżki bez schematu,
dbfs-scanner), klasyfikujemy wyniki i przenosimy pliki z DBFS root do Volumes. Dane z mountów rejestrujemy jako external volume, bez kopiowania. - Testujemy na nowym workspace'ie albo na istniejącym z wyłączonymi funkcjami legacy (punkt 7 checklisty) i ustawiamy auto-assign metastore'u w każdym regionie.
Chcesz kolejne wpisy? Obserwuj przez RSS albo na LinkedInie.
Komentarze
Na razie cisza na szlaku. Napisz pierwszy komentarz.