
 Krzysztof Burejza
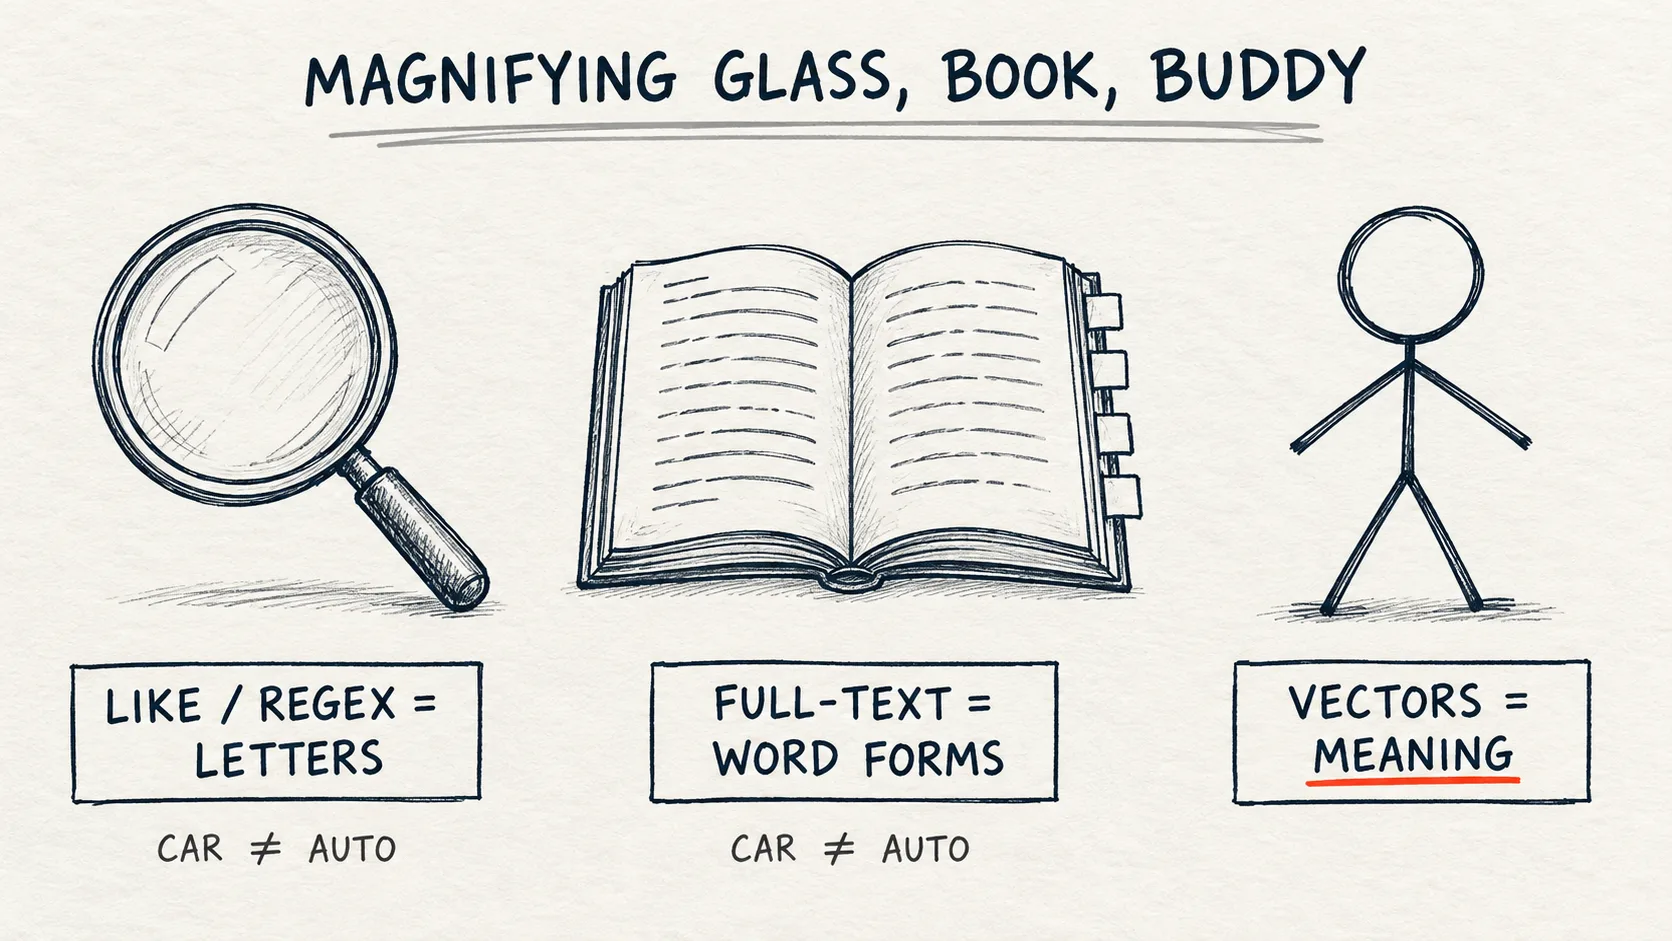
LIKE i regex patrzą na litery, full-text search zna odmiany słów, a wyszukiwanie wektorowe porównuje znaczenie. Na 12 krótkich artykułach o kawie zapytanie ILIKE '%parzyć%' nie znajduje nic, bo w tekstach są tylko „parzenie”, „parzenia” i „parzona”. Funkcja isearch trafia całe słowo, ale też tylko w jednej formie, a dopiero porównanie znaczeń (ai_similarity) wciąga do wyników artykuły dla baristy, choć nie wszystkie i nie zawsze na górę. Tekst dla osób, które piszą WHERE na co dzień i chcą wiedzieć, kiedy wystarczy lupa, a kiedy trzeba zadzwonić do kumpla.Problem
W tekście „SQL nie umiera, tylko mutuje” pisałem o tym, jak SQL się zmienia. Najlepiej widać to na wyszukiwaniu tekstu, bo tu przez ostatnie lata zmieniło się najwięcej.
Przykład z moich prelekcji: mamy bazę 60 artykułów o kawie. Cztery z nich (ID 1–4) to teksty dla profesjonalnego baristy: profilowanie ciśnienia, chemia wody, dystrybucja kawy w kolbie, refraktometr i procent ekstrakcji. Pozostałe 56 to szum: historia kawy, przepisy, regiony uprawy. Barista wpisuje pytanie: „Jak prawidłowo parzyć kawę?”.
Tytuły artykułów, których szuka, brzmią na przykład „Zaawansowana ekstrakcja: Profilowanie ciśnienia i Flow Control”. Nie ma w nich ani „parzyć”, ani „kawę”. Człowiek od razu widzi, że to o tym samym. Zapytanie SQL nie widzi.
Poprawka do samego siebie: na slajdzie „Porażka w praktyce” pokazywałem wyniki w stylu „247 artykułów, większość nieistotnych”. To były liczby ilustracyjne, a zbiór demo miał 60 wierszy. Poniżej pokazuję ten sam problem na Databricks, na 12 syntetycznych artykułach, z wynikami z labu.
Jak to działa
Na prelekcji o SQL i AI użyłem analogii, która na sali działała lepiej niż jakakolwiek definicja. Szukamy informacji o „pojazdach spalinowych”.
- LIKE i regex to lupa. Patrzymy na każdą literę. Znajdziemy „pojazd”, ale nie „samochód”, „auto” ani „car”. Widzimy znaki, nie sens.
- Full-text to książka z indeksem. Mamy alfabetyczny spis haseł, który zna odmiany, więc znajdziemy „pojazd” i „pojazdy”. „Samochód” to jednak inne hasło w indeksie. Musimy wiedzieć, czego szukać.
- Wektory to kumpel, co kuma. Mówimy „coś o tych czterech kółkach z silnikiem”, a kumpel odpowiada: „Aha, chodzi Ci o samochody”. Rozumie intencję, nawet jeśli użyjemy innych słów.
Pierwsze dwa to wyszukiwanie składniowe (syntactic search), trzecie to wyszukiwanie semantyczne (semantic search).
| Metoda | Jak działa | Zalety | Wady | Kiedy |
|---|---|---|---|---|
| LIKE | dopasowanie wzorca %...% |
proste, bez konfiguracji | literalne, % z przodu wyklucza wyszukiwanie zakresowe w zwykłym indeksie B-tree |
filtry na małych tabelach |
| Regex | wzorce, np. ^[A-Z]{2}\d{4}$ |
precyzja | łatwo o błąd, wolne | walidacja, kody, e-maile |
| Full-text | indeks, stemming, ranking | szybkie, zna odmiany | synonimy tylko przez thesaurus, który trzeba skonfigurować i utrzymywać | wyszukiwarki po słowach |
| Wektory | embeddingi i najbliżsi sąsiedzi | rozumie znaczenie i synonimy | wymaga modelu i zasobów | wyszukiwanie po intencji |
Krok po kroku
Lupa: LIKE
Lupę sprawdzimy na Databricks w SQL bez żadnej konfiguracji. Notebook do artykułu (magnifying_glass_book_buddy.sql) nie potrzebuje żadnych plików: generuje 12 krótkich, syntetycznych artykułów o kawie, z czego ID 1–4 to znowu teksty dla profesjonalnego baristy, a pozostałe 8 to szum. Pierwsze komórki notebooka ustawiają widżety, wykonują USE catalog.schema i tworzą tabelę coffee_articles z 12 wierszami. Bez nich zapytania niżej zwrócą TABLE_OR_VIEW_NOT_FOUND.
✓ Sprawdzone na Free Edition (2026-10-17)
SELECT id, title
FROM coffee_articles
WHERE body ILIKE '%parzyć%' OR title ILIKE '%parzyć%';
LIKE porównuje tekst ze wzorcem, a % oznacza dowolny ciąg znaków. ILIKE to LIKE, które nie rozróżnia wielkości liter. Zapytanie szuka „parzyć” w treści albo w tytule i zwraca 0 wierszy, tak samo jak pełny wzorzec '%jak%prawidłowo%parzyć%kawę%'. W treściach są „parzenie”, „parzenia” i „parzona”, ale nie „parzyć”. Tak samo jest z odmianą słowa „kawa”: title ILIKE '%kawa%' trafia 1 tytuł z 12, a title RLIKE '(?i)kaw(a|y|ę|owe)', czyli regex z listą form słowa, 4 tytuły.
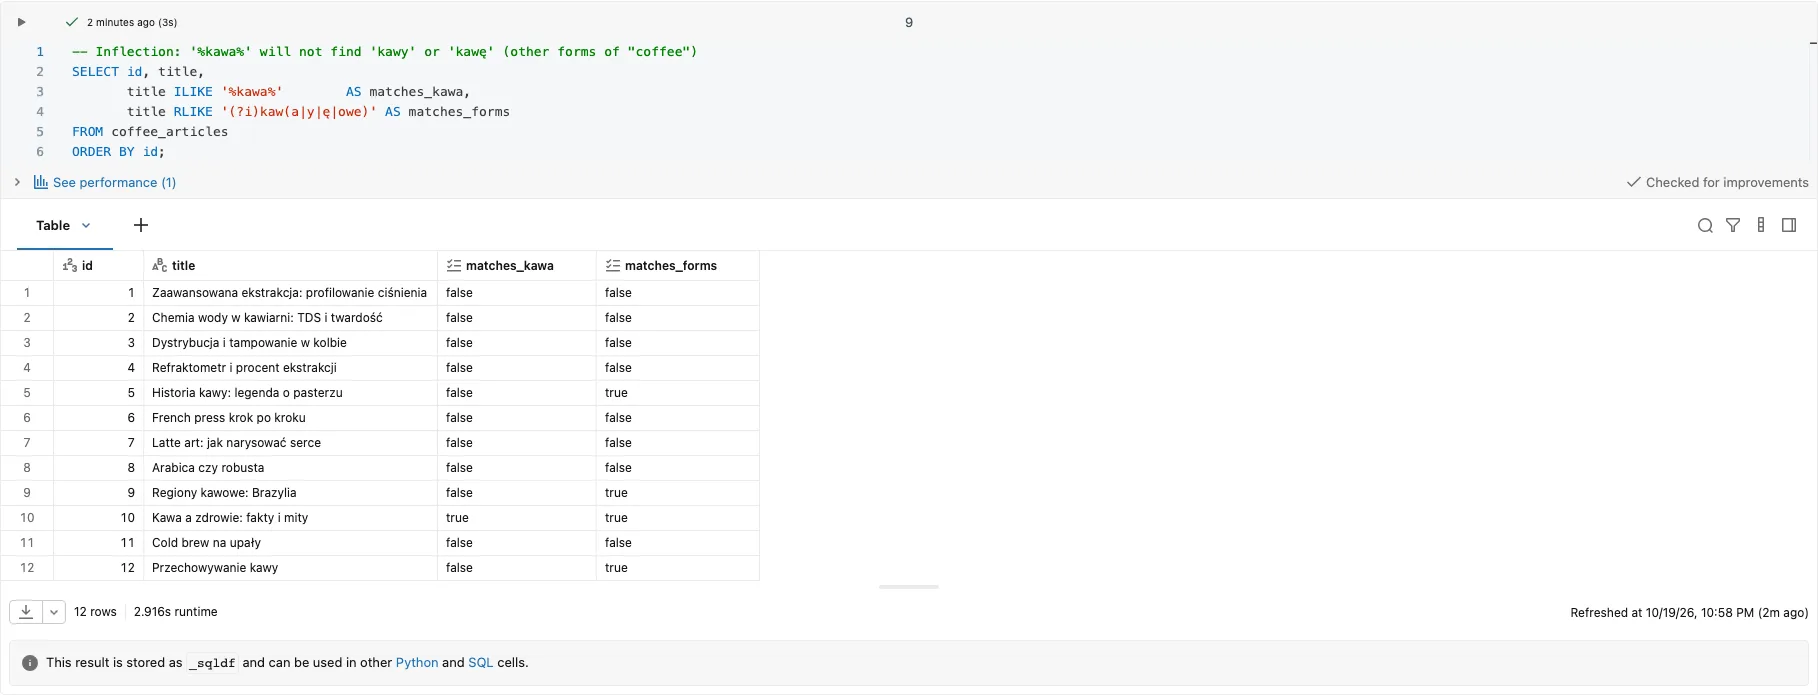
Wynik z labu: żaden z artykułów dla baristy (ID 1–4) nie ma „kawy” w tytule w żadnej formie.
Lupa z lepszym szkłem: regex
Regex pozwala szukać całych słów i list wariantów:
✓ Sprawdzone na Free Edition (2026-10-17)
SELECT id, title,
       regexp_extract(body, '(?i)(espresso|aeropress|french press|chemex|v60|moka)', 1) AS first_method
FROM coffee_articles
WHERE body RLIKE '(?i)(espresso|aeropress|french press|chemex|v60|moka)';
(?i) na początku wzorca wyłącza rozróżnianie wielkości liter, a | znaczy „albo”. RLIKE w WHERE zostawia wiersze, w których pasuje którakolwiek z metod parzenia, a regexp_extract z numerem grupy 1 pokazuje, który wariant trafił jako pierwszy. Wynik to 5 artykułów: w czterech pierwszym trafieniem jest „espresso”, w jednym „French press”.
W skrypcie demo do prelekcji miałem też wzorzec, który wyglądał rozsądnie, a pasował do wszystkiego: (jak|prawidlowo|parzyc|kawe|). Ostatni znak | przed nawiasem dodaje pustą alternatywę, a pusty ciąg pasuje do każdego tekstu.
Na Databricks sprawdzamy ten wzorzec przez RLIKE. W notebooku liczymy to funkcją count_if, która zlicza wiersze spełniające warunek: na 12 syntetycznych artykułach wzorzec z pustą alternatywą trafia 12 z 12 wierszy, a bez niej 0. Treści tych krótkich artykułów nie zawierają żadnego z tych czterech słów w zapisie bez ogonków, więc bez pustej alternatywy wzorzec nie trafia niczego.
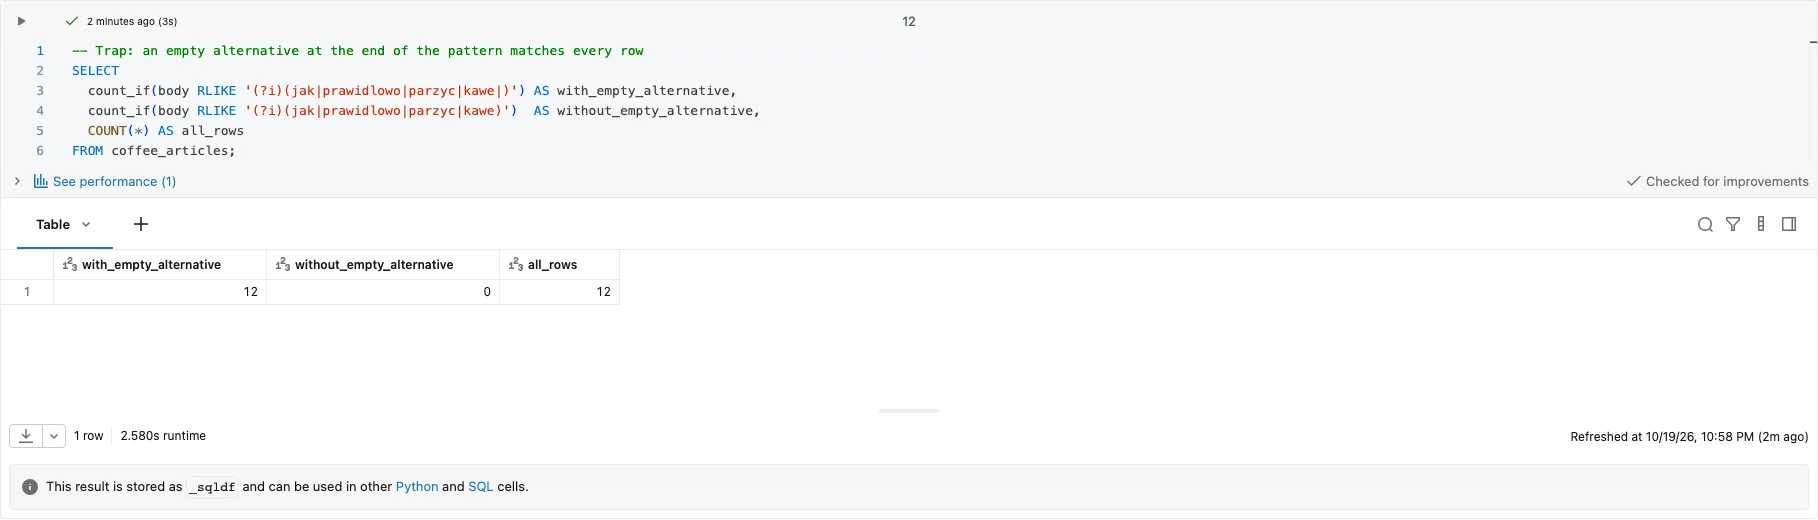
Wynik z labu: count_if dla obu wzorców; Databricks nie zgłasza błędu ani ostrzeżenia.
Książka: full-text search
W klasycznych bazach „książką” jest indeks pełnotekstowy: rozbija tekst na słowa, zna ich odmiany i daje ranking trafności.
W Databricks SQL nie ma takiego indeksu z odmianą i rankingiem. Są funkcje search (rozróżnia wielkość liter) i isearch (nie rozróżnia), w Becie, od DBR 19.0. Dopasowują podciąg albo, z mode => 'word', całe słowo:
✓ Sprawdzone na Free Edition (2026-10-17)
SELECT id, title
FROM coffee_articles
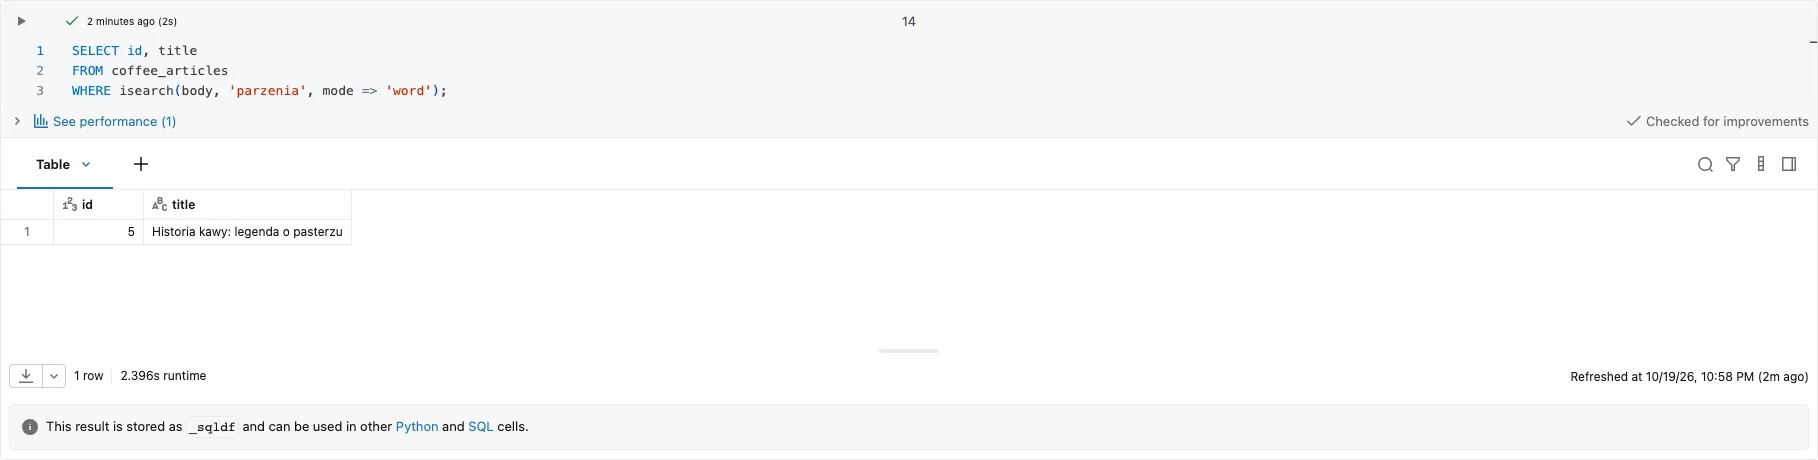
WHERE isearch(body, 'parzenia', mode => 'word');
Zapytanie zwraca jeden wiersz, „Historia kawy” (ID 5), bo tylko tam pada słowo „parzenia”. Artykuł o chemii wody ma „parzenie”, a cold brew „parzona”, więc ich nie ma: funkcja zna całe słowa, ale nie ich odmianę, i nie daje rankingu. Bez mode => 'word' szuka podciągu, więc isearch(body, 'parz') trafia wszystkie trzy. isearch działało u nas na serverless i na SQL warehouse typu Serverless, choć przełącznik dla CREATE SEARCH INDEX na stronie Previews jest wyłączony.
Do tych funkcji jest CREATE SEARCH INDEX (Beta, DBR 18.3+; w dokumentacji sprawdzonej 16.10.2026 było 18.2+), tylko że to przyspieszacz, a nie wyszukiwarka: wyników nie zmienia, pozwala jedynie pominąć pliki, w których wzorca na pewno nie ma. Ten indeks admin musi najpierw włączyć na stronie Previews, osobno w każdym workspace'ie, więc przy dev, test i prod robimy to trzy razy. Samo włączenie Preview nie wystarczy: tabela musi być managed oraz mieć row tracking i predictive optimization. Przy maskach, row filters i ABAC Databricks ignoruje indeks: zapytanie działa, ale bez przyspieszenia. Uwaga na sprzeczność z radą z „Pułapek”: indeksowana kolumna STRING musi mieć collation UTF8_BINARY, więc jeśli podmienimy collation na UNICODE_CI_AI, żeby dopasowywać bez ogonków, stracimy możliwość założenia na tej kolumnie indeksu. U nas, przy wyłączonym przełączniku, CREATE SEARCH INDEX kończy się błędem [INVALID_STATEMENT_OR_CLAUSE] The statement or clause: CREATE SEARCH INDEX is not valid. Pełniejsze wyszukiwanie pełnotekstowe daje AI Search w trybie FULL_TEXT (Beta, też przez Previews) albo HYBRID, ale automatyczne wykrywanie języka w AI Search nie obejmuje polskiego. Dodatkowo funkcja SQL vector_search() przyjmuje tylko ANN i HYBRID: query_type => 'FULL_TEXT' kończy się błędem [AI_SEARCH_QUERY_TYPE_UNSUPPORTED_ERROR] ... Please specify one from: [ANN, HYBRID].
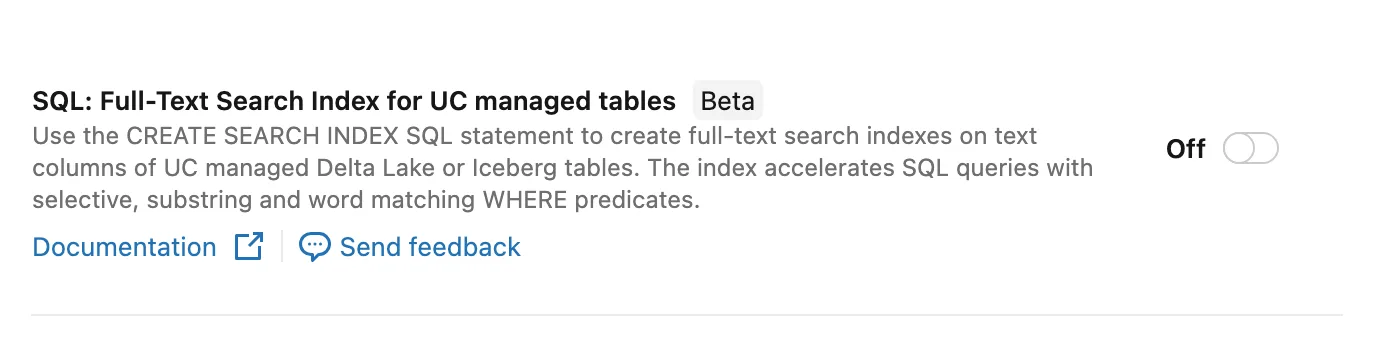
Strona Previews w workspace'ie (14.10.2026): CREATE SEARCH INDEX jest domyślnie wyłączony.
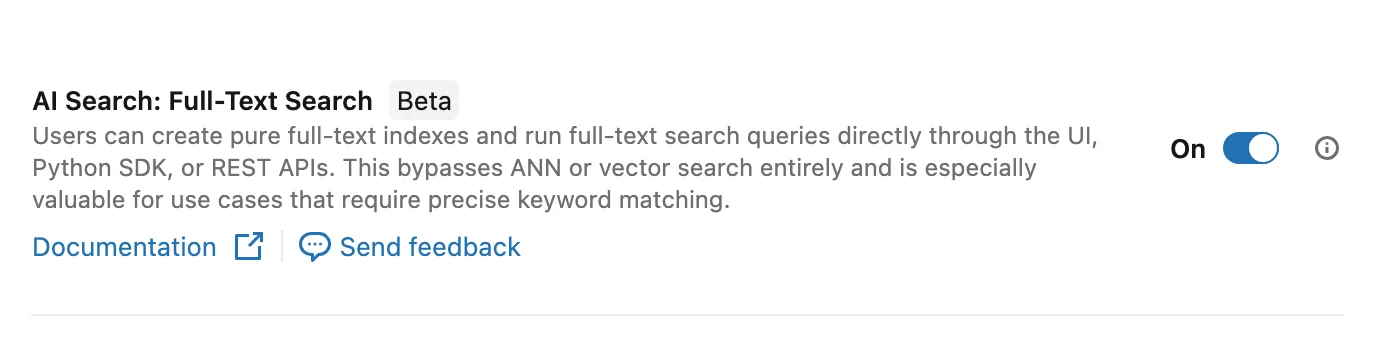
Strona Previews w workspace'ie (14.10.2026): tryb FULL_TEXT w AI Search.
Kumpel: podobieństwo znaczenia
Najprostszy sposób, żeby na Databricks zobaczyć „kumpla” w akcji, to funkcja ai_similarity. Porównuje dwa teksty i zwraca wynik podobieństwa, bez indeksu i bez własnego modelu. Funkcja jest w Public Preview i nie działa na SQL warehouse typu Classic. To jeszcze nie jest wyszukiwanie wektorowe, tylko najprostszy sposób, żeby zobaczyć porównanie znaczeń bez żadnej konfiguracji.
✓ Sprawdzone na Free Edition (2026-10-17)
SELECT id, title,
       ai_similarity(body, 'Jak prawidłowo parzyć kawę?') AS score
FROM coffee_articles
ORDER BY score DESC
LIMIT 5;
Zapytanie liczy wynik dla każdego z 12 artykułów, sortuje od największego i zostawia pięć. Kumpel nie wypadł tu tak dobrze, jak w analogii. Dla pytania „Jak prawidłowo parzyć kawę?” pierwsze miejsca zajęły „Historia kawy” (0,679), „Regiony kawowe: Brazylia” (0,671) i „Cold brew na upały” (0,628). Z czterech artykułów dla baristy w pierwszej piątce znalazła się tylko „Chemia wody w kawiarni” (ID 2, czwarte miejsce, 0,626).
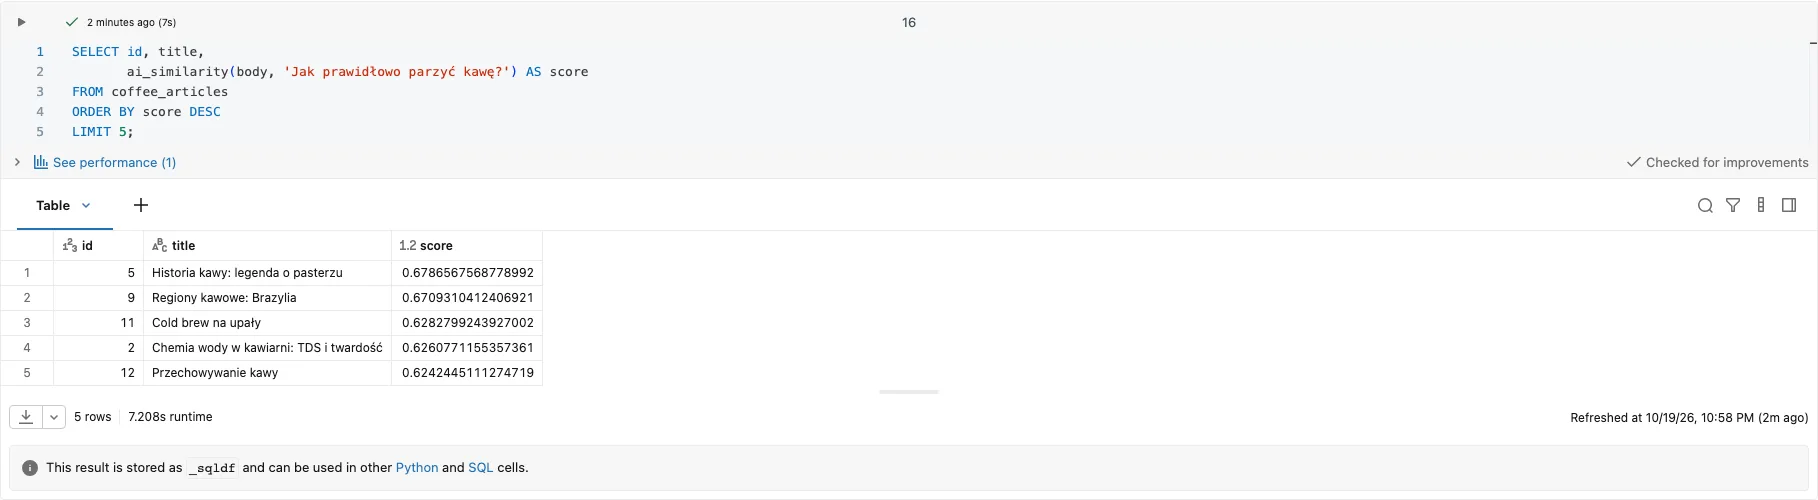
Wynik z labu: ranking dla dosłownego pytania baristy.
Dopiero gdy pytanie opisało intencję wprost, 'Profesjonalne techniki parzenia kawy dla zaawansowanych baristów', w pierwszej piątce pojawiły się trzy artykuły dla baristy (ID 1, 2 i 3). Na pierwszym miejscu dalej jednak była Brazylia (0,695).
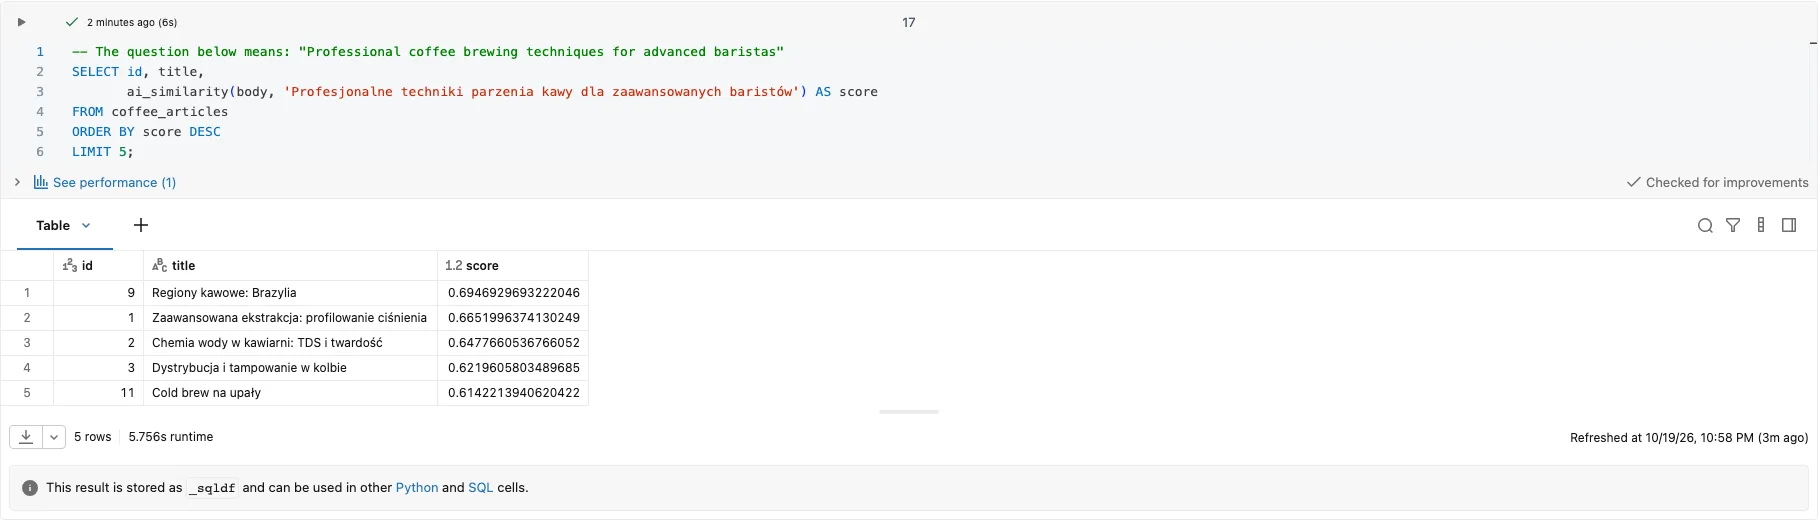
Wynik z labu: ranking dla pytania, które opisuje intencję.
Wniosek jest dla mnie taki, że kumpel rozumie więcej niż lupa, jednak na krótkich polskich tekstach i przy jednym zdaniu pytania nie jest wyrocznią. Wynik zależy od modelu i od tego, jak sformułujemy pytanie, więc ranking warto sprawdzić na własnych przykładach, zanim na nim coś zbudujemy. Dodatkowo dokumentacja zastrzega, że wynik ai_similarity jest względny i służy tylko do rankingu, a model pod funkcją wybiera Databricks i może go zmienić. Patrzę więc na kolejność, a nie na same liczby, i u Ciebie liczby mogą wyjść inne. Z tego samego powodu nie budujmy na tym wyniku progów (score > 0.65) ani testów z oczekiwaną kolejnością.
Na małej tabeli to wystarczy. Przy tysiącach dokumentów to podejście przestaje mieć sens czasowo i kosztowo, bo ai_similarity woła model dla każdego wiersza przy każdym pytaniu. Wtedy potrzebujemy embeddingów policzonych raz i odświeżanych przyrostowo oraz indeksu AI Search, a dla polskich tekstów modelu wielojęzycznego (np. Qwen3-Embedding-0.6B, endpoint databricks-qwen3-embedding-0-6b, na dziś w Public Preview, zamiast angielskiego GTE Large (En)). Model wybieramy przed zbudowaniem indeksu, bo jego zmiana oznacza przeliczenie wszystkich embeddingów.
Na takim indeksie vector_search() z query_type => 'HYBRID' łączy książkę z kumplem: wyszukiwanie wektorowe (ANN) i pełnotekstowe idą równolegle, a wyniki łączy Reciprocal Rank Fusion (RRF). Część słowna nie ma jednak analizatora dla polskiego, więc na odmianę słów bym tu nie liczył. Jak zbudować taki indeks i odpytać go przez vector_search() krok po kroku (endpoint, indeks Delta Sync, zapytanie i sprzątanie), pokazuję w tekście „SQL nie umiera, tylko mutuje”. Tamten notebook używa angielskiego modelu databricks-gte-large-en i zwykłego zapytania bez query_type, czyli domyślnego ANN. Dla polskich tekstów podmieniamy model na databricks-qwen3-embedding-0-6b i dopisujemy query_type => 'HYBRID'.
Według dokumentacji migracji na Unity Gateway admin workspace'u włącza ustawienie Enforce Unity Gateway w Settings > Advanced; dopóki tego nie zrobi, dotychczasowe konfiguracje legacy działają bez zmian. Samo ustawienie jest dostępne w workspace'ach z endpointami legacy AI Gateway, a gdy go tam nie widać, dokumentacja każe zgłosić się do account teamu po zakończeniu i zweryfikowaniu migracji (stan na 3.11.2026). Przy włączonym enforcement ta sama dokumentacja podaje, że tworzenie endpointów AI Search przez Unity Gateway nie jest jeszcze wspierane, a modele databricks-* w trybie pay-per-token są wyłączone. U nas, na workspace'ie labowym i na Free Edition, enforcement był wyłączony i przy takim ustawieniu notebook z tamtego tekstu tworzy endpoint i indeks bez błędu. Z włączonym tego nie sprawdzałem, więc na swoim workspace'ie warto zajrzeć do tego ustawienia przed planowaniem indeksu.
Pułapki
- Collation i ogonki. Wynik
LIKEzależy od collation kolumny, czyli od reguł porównywania tekstu. Na DatabricksLIKE,ILIKEiRLIKEdziałają tylko z collationUTF8_BINARYiUTF8_LCASE, które rozróżniają ogonki. Z innym collation dostajemy błąd:body COLLATE UNICODE_CI_AI ILIKE '%parzyc%'kończy się[DATATYPE_MISMATCH.UNEXPECTED_INPUT_TYPE] ... The first parameter requires the "STRING" type. Dopasowanie bez ogonków i bez wielkości liter daje funkcjacontains(collation od DBR 16.1):contains(body COLLATE UNICODE_CI_AI, 'cisnienia')trafia artykuł o profilowaniu ciśnienia (ID 1), acontains(body, 'cisnienia')ibody ILIKE '%cisnienia%'nie trafiają niczego. - Pusta alternatywa w regexie.
(a|b|)pasuje do wszystkiego. Taki błąd nie rzuca wyjątkiem, tylko zwraca całą tabelę. %na początku wzorca.LIKE '%kawa%'nie skorzysta z wyszukiwania zakresowego (seek) w zwykłym indeksie B-tree, więc na dużej tabeli to zwykle pełny skan. Są indeksy, które to obsługują, np. trigramowe w PostgreSQL (pg_trgm).- Full-text bez skonfigurowanego thesaurusa. Indeks zna „pojazd” i „pojazdy”, ale „samochód” to dla niego inne słowo, dopóki nie dopiszemy synonimów. Słownik synonimów (thesaurus) trzeba skonfigurować i utrzymywać ręcznie.
- Wektory zawsze coś zwrócą. Wyszukiwanie wektorowe zwraca najbliższych sąsiadów, nawet jeśli pytanie nie ma nic wspólnego z danymi. Pytanie o Bielsko-Białą w bazie o kawie też dostanie „najlepsze” pięć artykułów.
(?i)i polskie litery. W regexie(?i)ignoruje wielkość liter tylko dla liter ASCII:'KAWĘ' RLIKE '(?i)kawę'zwracafalse, a'KAWĘ' RLIKE '(?iu)kawę'i'KAWĘ' ILIKE '%kawę%'zwracajątrue. Przy polskich tekstach piszmy(?iu). W demo(?i)wystarcza, bo w słowach, które dopasowujemy, wielkie są tylko zwykłe litery bez ogonków („Kawa”, „French press”), a litery z ogonkami są zawsze małe.- Model a język. Według dokumentacji
ai_similarityjest dostrojona do angielskiego. U nas dla obu pytań wysoko był artykuł o Brazylii, który z parzeniem nie ma nic wspólnego. Wynik jest względny i nadaje się tylko do rankingu. Przy polskich tekstach warto przetestować model na własnych przykładach. ai_similaritydziała tylko w regionach, które obsługują AI Functions optimized for batch inference. Zanim zbudujemy na niej demo, sprawdzamy listę regionów.- Pierwsze wywołanie potrafi długo trwać. Przy jednym z przebiegów na serverless pierwsze
ai_similarityna 12 wierszach czekało 4 min 21 s, a drugie zapytanie około 5 s. W kolejnych przebiegach pierwsze wywołanie trwało od około 5 do 8 s, więc czas zależy od tego, czy model jest akurat „rozgrzany”. Przed demo warto funkcję wywołać raz wcześniej, a w jobie uwzględnić to w timeoucie. Do tego każde zapytanie to wywołanie modelu dla każdego wiersza, więc na dużej tabeli liczymy też koszt, nie tylko czas.
Kiedy NIE używać
- Wektorów do kodów, e-maili, numerów. Jeśli znamy wzorzec (
^[A-Z]{2}\d{4}$), regex da wynik deterministyczny i tani. Kumpel „mniej więcej” do numeru faktury to zły pomysł. - LIKE do pytań o znaczenie. Dołożenie kolejnych
OR LIKEz synonimami szybko robi się nieutrzymywalne. - Full-text, gdy nie mamy go jak utrzymać. Indeks pełnotekstowy to kolejny obiekt do administrowania. Na małej tabeli czasem wystarczy
ILIKE.
Zobacz, jak to działa
Na nagraniu cały notebook z labu, od ILIKE do ai_similarity i sprzątania.
Kod z tego artykułu na GitHubie →notebook i README krok po kroku · magnifying-glass-book-and-buddy
Podsumowanie
- Lupa (
LIKE, regex) widzi litery, książka (full-text) widzi słowa i ich odmiany, kumpel (wektory) widzi znaczenie. - Na 12 artykułach z demo
ILIKE '%parzyć%'zwraca 0 wierszy, a'%kawa%'trafia 1 tytuł z 4, w których pada jakaś forma słowa „kawa”.isearchzna całe słowa, ale też nie zna odmiany. - Regex z pustą alternatywą dopasowuje wszystko. Sprawdzajmy liczbę trafień, zanim uwierzymy w wynik.
ai_similaritypostawiło dla dosłownego pytania tylko jeden z czterech artykułów dla baristy w pierwszej piątce. Kumpel też potrzebuje dobrze zadanego pytania i sprawdzenia na własnych danych.
Chcesz kolejne wpisy? Obserwuj przez RSS albo na LinkedInie.
Komentarze
Na razie cisza na szlaku. Napisz pierwszy komentarz.