
 Krzysztof Burejza
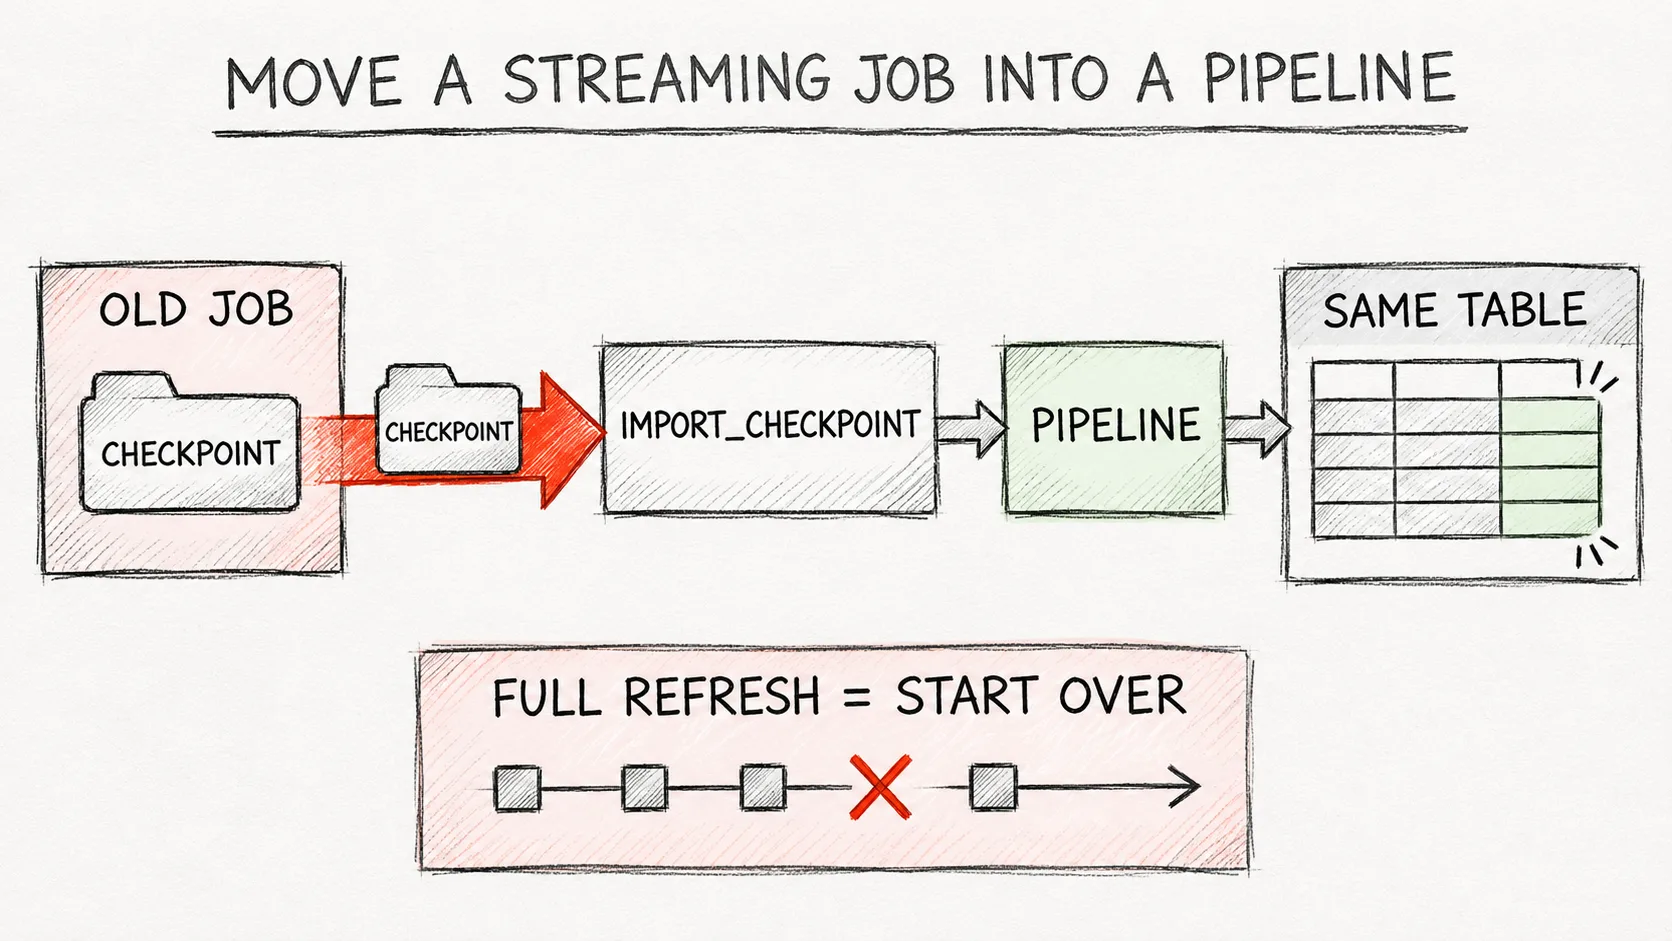
import_checkpoint (Beta, od 10.09.2026) przenosi zapytanie Structured Streaming do Lakeflow pipeline’u razem z offsetami i stanem, więc pipeline nie przetwarza źródła od początku. Na labie pipeline przejął też tabelę starego joba, a deduplikacja pamiętała klucze sprzed migracji. Full refresh zaczyna jednak od pustego checkpointu i czyta źródło od nowa, więc przy źródle z krótką retencją historia znika z tabeli.Problem
W wielu projektach mamy joby Structured Streaming, które działają od lat: readStream, kilka transformacji, writeStream z checkpointem. Przeniesienie takiego joba do Lakeflow pipeline'u (w dokumentacji: Spark Declarative Pipelines on Lakeflow) zwykle oznaczało nową streaming table i przetworzenie źródła od początku. Przy Kafce z retencją 7 dni część danych już tam nie ma, a przy dużej tabeli Delta pełne przeliczenie kosztuje.
We wrześniu w Becie doszły dwie rzeczy, które to zmieniają: dp.create_table(), czyli zwykła tabela zarządzana w pipeline'ie, oraz parametr import_checkpoint w @dp.append_flow, który wskazuje checkpoint starego zapytania. Pozostałe wrześniowe zmiany w Lakeflow opisałem w Lakeflow, wrzesień 2026: usunięcie pipeline'u zostawia tabele, a tutaj sprawdzam import checkpointu na zapytaniu ze stanem.
Jak to działa
dp.create_table() tworzy w pipeline'ie tabelę zarządzaną (nie streaming table), do której piszą jeden lub więcej flow @dp.append_flow. W SQL odpowiednikiem jest CREATE TABLE ... FLOW. Moduł w 2026 roku to from pyspark import pipelines as dp.
import_checkpoint wskazuje checkpointLocation, którego używało stare zapytanie (ścieżka w chmurze, wolumen UC albo DBFS). Według dokumentacji przy pierwszej aktualizacji pipeline klonuje ten checkpoint do swojego storage'u i wznawia od ostatniego zatwierdzonego offsetu, razem ze stanem (agregacje, klucze deduplikacji, watermarki). Oryginalny checkpoint zostaje nietknięty, więc do starego joba można wrócić.
Warto tutaj dodać, że dokumentacja zmieniła się 2 listopada. Wcześniej flow musiał pisać do nowej tabeli, a teraz przykład ma komentarz „Use the existing table your Structured Streaming query writes to; create_table adopts it”. Na labie sprawdziłem właśnie ten wariant: pipeline dostaje tę samą tabelę, do której pisał stary job.
Ograniczenia z dokumentacji:
- Checkpoint importuje się tylko raz, przy pierwszej aktualizacji. Żeby zaimportować inny checkpoint, potrzebna jest nowa nazwa flow, bo sama zmiana ścieżki w istniejącym flow nic nie robi i nie zgłasza błędu.
- Full refresh nie importuje checkpointu ponownie. Startuje od pustego checkpointu i przetwarza źródło od początku.
import_checkpointdziała tylko zappend_flow, a tabele zcreate_tablenie obsługują AUTO CDC.- Stare zapytanie trzeba zatrzymać, zanim uruchomimy pipeline. Jeśli oba będą pisać równolegle, te same offsety przetworzą oba i dostaniemy duplikaty.
Źródło i zapytanie zostawiamy te same. Przy zapytaniach ze stanem obowiązują zwykłe reguły checkpointu Structured Streaming: dokumentacja nie dopuszcza zmian operacji stanowych między restartami, a dropDuplicates() może nie wystartować po zmianie trybu dostępu compute (dozwolone są pary dedicated ↔ no isolation i standard ↔ serverless). Że te reguły dotyczą też import_checkpoint, to mój wniosek, bo pipeline wznawia sklonowany checkpoint razem ze stanem. Na labie stary job działał na serverless, tak jak pipeline.
Krok po kroku
Notebook tworzy tabelę źródłową ckpt_source z 5 zamówieniami i wolumen na checkpoint (CKPT). api to WorkspaceClient().api_client, ORDERS to SELECT z tabeli ckpt_orders posortowany po id, a wait czeka na koniec aktualizacji pipeline'u.
Najpierw stary job: zwykłe zapytanie Structured Streaming z deduplikacją po id, uruchomione raz (availableNow). Potem do źródła trafiają 4 zamówienia: 3 nowe i jeszcze raz id 3.
ⓘ Według dokumentacji działa na Free Edition, nie sprawdzałem.
(spark.readStream.table("ckpt_source")
    .dropDuplicates(["id"])
    .writeStream
    .option("checkpointLocation", CKPT)
    .trigger(availableNow=True)
    .toTable("ckpt_orders")
    .awaitTermination())
spark.sql("INSERT INTO ckpt_source VALUES (3, 'DE', 200.00), (6, 'PL', 10.00), (7, 'CZ', 20.00), (8, 'DE', 30.00)")
display(spark.sql(ORDERS))
ckpt_orders ma 5 wierszy o id 1–5. Teraz pipeline. Kod zapisujemy do pliku w workspace'ie: dp.create_table wskazuje tabelę starego joba, import_checkpoint jego checkpoint, a zapytanie jest to samo:
◆ Wymaga pełnego workspace'u (Premium), funkcja w Becie.
migration_code = f'''
from pyspark import pipelines as dp

dp.create_table("ckpt_orders")

@dp.append_flow(target="ckpt_orders", import_checkpoint="{CKPT}")
def migrate_orders():
    return spark.readStream.table("ckpt_source").dropDuplicates(["id"])
'''
path = f"{SRC}/news104_ckpt.py"
api.do("POST", "/api/2.0/workspace/import", body={"path": path, "format": "AUTO", "overwrite": True,
                                                  "content": base64.b64encode(migration_code.encode()).decode()})
pid = api.do("POST", "/api/2.0/pipelines", body={"name": "news104_ckpt", "catalog": catalog, "schema": schema,
    "serverless": True, "development": True, "libraries": [{"file": {"path": path}}]})["pipeline_id"]
print("news104_ckpt:", wait(pid, api.do("POST", f"/api/2.0/pipelines/{pid}/updates", body={})["update_id"]))
display(spark.sql(ORDERS))
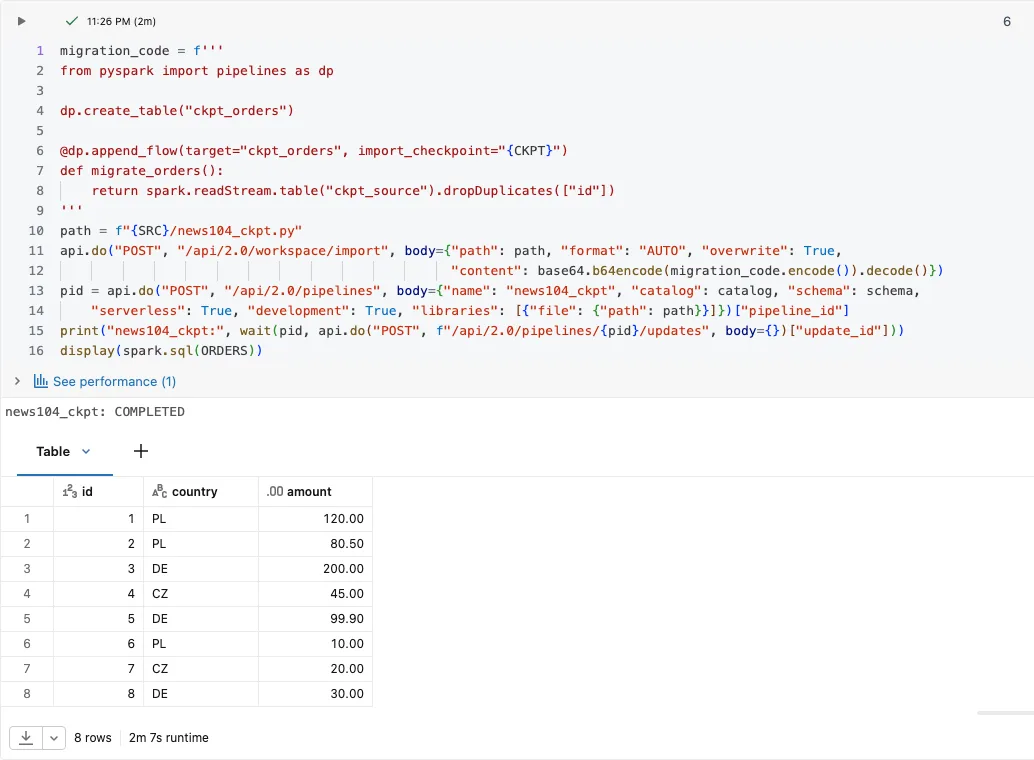
Wynik z labu: aktualizacja kończy się stanem COMPLETED, a ckpt_orders ma 8 wierszy: 5 starych i 3 nowe. Id 3 występuje raz, czyli pipeline pamiętał klucze deduplikacji ze starego checkpointu. Gdyby stan nie przeszedł, id 3 byłoby w tabeli dwa razy, a gdyby nie przeszły offsety, pipeline przeczytałby źródło od początku. W Catalog Explorer tabela starego joba pokazuje w trakcie aktualizacji status pipeline'u, a w pipeline'ie flow ma 3 rekordy wyjściowe: z 4 nowych wierszy odpadło powtórzone id 3.
Ostatni krok sprawdza full refresh. Źródła takie jak Kafka trzymają dane tylko przez jakiś czas, więc symulujemy to, usuwając stare zamówienia ze źródła:
◆ Wymaga pełnego workspace'u (Premium), funkcja w Becie.
spark.sql("DELETE FROM ckpt_source WHERE id <= 5")
upd = api.do("POST", f"/api/2.0/pipelines/{pid}/updates", body={"full_refresh": True})["update_id"]
print("news104_ckpt full refresh:", wait(pid, upd))
display(spark.sql(ORDERS))
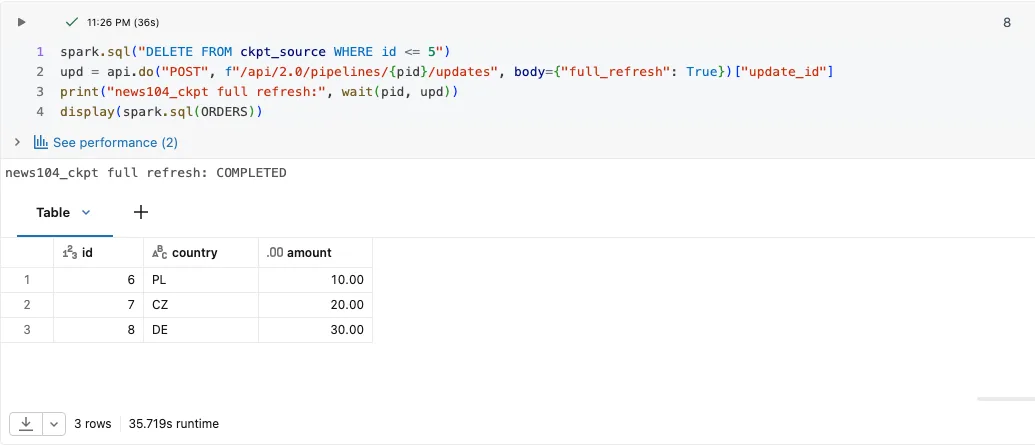
Wynik z labu: po full refresh w ckpt_orders zostały tylko 3 wiersze (id 6–8). Pipeline wyczyścił tabelę, zaczął od pustego checkpointu i przeczytał to, co było w źródle, więc 5 zamówień sprzed migracji zniknęło z tabeli.
Kod z tego artykułu na GitHubie →notebook i README krok po kroku · lakeflow-import-checkpoint
Notebook uruchamiałem na koncie admina w workspace'ie Azure Databricks Premium (trial), więc minimalnego zestawu uprawnień nie ustalałem. Run-as pipeline'u musi przeczytać checkpoint starego joba, więc to pierwsze uprawnienie do sprawdzenia.
Pułapki
- Full refresh po migracji przetwarza źródło od nowa. Przy źródle z krótką retencją historia znika z tabeli, jak na labie: z 8 wierszy zostały 3. Przy źródle, które ma wszystko, dostaniemy pełne przeliczenie, którego chcieliśmy uniknąć. Dlatego trzeba ustalić, kto może uruchomić full refresh tego pipeline'u.
- Zmiana ścieżki
import_checkpointw istniejącym flow nic nie robi i nie zgłasza błędu. Drugi import wymaga nowej nazwy flow. - Stary job musi być zatrzymany, zanim pipeline wystartuje. Jeśli dalej działa, oba piszą do tej samej tabeli i dostaniemy duplikaty. Mój wniosek: ostatni przerwany batch pipeline powtórzy, więc lepiej zatrzymać job po zatwierdzonym batchu.
- W bundlu ścieżkę checkpointu trzymajmy w zmiennej ustawionej tylko dla prod, bo inaczej deploy na dev sklonuje checkpoint produkcji.
- To Beta i jednorazowa migracja, więc potrzebuje planu: kiedy zatrzymujemy stary job, jak do niego wracamy (jego checkpoint zostaje nietknięty) i co robimy, jeśli pierwsza aktualizacja się nie uda.
Kiedy NIE używać
- Gdy stary job przetwarza małe źródło w kilka minut. Pełne przeliczenie w nowym pipeline'ie jest wtedy prostsze i nie wymaga Bety.
- Gdy cel ma być streaming table z AUTO CDC. Tabele z
create_tableobsługują tylkoappend_flow. - Gdy przy migracji zmieniamy też logikę zapytania ze stanem (operatory, klucze). Najpierw migracja 1:1, potem zmiany.
Podsumowanie
dp.create_table+@dp.append_flow(import_checkpoint=...)przenosi job Structured Streaming do pipeline'u bez przeliczania źródła. Na labie pipeline przejął tabelę starego joba i stan deduplikacji.- Import działa tylko przy pierwszej aktualizacji, a full refresh zaczyna od zera i przy źródle z krótką retencją gubi historię.
Chcesz kolejne wpisy? Obserwuj przez RSS albo na LinkedInie.
Komentarze
Na razie cisza na szlaku. Napisz pierwszy komentarz.