
 Krzysztof Burejza
cascade trzeba przekazać jawnie: true w dev i test, false na produkcji. We wrześniu doszły też okna serwisowe dla jobów ciągłych i, w Becie, import_checkpoint, czyli przeniesienie joba Structured Streaming do pipeline’u bez przeliczania źródła.Problem
Większość nowości w release notes dotyczy tego, co możemy napisać w kodzie. Te trzy zmiany w Lakeflow pipelines (w dokumentacji: Spark Declarative Pipelines on Lakeflow) dotyczą tego, jak pipeline'y żyją na produkcji: jak je usuwamy, kiedy się restartują i jak do nich migrujemy.
Pierwsza z nich zmienia domyślne zachowanie. Do tej pory usunięcie pipeline'u w Unity Catalog usuwało też jego materialized views i streaming tables. Od 25 września 2026 domyślnie tabele zostają. Jeśli mamy w CI/CD albo w środowiskach testowych skrypt, który sprząta po sobie przez usunięcie pipeline'u, to po tej dacie zostawia w katalogu tabele i dane, za które dalej płacimy za storage.
Jak to działa
1. Usunięcie pipeline'u zostawia tabele (25.09.2026, zmiana zachowania)
Dokumentacja opisuje to tak: kiedy usuwamy pipeline Unity Catalog w domyślnym trybie publikacji (default publishing mode), jego materialized views, streaming tables i widoki zostają. Dotyczy to zarówno przycisku Delete w UI, jak i DELETE w Pipelines API. Pozostawione tabele możemy dalej czytać, ale nie da się ich odświeżyć, dopóki nie przeniesiemy ich do aktywnego pipeline'u.
Co trzeba wiedzieć:
- Stare zachowanie dostajemy flagą
cascadew wywołaniu API:
http
  DELETE /api/2.0/pipelines/{pipeline_id}?cascade=true
Wymaga pełnego workspace'u (Premium), Unity Catalog. Flaga istniała już wcześniej, 25.09 zmieniła się tylko jej wartość domyślna.
- Hive metastore nie jest objęty zmianą. Pipeline'y HMS zachowują się jak wcześniej.
- Tryb publikacji sprawdzamy w polu Summary w ustawieniach pipeline'u albo w odpowiedzi
GET /api/2.0/pipelines/{pipeline_id}: poleeffective_publishing_modepowinno mieć wartośćDEFAULT_PUBLISHING_MODE. Na labie świeżo utworzony pipeline zwrócił dokładnieDEFAULT_PUBLISHING_MODE. Pipeline'y utworzone przed 5 lutego 2025 mogą jeszcze używać trybu legacy (schematLIVE). - Osierocone tabele według dokumentacji przenosimy do aktywnego pipeline'u. Notatka zmiany odsyła do strony „Move tables between pipelines”, która przepina tabelę przez właściwość
pipelines.pipelineId:
sql
  ALTER STREAMING TABLE sales
    SET TBLPROPERTIES("pipelines.pipelineId"="<destination-pipeline-id>");
Wymaga pełnego workspace'u (Premium), Databricks Runtime 16.3+ dla ALTER. Wykonujący musi być run-as i właścicielem obu pipeline'ów. Definicję tabeli dodajemy potem do kodu docelowego pipeline'u. Tego kroku nie sprawdzałem na labie, a strona opisuje przeniesienie między dwoma istniejącymi pipeline'ami, tu źródłowego już nie ma. Mówi też tylko o użytkowniku albo service principalu jako run-as, o grupie nie wspomina. Więcej w Lakeflow: pipeline, który nie należy do jednej osoby.
Sprawdziłem to na labie. Notebook usuwa pipeline news104_a zwykłym DELETE, po 20 s pokazuje, jakie pipeline'y news104_* zostały, listę tabel w schemacie (TABLES to zapytanie do information_schema.tables ograniczone do obiektów notebooka) i liczbę wierszy w tabelach A. api to WorkspaceClient().api_client, a pid_a i pid_b to identyfikatory pipeline'ów z kroku 1. Funkcja create_pipeline z notebooka zapisuje kod do pliku w workspace'ie, tworzy pipeline i startuje aktualizację, a wait czeka na jej koniec.
api.do("DELETE", f"/api/2.0/pipelines/{pid_a}")
time.sleep(20)
left = api.do("GET", "/api/2.0/pipelines", query={"filter": "name LIKE 'news104_%'"}).get("statuses", [])
print("news104_* pipelines:", sorted(p["name"] for p in left))
display(spark.sql(TABLES))
# the tables of the deleted pipeline A can still be read
display(spark.sql("""SELECT (SELECT COUNT(*) FROM a_orders) AS a_orders_rows,
  (SELECT COUNT(*) FROM a_total_by_country) AS a_total_by_country_rows"""))
✓ Wymaga pełnego workspace'u (Premium), Unity Catalog.
Pipeline znika z listy, ale jego streaming table i materialized view zostają w schemacie i dalej da się z nich czytać (5 i 3 wiersze).
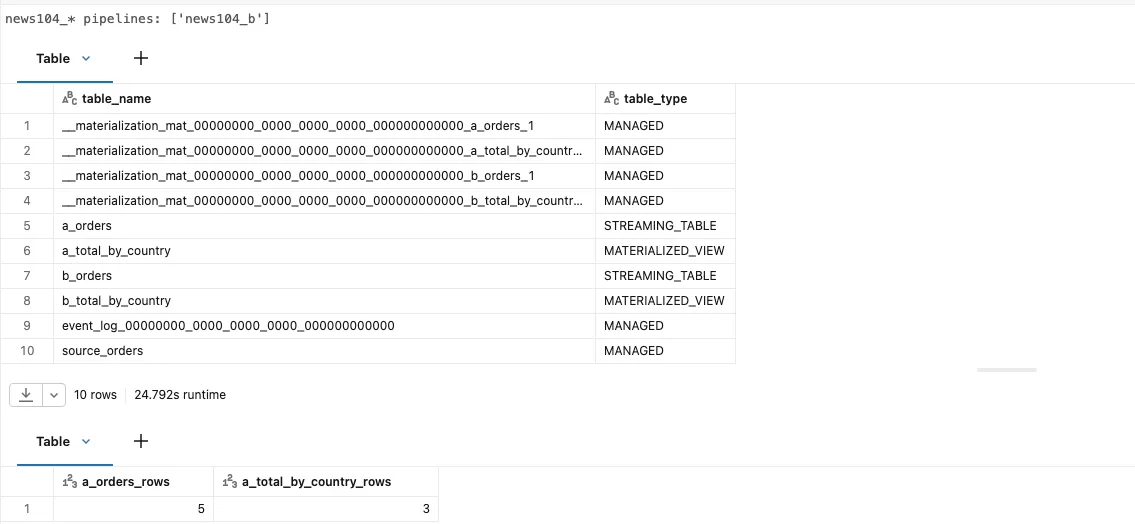
Wynik z labu: po DELETE /api/2.0/pipelines/{id} bez flagi z listy pipeline'ów zostaje tylko news104_b, a tabele a_orders i a_total_by_country są dalej w information_schema.tables. Ubyła tylko jedna z dwóch tabel event_log_*.
Pipeline news104_b usuwamy tak samo, tylko z cascade=true:
api.do("DELETE", f"/api/2.0/pipelines/{pid_b}", query={"cascade": "true"})
time.sleep(20)
display(spark.sql(TABLES))
✓ Wymaga pełnego workspace'u (Premium), Unity Catalog.
Z cascade=true pipeline news104_b zabrał ze sobą b_orders, b_total_by_country i swój event log.
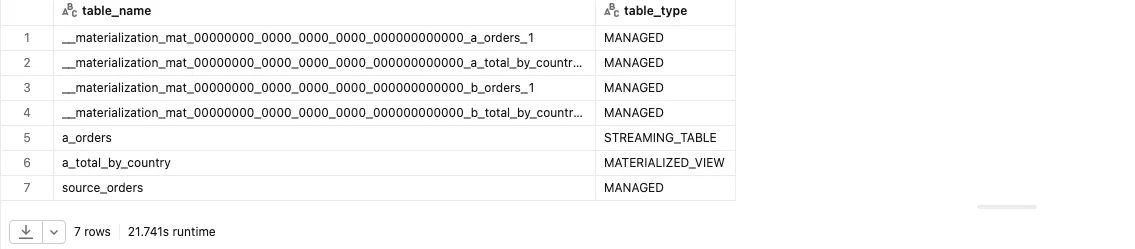
Wynik z labu: po DELETE ...?cascade=true tabel b_* już nie ma, ale wewnętrzne tabele __materialization_mat_*_b_* są nadal widoczne 20 s po usunięciu (więcej w Pułapkach).
Usuwanie pipeline'u w CI/CD
Na produkcji nowe domyślne zachowanie jest bezpieczniejsze, bo przypadkowe usunięcie pipeline'u nie kasuje już danych. W środowiskach efemerycznych (dev, test, środowisko per branch) jest odwrotnie: tabele zostają w katalogu, zajmują storage, a ktoś może zbudować na nich raport, który już się nie odświeży. Dlatego o cascade decydujemy per środowisko i zawsze przekazujemy go jawnie.
- REST, CLI i SDK. Referencja REST API („By default, this parameter will be true”),
databricks pipelines delete --help(sprawdziłem w CLI 1.16.1 i w kodzie v1.21.0) i docstring w Python SDK nadal opisują stare zachowanie. Nie polegamy więc na wartości domyślnej: w dev i test?cascade=true,databricks pipelines delete <id> --cascadealbow.pipelines.delete(pipeline_id, cascade=True), a na produkcji jawnefalse. - Bundles. W Declarative Automation Bundles (dawniej Databricks Asset Bundles) zasób pipeline'u ma pole
cascade_on_destroy(od Databricks CLI 1.12.0, silnik direct, który od CLI 1.20.0 jest jedynym silnikiem bundli). Bez niego obowiązuje domyślne zachowanie serwera, czyli tabele zostają. Ustawiamy je per target:devitestnatrue,prodjawnie nafalse, a na prod można dodaćlifecycle.prevent_destroy: true. Z kodu CLI wynikają jeszcze trzy rzeczy, których nie sprawdzałem na labie. CLI czytacascade_on_destroyze stanu ostatniego deployu, więc po dopisaniu pola najpierwbundle deploy, a dopiero potembundle destroy.bundle destroybez tego pola (stan na v1.21.0) pyta, czy usunąć pipeline'y „along with the Streaming Tables (STs) and Materialized Views (MVs) managed by them”, ale wysyłaDELETEbezcascade. Abundle deploy, który odtwarza pipeline (np. po zmianiecatalogalbostorage), też zostawia stare tabele, choć komunikat CLI zapowiada full refresh, więc takie zmiany przeglądamy wcześniej wbundle plan. - Terraform. Provider Terraform (v1.137.0) nie ma odpowiednika
cascade_on_destroyi usuwa pipeline bezcascade, więcterraform destroyzostawia tabele. Tak samo działają bundle na CLI 1.19 i starszych z silnikiem terraform. Tu sprzątamy jawnymDROP. - Ponowne wdrożenie z tymi samymi nazwami. Nowy pipeline trafi na osierocone tabele. Na labie sprawdziłem tylko
DROP(tabele A w kroku sprzątania) i to jest pewna droga. Przepięcie przezpipelines.pipelineIdwedług dokumentacji zakłada istniejący pipeline źródłowy, a jakim błędem skończy się wdrożenie na zajęte nazwy, nie testowałem. - Właściciel osieroconych tabel. Spodziewam się, że zostaje nim tożsamość, która była run-as pipeline'u, więc przy run-as grupie tabele należałyby do grupy, a nie do nas. Spodziewam się też, że tabela zachowuje
pipelines.pipelineId, więc osierocone tabele znajdziemy, porównując tę właściwość z listą istniejących pipeline'ów. Dokumentacja tego nie opisuje, a na labie tego nie sprawdzałem.
2. Okna serwisowe dla jobów ciągłych (10.09.2026, Azure 15.09.2026)
Pipeline w trybie continuous nigdy się nie kończy, więc Databricks nie może poczekać do końca przebiegu z aktualizacją runtime'u czy infrastruktury serverless. Restartuje go: startuje nową aktualizację na świeżym klastrze i zamyka poprzednią, a nowa wznawia pracę z checkpointu. Do tej pory taki restart mógł przyjść o dowolnej porze. Teraz możemy wskazać okno: dzień tygodnia, godzinę startu (0–23) i strefę czasową (identyfikator strefy Java, np. Europe/Warsaw). Maintenance zaczyna się tylko w ciągu godziny od startu okna.
Okno jest ustawieniem joba w trybie continuous, który uruchamia pipeline. W UI znajdziemy je w Jobs (wyzwalacz Continuous → Advanced → Maintenance window) albo w pipeline'ie (Schedule → Advanced settings → Maintenance window). W Jobs API to pole maintenance_window w sekcji continuous:
{
  "continuous": {
    "pause_status": "UNPAUSED",
    "maintenance_window": {
      "start_hour": 2,
      "day_of_week": "SUNDAY",
      "timezone_id": "Europe/Warsaw"
    }
  }
}
✓ Wymaga pełnego workspace'u (Premium). Wszystkie trzy pola są obowiązkowe. To fragment ustawień joba (zadanie pipeline_task jest w notebooku). Z UNPAUSED job startuje od razu i działa bez przerwy, więc na próbę dajmy PAUSED.
Na labie Jobs API 2.2 przyjęło taki job z pause_status: PAUSED i zadaniem pipeline'u, a jobs/get zwrócił okno bez zmian. Job był wstrzymany i od razu usunięty, więc samego restartu w oknie nie obserwowałem.
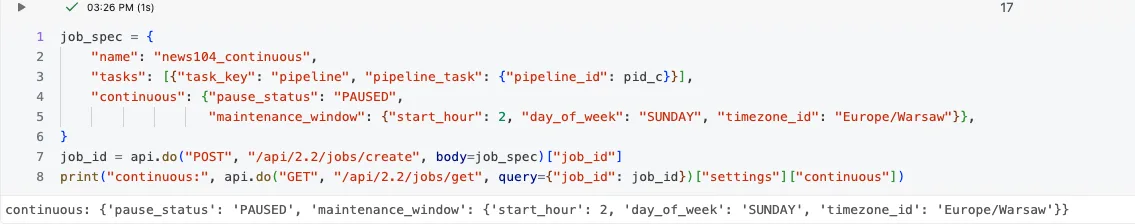
Wynik z labu: continuous odczytane z jobs/get zawiera maintenance_window z tymi samymi trzema polami, które wysłaliśmy w jobs/create.
Na co uważać:
- Serverless ma maksymalny czas życia klastra. Jeśli limit przyjdzie przed najbliższym oknem, Databricks i tak zrestartuje pipeline poza oknem. Strona o oknach nie podaje, ile ten limit wynosi. W release notes pipeline'ów ze stycznia 2026 jest restart pipeline'ów ciągłych po 7 dniach z przyczyną
INFRASTRUCTURE_MAINTENANCE, ale bez informacji, czy to ten sam limit. - Zmiana czasu. Okno liczone jest w podanej strefie, więc w dniu zmiany czasu start może przesunąć się o maksymalnie godzinę.
- Powiadomienia. Job może wysyłać zdarzenia Maintenance start i Maintenance complete (e-mail, Slack, Teams, PagerDuty), a w drugim jest czas trwania restartu i stan pipeline'u po nim.
- Okno działa tylko dla jobów continuous (także tych, które uruchamiają pipeline). Dla harmonogramu i innych wyzwalaczy tego ustawienia nie ma.
- Pipeline ciągły bez joba. Dokumentacja opisuje okno tylko na jobie continuous. Pipeline uruchamiany przez taki job sam jest triggered, a o pracy ciągłej decyduje job. Dla pipeline'u z
continuous: truew jego własnych ustawieniach okna w dokumentacji nie znalazłem. - Okno w IaC. W bundlach to
resources.jobs.<job>.continuous.maintenance_window(od CLI 1.16.0), a według schematu z CLI 1.21.0 takżetriggers[].continuous.maintenance_window, w Becie. Legacy polacontinuousnie wyślemy razem ztriggers(Lakeflow Jobs: kilka triggerów na jednym jobie), a wariantu ztriggersnie testowałem. Provider Terraform tego pola nie ma, więc okno ustawione ręcznie w UI nie trafi do kodu.
3. Tabele zarządzane w pipeline'ach i import_checkpoint (10.09.2026, Beta)
dp.create_table() tworzy w pipeline'ie zwykłą tabelę zarządzaną (nie streaming table), do której piszą jeden lub więcej flow @dp.append_flow. W SQL odpowiednikiem jest CREATE TABLE ... FLOW. Moduł w 2026 roku to from pyspark import pipelines as dp.
Parametr import_checkpoint w @dp.append_flow wskazuje checkpointLocation istniejącego zapytania Structured Streaming (ścieżka w chmurze, wolumen UC albo DBFS). Przy pierwszej aktualizacji pipeline klonuje ten checkpoint do swojego storage'u i wznawia od ostatniego zatwierdzonego offsetu, razem ze stanem (agregacje, klucze deduplikacji, watermarki). Oryginalny checkpoint nie jest modyfikowany.
W notebooku kod pipeline'u jest w zmiennej migration_code, a CKPT to wolumen z checkpointem zwykłego zapytania Structured Streaming, które wcześniej zapisało ss_orders. Ta sama komórka tworzy pipeline, czeka na aktualizację i porównuje obie tabele:
migration_code = f'''
from pyspark import pipelines as dp

dp.create_table("c_orders")

@dp.append_flow(
    target="c_orders",
    import_checkpoint="{CKPT}/ss_orders",
)
def migrate_orders():
    return spark.readStream.table("source_orders")
'''
pid_c, upd_c = create_pipeline("news104_c", migration_code)
t0 = time.time()
print("news104_c:", wait(pid_c, upd_c), f"after {time.time() - t0:.0f} s")
# if the checkpoint was taken over, c_orders has only the 3 new rows (ids 6-8)
display(spark.sql("""SELECT 'ss_orders' AS table_name, COUNT(*) AS row_count, MIN(id) AS min_id, MAX(id) AS max_id FROM ss_orders
  UNION ALL SELECT 'c_orders', COUNT(*), MIN(id), MAX(id) FROM c_orders"""))
✓ Wymaga pełnego workspace'u (Premium), Unity Catalog, funkcja w Becie.
Na labie Beta zadziałała za pierwszym razem: pipeline news104_c zakończył aktualizację ze stanem COMPLETED po 62 s i przejął checkpoint zwykłego zapytania Structured Streaming.
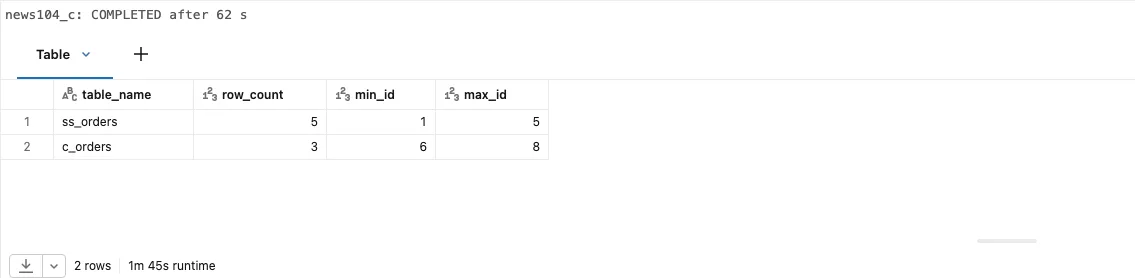
Wynik z labu: ss_orders (stary job) ma 5 wierszy o id 1–5, a c_orders tylko 3 wiersze o id 6–8, czyli pipeline wznowił od offsetu z checkpointu i nie przeliczył źródła od początku.
Ograniczenia z dokumentacji, które trzeba znać przed migracją:
- Flow musi pisać do nowej tabeli utworzonej przez
create_tablealbo do sinka. Import do istniejącej tabeli (np. do celu starego joba) nie jest wspierany, acreate_tablenie adoptuje istniejącej tabeli. - Checkpoint importuje się tylko raz, przy pierwszej aktualizacji. Full refresh nie importuje go ponownie, tylko zaczyna od pustego checkpointu i przetwarza źródło od początku.
- Żeby zaimportować inny checkpoint, potrzebna jest nowa nazwa flow. Sama zmiana ścieżki
import_checkpointw istniejącym flow nic nie robi i nie zgłasza żadnego błędu. - Źródło musi być to samo. Przy zapytaniach ze stanem (agregacje, deduplikacja) obowiązują zwykłe reguły checkpointu Structured Streaming: dokumentacja nie dopuszcza zmian operacji stanowych między restartami, więc zostawiamy te same operatory i klucze. Do tego
dropDuplicates()idropDuplicatesWithinWatermark()mogą nie wystartować po zmianie trybu dostępu compute. Dozwolone są tylko pary dedicated ↔ no isolation i standard ↔ serverless, więc job z klastra dedicated przenoszony do serverless pipeline'u jest poza nimi. Że te reguły dotyczą teżimport_checkpoint, to mój wniosek (pipeline wznawia sklonowany checkpoint razem ze stanem). Na labie sprawdziłem tylko zapytanie bezstanowe. - Tabele zarządzane w pipeline'ie nie obsługują AUTO CDC ani replace flows, tylko
append_flow. - Stary job trzeba zatrzymać czysto, po zatwierdzeniu ostatniego batcha, i dopiero potem uruchomić pipeline. Jeśli oba będą pisać równolegle albo ostatni batch zostanie przerwany, te same offsety przetworzą oba i te same wiersze trafią do obu tabel, więc przy czytaniu obu dostaniemy duplikaty.
Krok po kroku: demo na labie
Notebook lakeflow_september_2026.py robi wszystko przez REST API z poziomu notebooka, na serverless. Kod pipeline'ów zapisuje sam do plików w workspace'ie. Uruchomiłem go na swoim koncie admina w nowym workspace'ie Azure Databricks Premium (trial). Bez admina potrzebujemy USE CATALOG, prawa do tworzenia schematu (albo tabel, materialized views i wolumenu w istniejącym schemacie) oraz prawa do tworzenia pipeline'ów i jobów. Notebook po kolei:
- Tworzy tabelę źródłową
source_orders(5 wierszy) i dwa małe pipeline'y serverless:news104_ainews104_b. Każdy ma streaming table*_ordersi materialized view*_total_by_country. - Usuwa
news104_adomyślnymDELETEi pokazujeinformation_schema.tablesorazSELECT COUNT(*)z jego tabel. - Próbuje
REFRESHna osieroconych tabelach. - Usuwa
news104_bzcascade=truei znowu pokazuje listę tabel. - Uruchamia zwykłe zapytanie Structured Streaming (
trigger(availableNow=True)) z checkpointem w wolumenie, a potem dopisuje do źródła 3 nowe wiersze. - Tworzy pipeline
news104_cz kodem z sekcji 3 (import_checkpoint) i porównuje tabele. - Tworzy job z wyzwalaczem
continuousw staniePAUSEDi zmaintenance_window, odczytuje jego ustawienia i od razu go usuwa. Nic nie jest uruchamiane w trybie ciągłym. - Sprząta: pipeline'y z
cascade=true, tabele, wolumen z checkpointem, pliki źródłowe.
Wyniki z labu:
news104_ainews104_bwystartowały równolegle i oba skończyły się ze stanemCOMPLETEDpo 62 s. Pipelinenews104_czimport_checkpointteż potrzebował 62 s. Cały notebook trwał około 5 minut, z czego 40 s to pauza, którą nagrywarka dokłada w kroku 6, żeby film zdążył pokazać pipeline w UI.- Po usunięciu
news104_abezcascadetabelea_orders(STREAMING_TABLE) ia_total_by_country(MATERIALIZED_VIEW) zostały winformation_schema.tablesi dało się z nich czytać: 5 i 3 wiersze. REFRESHskończył się błędem compute'u (MV_NOT_ENABLED_ON_SERVERLESS_GENERIC_COMPUTE,ST_NOT_ENABLED_…), a nie informacją o osieroconej tabeli. Szczegóły w Pułapkach.- Po usunięciu
news104_bzcascade=truetabelb_ordersib_total_by_countryjuż nie było. c_ordersma tylko 3 nowe wiersze (id 6–8), a 5 starych zostało wss_orders.- Job continuous w stanie
PAUSEDzmaintenance_windowzostał przyjęty, odczytany i usunięty bez błędu. - Przy sprzątaniu
cascade=truenanews104_cusunął teżc_orders, czyli tabelę zarządzaną zdp.create_table.
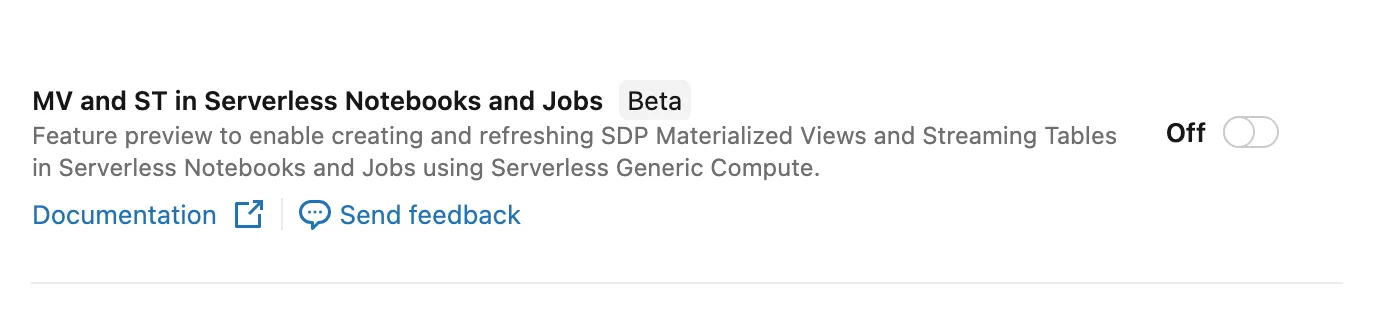
Strona Previews w workspace'ie labu (15.10.2026): przełącznik jest wyłączony (Off) i tak było przy nagraniu. Według opisu podglądu to on włącza tworzenie i odświeżanie MV i ST na serverless w notebookach i jobach, więc powinien usunąć błąd MV_NOT_ENABLED_ON_SERVERLESS_GENERIC_COMPUTE.
Pułapki
- Osierocona tabela wygląda na żywą. Da się z niej czytać, więc dashboard dalej działa, tylko dane stoją w miejscu. Przyda się zapytanie, które porównuje
pipelines.pipelineIdtabel z listą istniejących pipeline'ów. - Migracja przez
import_checkpointnie przenosi danych, a full refresh może je zdublować. Nowa tabela zaczyna od offsetu z checkpointu, więc historyczne wiersze zostają w starej tabeli. Można je dołożyć flow zonce=True(w SQLINSERT INTO ONCE), który czyta starą tabelę (ss_orders), a nie źródło, albo czytać obie tabele. Backfillu nie testowałem. Full refresh czyści tabelę docelową, uruchamia backfill jeszcze raz i przetwarza źródło od zera, bo checkpoint nie zostanie zaimportowany drugi raz, więc historia trafi do tabeli dwa razy. Przy źródle z krótką retencją (np. Kafka) części danych może już w ogóle nie być. - Beta.
create_tableiimport_checkpointsą w Becie.import_checkpointto jednorazowa migracja, więc potrzebuje planu: kiedy konsumenci przechodzą na nową tabelę, jak wracamy do starego joba (jego checkpoint zostaje nietknięty) i jak blokujemy full refresh.create_tablezostaje w kodzie na stałe, więc to decyzja na dłużej. W bundlu ścieżkę checkpointu trzymajmy w zmiennej ustawionej tylko dla prod, bo inaczej deploy na dev sklonuje checkpoint produkcji, a run-as pipeline'u musi mieć prawo odczytu tej ścieżki. REFRESHz notebooka na serverless może nie zadziałać w ogóle. Na labie dostałemMV_NOT_ENABLED_ON_SERVERLESS_GENERIC_COMPUTEiST_NOT_ENABLED_ON_SERVERLESS_GENERIC_COMPUTE, czyli błąd compute'u, a nie informację, że tabela jest osierocona. Według opisu podglądu ten błąd powinien zniknąć po włączeniu „MV and ST in Serverless Notebooks and Jobs” (Beta, na labie wyłączony). Nie sprawdzałem tego, a dokumentacja błędów mówi, że streaming table utworzonej przez pipeline nie odświeża się poza pipeline'em (REFRESH_DELTA_LIVE_TABLE). Jeśli chcemy sprawdzić, czy tabela po usuniętym pipeline'ie jest „martwa”, patrzymy napipelines.pipelineIdwe właściwościach tabeli albo na pipeline w Catalog Explorer, a nie na wynikREFRESH.cascade=truenie sprząta wszystkiego od razu. Po usunięciunews104_bzcascade=truetabeleb_*zniknęły, ale wewnętrzne tabele__materialization_mat_*_b_*były winformation_schema.tablesjeszcze 20 s później i na końcu notebooka, ponad 2 minuty później. Tak samo zostały__materialization_mat_*_a_*po ręcznymDROPtabel A. Nie sprawdzałem, czy znikają później same. Skrypt, który porównuje listę tabel w schemacie, trzeba przygotować na ten widok.- Event log znika razem z pipeline'em. Po zwykłym
DELETEpipeline'u A z dwóch tabelevent_log_*została jedna, czyli event log A zniknął, choć jego MV i ST zostały. Jeśli event log jest nam potrzebny do audytu, trzeba go skopiować przed usunięciem pipeline'u albo kopiować cyklicznie. - Aktualizacja serverless pipeline'u trwa około minuty. Najprostsza aktualizacja (5 wierszy, jedna ST i jedno MV) trwała na labie 62 s (w wpisie o run-as grupie 32 s). W testach integracyjnych, które tworzą i usuwają pipeline'y, to się szybko sumuje.
Kiedy NIE używać
import_checkpoint, gdy stary job i tak przetwarza małe źródło w kilka minut. Pełne przeliczenie w nowym pipeline'ie jest wtedy prostsze i nie wymaga Bety.import_checkpoint, gdy cel ma być streaming table z AUTO CDC. Tabele zarządzane w pipeline'ie wspierają tylkoappend_flow.- Okien serwisowych, gdy pipeline nie musi działać 24/7. Tryb triggered z harmonogramem i tak restartuje się przy każdym przebiegu, więc okno nie ma tam zastosowania, a tego ustawienia w ogóle tam nie ma.
- Domyślnego zachowania przy usuwaniu w środowiskach efemerycznych. Tam od razu jawne
cascade=true. cascade=truena produkcji. Tam jawnefalsechroni dane przed przypadkowym usunięciem pipeline'u.import_checkpoint, gdy przy migracji zmieniamy też logikę zapytania ze stanem (operatory, klucze). Najpierw migracja 1:1, potem zmiany.
Zobacz, jak to działa
Nagranie całego przebiegu angielskiego notebooka na labie (serverless), od utworzenia pipeline'ów A i B do sprzątania, z angielskimi opisami kroków na dole kadru i muzyką w tle. W kroku 6 film dwa razy przełącza się na stronę pipeline'u news104_c w UI: raz w trakcie aktualizacji, raz po jej zakończeniu (graf, właściciel, run as, 3 rekordy w c_orders). Czekanie na compute i na aktualizacje pipeline'ów jest przyspieszone 8×. W kopii notebooka do nagrania krok 6 ma dodatkową linię time.sleep(40), żeby film zdążył pokazać pipeline, a widget catalog ma wartość dataistheway zamiast domyślnego workspace. Poza tym kod jest taki sam jak w notebooku na GitHubie.
Kod z tego artykułu na GitHubie →notebook i README krok po kroku · lakeflow-september-2026
Podsumowanie
- Od 25.09.2026 usunięcie pipeline'u UC zostawia tabele. Stare zachowanie:
DELETE /api/2.0/pipelines/{id}?cascade=true. W CI/CD przekazujemycascadezawsze jawnie i per środowisko, bo pomoc REST, CLI i SDK opisuje jeszcze stary default. - Według dokumentacji pozostawione tabele są tylko do odczytu, dopóki nie przeniesiemy ich do aktywnego pipeline'u (
pipelines.pipelineId). Adopcji osieroconej tabeli nie testowałem. - Okno serwisowe (
continuous.maintenance_window) ustawiamy na jobie, który uruchamia pipeline ciągły. Na serverless restart może i tak przyjść poza oknem. dp.create_table+@dp.append_flow(import_checkpoint=...)(Beta) przenosi job Structured Streaming do pipeline'u bez przeliczania źródła, ale do nowej tabeli i bez historii.
Chcesz kolejne wpisy? Obserwuj przez RSS albo na LinkedInie.
Komentarze
Na razie cisza na szlaku. Napisz pierwszy komentarz.