
 Krzysztof Burejza
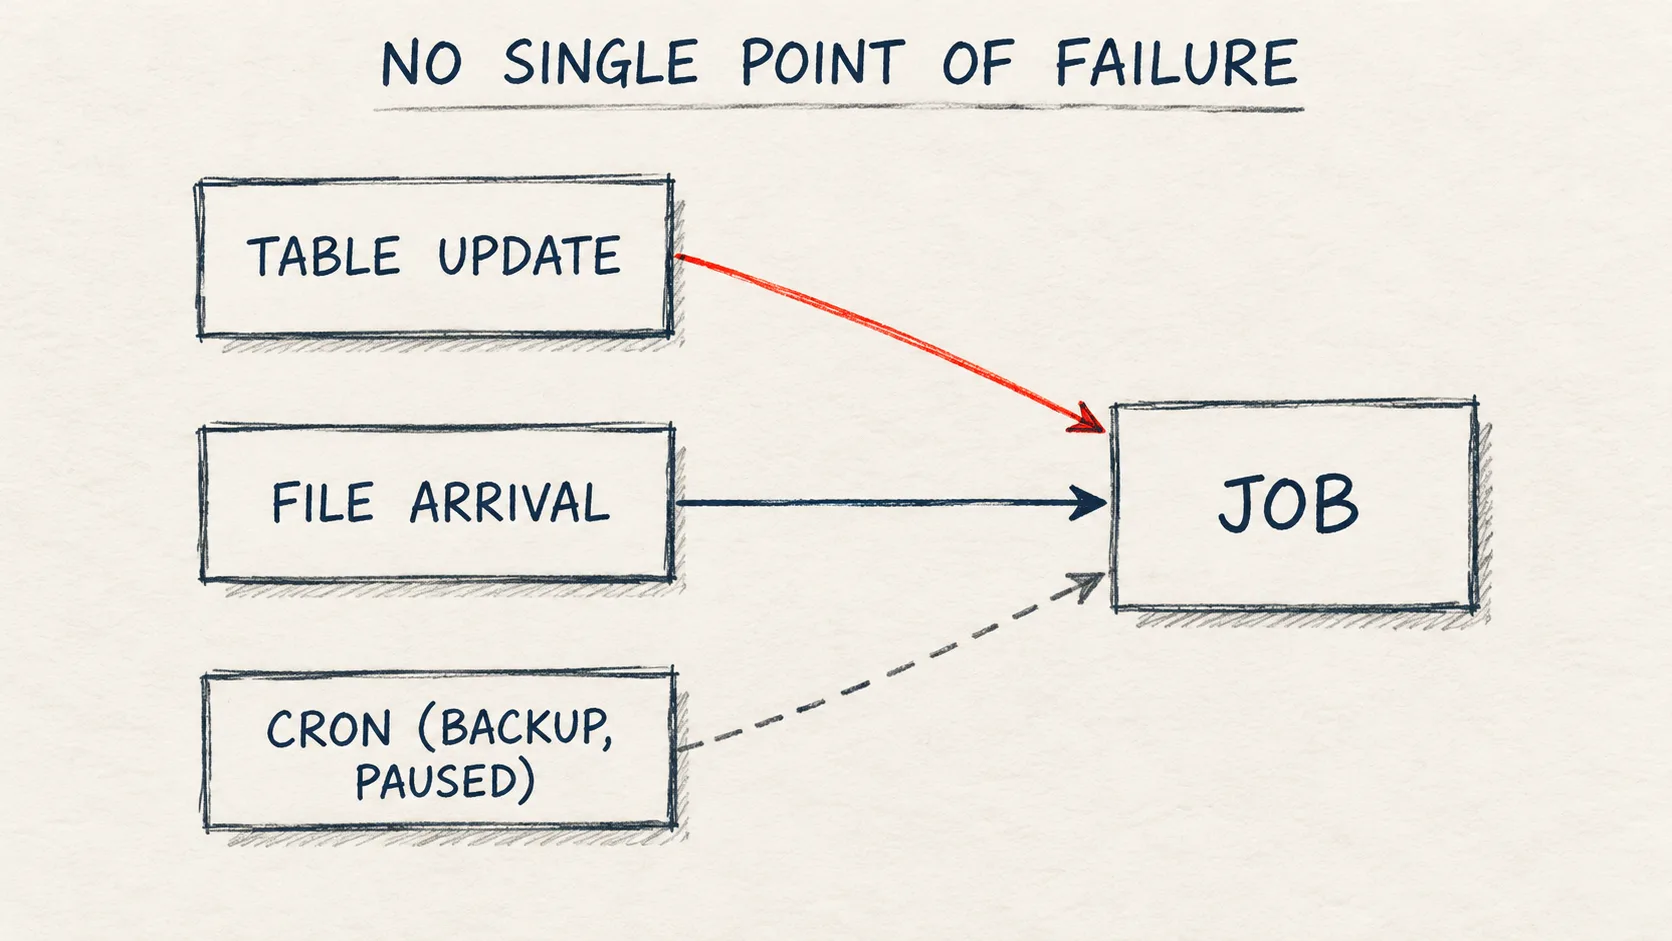
{{job.trigger.type}} odpowiednio table i file_arrival. Najwięcej pułapek jest w szczegółach: update zastępuje całą tablicę triggerów bez żadnego ostrzeżenia, a job z triggers nie przyjmie już legacy pola schedule.Problem
W projektach często widzę scenariusz, który kończy się pytaniem: „dlaczego ten raport od tygodnia pokazuje stare dane?”.
Job ma jeden trigger. Table update albo file arrival to dobre podejście, bo job startuje, kiedy dane faktycznie są gotowe, a nie o umówionej godzinie. Jeśli jednak proces nadrzędny przestanie pisać do tabeli, job po prostu się nie uruchomi. Nie ma błędu, nie ma alertu o nieudanym runie, bo żaden run nie wystartował. Do tej pory job miał jedno pole trigger albo jedno schedule, więc zapasowy harmonogram wymagał drugiego joba.
Tego samego dnia Lakeflow dostał też drugą zmianę: pipeline może działać jako grupa konta. Opisałem ją osobno w artykule Lakeflow: pipeline, który nie należy do jednej osoby.
Jak to działa
Job może mieć kilka triggerów tego samego albo różnych typów. Run startuje, kiedy którykolwiek aktywny trigger zostanie spełniony. Typowy przykład z dokumentacji: table update jako główny trigger i harmonogram jako zapas. Można też obserwować dwie lokalizacje plików dwoma triggerami file arrival.
Zapasowy harmonogram to jednak drugi run, a nie „run tylko wtedy, gdy tamten nie ruszył”. Cron uruchomi job także w dniu, w którym table update już przetworzył dane, więc zadanie musi być idempotentne. Do tego zapas nie zauważy, że źródło stoi: przeliczy te same stare dane i skończy się SUCCESS, więc raport z początku artykułu dalej będzie nieaktualny, tylko z zielonym runem. Zapas pomaga wtedy, gdy dane są, a trigger nie zadziałał (np. ktoś wstrzymał trigger table update i zapomniał go wznowić). Jeśli chcemy wiedzieć, że źródło przestało pisać, zadanie uruchomione z harmonogramu (dostaje wtedy w {{job.trigger.type}} wartość periodic) sprawdza świeżość źródła i kończy się błędem po przekroczeniu SLA. Wtedy działa zwykłe powiadomienie o nieudanym runie.
Co warto wiedzieć przed włączeniem:
- Beta za przełącznikiem. Admin workspace'u włącza ją na stronie Previews ustawieniem Multiple Triggers.
- Do pięciu triggerów na job w czasie Bety. Niezależnie od podglądu workspace ma limit 12 000 aktywnych triggerów (wstrzymane się nie liczą).
- Każdy trigger ma własne Pause/Resume. W UI to osobne kontrolki w sekcji Schedules & Triggers, w API pole
pause_statusna elemencie tablicy. - Continuous nie łączy się z niczym. Job ciągły i tak działa cały czas, więc trigger
continuousmusi być jedyny.
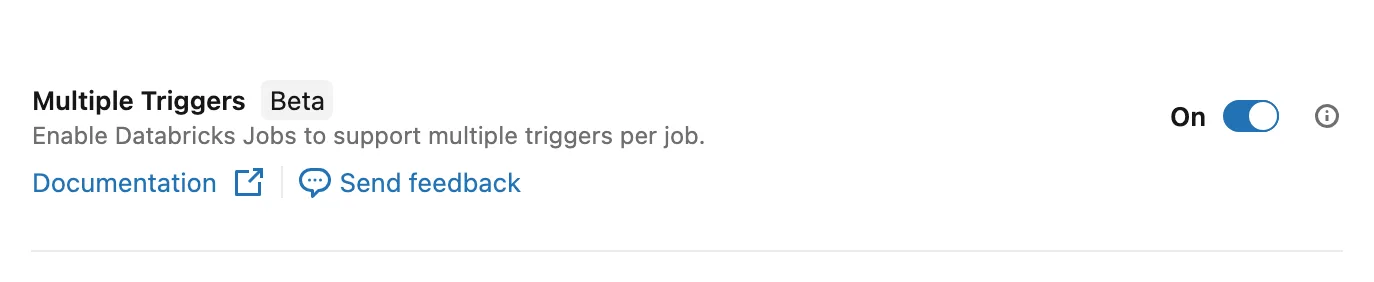
Strona Previews w workspace'ie: bez tego przełącznika job z tablicą triggers kończy się błędem FEATURE_DISABLED.
W Jobs API (2.1 i nowsze) to nowa tablica triggers w JobSettings. Każdy element ma dokładnie jeden typ triggera (table_update, file_arrival, schedule, periodic, continuous, a przy triggerze model update model) i opcjonalnie pause_status. Poniżej jest job z notebooka do tego artykułu.
✗ Na Free Edition nie działa: run od triggera czeka w kolejce z Queued due to reaching maximum number of allowed active runs (1) (2026-10-17).
job = {
    "name": "news134_multiple_triggers",
    "tasks": [{
        "task_key": "log_trigger",
        "notebook_task": {
            "notebook_path": TASK_NB,
            "base_parameters": {"log_table": f"{catalog}.{schema}.trigger_log",
                                "trigger_type": "{{job.trigger.type}}"},
        },
    }],
    "triggers": [
        {"table_update": {"table_names": [f"{catalog}.{schema}.source_orders"]}},
        {"file_arrival": {"url": LANDING}},
        {"schedule": {"quartz_cron_expression": "0 0 6 * * ?", "timezone_id": "Europe/Warsaw"},
         "pause_status": "PAUSED"},
    ],
}
job_id = api.do("POST", "/api/2.2/jobs/create", body=job)["job_id"]
print("job created")
Nagranie i wyniki poniżej są z workspace'u Premium z włączonym podglądem Multiple Triggers. Bez podglądu jobs/create kończy się błędem, który pokazuję niżej w pułapkach.
Kroki 1–2 (job z trzema triggerami i jego odczyt) przeszły na Free Edition bez błędu, więc podgląd jest tam włączony. Notebook uruchomiłem tam jako job i to on zajął jedyny dozwolony aktywny run, a run od zmiany tabeli czekał w kolejce. Dokumentacja Free Edition podaje limit 5 równoległych zadań na konto, więc komunikat o jednym aktywnym runie mnie zaskoczył. Interaktywnie tego notebooka na Free Edition nie uruchamiałem.
Harmonogram w tym przykładzie jest wstrzymany (PAUSED). W demo to wystarczy, ale na produkcji wstrzymany zapas sam nic nie zrobi: ktoś musi najpierw zauważyć brak runu i go wznowić. Jeśli zapas ma działać sam, ustawiamy UNPAUSED.
Dwa szczegóły w tym JSON-ie łatwo przeoczyć. pause_status siedzi na elemencie tablicy, a nie wewnątrz schedule jak w legacy polu schedule. A schedule w elemencie ma tylko dwa pola, oba wymagane: quartz_cron_expression i timezone_id. Kształt elementu sprawdziłem w schemacie bundli z Databricks CLI v1.16.1 (databricks bundle schema, definicja jobs.TriggerConfiguration). Na labie jobs/get zwrócił tablicę z trzema elementami i jawnym pause_status w każdym (UNPAUSED tam, gdzie go nie podałem). Serwer dopisał też do table_update pole condition: ALL_UPDATED, którego nie wysyłałem.
Trzy zasady z dokumentacji, które decydują o tym, jak piszemy automatyzację (drugą sprawdziłem na labie, pierwszą częściowo, wyniki niżej):
- Nie wysyłamy
triggersw tym samym żądaniu co legacyschedule,triggeralbocontinuous. - Update pola
triggerszastępuje całą tablicę. Nie da się „dopisać” albo „wznowić” jednego triggera, wysyłając tylko jego. Na labie to potwierdziłem, wyniki niżej. - W Declarative Automation Bundles (dawniej Databricks Asset Bundles) to samo pole to
triggersw zasobie joba (job.triggers), z tymi samymi kluczami co w API. W schemacie bundli pole jest od Databricks CLI 1.13.0, a w 1.12.1 go nie ma. Co robi starsze CLI, pokazuję w pułapkach. Bundle wdrażałem CLI 1.20.0.
Skąd wiemy, który trigger uruchomił run? Pole trigger w odpowiedzi jobs/runs/get mówi tylko, jakiego typu był trigger (TABLE, FILE_ARRIVAL, PERIODIC itd.). Tę samą wartość, małymi literami, zadanie dostaje przez {{job.trigger.type}}: na labie zadanie zapisało table i file_arrival. Przy table update jest jeszcze trigger_info.details z nazwą tabeli i jej wersją. W tabeli systemowej system.lakeflow.jobs job z co najmniej dwoma triggerami ma trigger_type = MULTIPLE, kolumnę trigger pustą, a konfigurację trzeba czytać z tablicy triggers. Jeśli monitorujemy joby na tabelach systemowych, zapytania i alerty po trigger_type albo trigger trzeba poprawić, zanim włączymy kilka triggerów, bo przestaną widzieć te joby.
Krok po kroku: demo na labie
Notebook lakeflow_multiple_triggers.py robi wszystko przez REST API z poziomu notebooka, na serverless. Obok jest folder task/ z notebookiem, który uruchamia job: zapisuje do trigger_log wartość {{job.trigger.type}}. Na początku notebook tworzy tabelę źródłową source_orders, tabelę trigger_log i wolumen landing.
- Tworzy job z trzema triggerami z kodu powyżej.
- Odczytuje ustawienia joba przez
jobs/get. - Czeka 90 s, dopisuje 2 wiersze do źródła i czeka na run z
trigger = TABLE. - Wrzuca plik
orders_1.jsondolanding/orders/i czeka na run ztrigger = FILE_ARRIVAL. Potem pokazuje, co zadania zapisały wtrigger_log. - „Tylko wznawia harmonogram”: wysyła
jobs/updatez tablicątriggersz jednym elementem i odczytuje, ile triggerów zostało. - Wysyła legacy
scheduledo joba, który ma jużtriggers.
Na końcu notebook usuwa job, tabele i wolumen.
Uruchomiłem go na swoim koncie admina w workspace'ie Azure Databricks Premium (trial), z włączonym podglądem Multiple Triggers. Cały notebook trwał około 5 minut: 90 s z tego to celowa przerwa przed INSERT, a 80 s to dwie pauzy po 40 s, dodane tylko po to, żeby w nagraniu pokazać job w Jobs UI (w kodzie na GitHubie ich nie ma, tak samo jak domyślnego katalogu dataistheway w widżecie, który widać w nagraniu). Najdłużej trwa krok 3 (około 3 minut), bo komórka czeka, aż run się skończy.
- Krok 1:
jobs/createz trzema triggerami przeszedł bez błędu. - Krok 2:
jobs/getzwrócił 3 triggery z jawnympause_statusi dopisanymcondition: ALL_UPDATEDprzytable_update. Krok drukuje też ustawienie kolejki: job utworzony przez API 2.2 bez polaqueuedostał{'enabled': True}. - Krok 3: run z
trigger = TABLEwystartował 13 s poINSERTi skończył sięSUCCESS. - Krok 4: run z
trigger = FILE_ARRIVALwystartował 8 s po zapisaniu pliku. Wtrigger_logsą dwa wiersze:tableifile_arrival. - Krok 5:
jobs/updatez jednym elementem (wznowiony harmonogram) przeszedł bez ostrzeżenia, ajobs/getpokazał już tylko 1 trigger. Table update i file arrival zniknęły. - Krok 6: samo
schedulena jobie ztriggersskończyło się błędem (treść niżej w pułapkach).
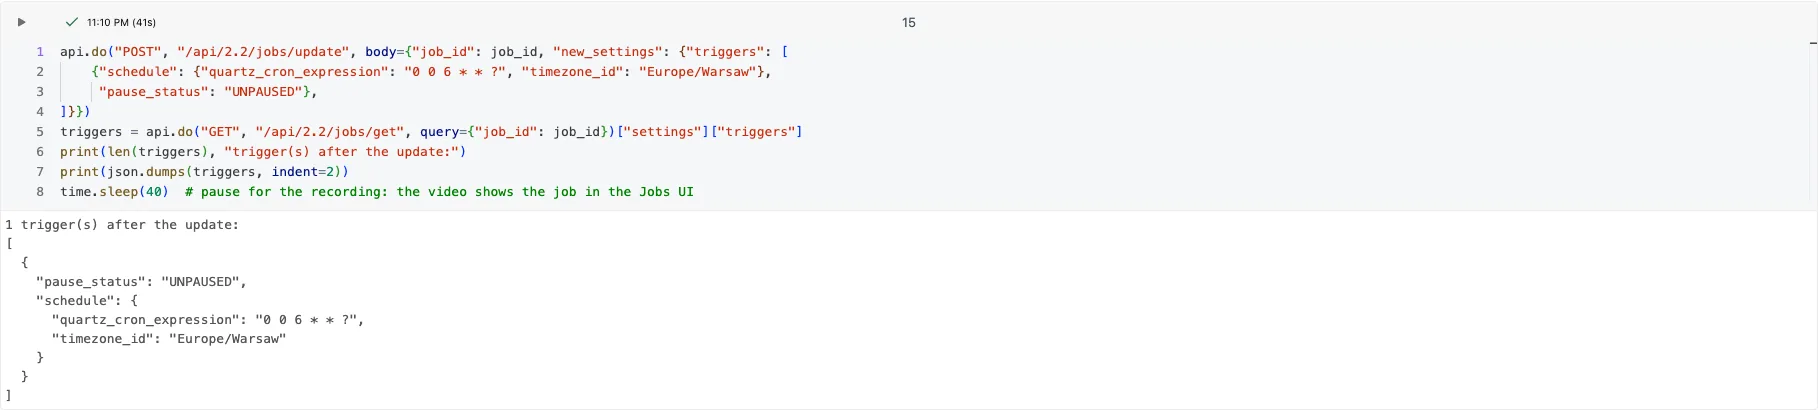
Wynik z labu: po jobs/update z jednym elementem job ma już tylko harmonogram.
Pułapki
- Update zastępuje całą tablicę
triggers. Skrypt, który „tylko wznawia harmonogram” i wysyła jeden element, kasuje pozostałe triggery. Bezpieczny wzorzec:jobs/get, zmiana w pobranej tablicy,jobs/updatez całą tablicą. Na labie API nie zwróciło żadnego ostrzeżenia, po prostu zostawiło jeden trigger z trzech. W bundle'u ten problem znika, bo zawsze wdrażamy całą definicję, ale pojawiają się dwa inne (dwa kolejne punkty). mode: developmenta tablicatriggers. Dokumentacja mówi, że target zmode: developmentwstrzymuje wszystkie harmonogramy i triggery. Sprawdziłem, co robi z tym CLI: wbundle validate -o json(CLI 1.13.0, 1.20.0 i 1.21.0) legacyschedulew targecie dev dostajePAUSED, a elementy tablicytriggerszostają bez zmian. Na serwerze wyszło to samo: job wdrożony do targetu dev (CLI 1.20.0) miał table update jakoUNPAUSED, a harmonogram jakoPAUSED, tak jak w YAML-u. PoINSERTdo tabeli run ztrigger = TABLEwystartował po 8 s i skończył sięSUCCESS. Jeśli trigger ma na dev stać, wpisujemy mupause_status: PAUSEDsami.- Ręczna pauza wraca przy deployu. Trigger wstrzymany ręcznie w UI albo przez API wraca przy następnym deployu do stanu z YAML-a. Sprawdziłem to na labie (CLI 1.20.0): po wstrzymaniu triggera table update przez API (
jobs/updatez całą tablicą)bundle planpokazałupdate jobs.orders, a pobundle deploytrigger znowu byłUNPAUSED. Tak samo zachował się legacyschedule. Trigger wstrzymany na dłużej (np. na czas awarii źródła) wpisujemy więc do repo. - Kilka triggerów, jeden run naraz. Domyślnie job może mieć jeden aktywny run, a bez kolejki run ponad limit
max_concurrent_runsjest pomijany: błędu nie ma, run dostaje stanSKIPPED, a powiadomienieon_failureprzyjdzie, jeśli job je ma i nikt nie zaznaczył Mute notifications for skipped runs (to ustawienie na poziomie joba nie wycisza powiadomień skonfigurowanych na zadaniach). Zapasowy cron, który trafi na trwający run od table update, przepadnie więc bez alertu wtedy, gdy job nie ma powiadomień albo pominięte runy są wyciszone. To znów sytuacja z początku artykułu. Na labie uruchomiłem dwa razy pod rząd job zmax_concurrent_runs: 1i 90-sekundowym zadaniem. Bez kolejki drugi run od razu dostałSKIPPEDzresult_state: MAXIMUM_CONCURRENT_RUNS_REACHEDi komunikatemSkipping this run because the limit of 1 maximum concurrent runs has been reached.Z kolejką (queue.enabled: true) drugi run czekał jakoQUEUED99 s, a potem skończył sięSUCCESS. Kolejka trzyma run do 48 godzin. - Domyślna kolejka zależy od tego, jak job powstał. Na labie job utworzony przez Jobs API 2.1 nie miał pola
queue, a przez API 2.2 dostał"queue": {"enabled": true}. Tak samo job wdrożony bundle'em. Dokumentacja dodaje, że w UI kolejka jest domyślna dla jobów utworzonych po 15.04.2024. Dlatego w automatyzacji ustawiamyqueue.enabledjawnie, zamiast polegać na wersji API, której używa klient. - Na dev kolizji nie widać. Job wdrożony do targetu z
mode: developmentbezmax_concurrent_runsdostał na labiemax_concurrent_runs: 4, więc dwa runy pójdą tam równolegle. Żeby zobaczyć na dev to, co na produkcji, ustawiamy w jobiemax_concurrent_runs: 1(w targecie prod bez trybu CLI ustawił 1). - Mieszanie z legacy polami.
triggersnie może iść w jednym żądaniu zschedule,triggeranicontinuous. Dotyczy to też narzędzi, które generują JSON joba z szablonu z polemschedule. Na labie odrzucone było nawet samoschedulewysłane do joba, który ma jużtriggers:This job has multiple triggers configured via 'triggers'. Use the 'triggers' field to manage them; 'schedule', 'trigger', and 'continuous' cannot be set.Komunikat mówi „multiple triggers”, choć po kroku 5 job miał już tylko jeden. Liczy się samo poletriggers, liczba elementów nie ma znaczenia. - Bez przełącznika nic nie działa. Gdy podgląd Multiple Triggers jest wyłączony, job z
triggersnie powstanie. Na labie dostałemNotFound FEATURE_DISABLED: The 'triggers' field is in private preview and is not enabled for this workspace.Pipeline CI/CD, który wdraża ten sam bundle na kilka workspace'ów, potrzebuje włączonego podglądu w każdym z nich. Warto też wiedzieć, że komunikat mówi o private preview, choć release note i dokumentacja nazywają funkcję Betą, więc szukanie w dokumentacji po słowie „Beta” może go nie znaleźć. Z bundle'em sprawdziłem to na labie, gdy podgląd był wyłączony:bundle validatew CLI 1.20.0 kończy sięValidation OK!, a dopierobundle deployzwracacannot create resources.jobs.orders: The 'triggers' field is in private preview and is not enabled for this workspace. (404 FEATURE_DISABLED). Przy jobie, który już istnieje, ten sam błąd przychodzi zjobs/reset. -
Starsze CLI wdraża job bez triggerów. Databricks CLI 1.12.1 przy
bundle validatezgłasza tylkoWarning: unknown field: triggersi kończy się kodem 0.bundle deploytą wersją kończy sięDeployment complete!, a wdrożony job matriggers: null, czyli nie uruchomi się sam ani razu. W CI przypinamy więc wersję CLI, którą sprawdziliśmy (u mnie 1.20.0; poletriggersjest w schemacie od 1.13.0, ale według changelogu CLI dopiero 1.15.0 poprawiło job z triggeremtable_update, który na silniku direct nie dochodził do stanu z YAML-a), i uruchamiamybundle validate --strict, które przy tym ostrzeżeniu kończy się błędemError: 1 warning was found. Warnings are not allowed in strict mode. Joba, który już ma triggery, CLI 1.12.1 nie zepsuło: po jego deployu job dalej miał oba triggery. Problem dotyczy więc pierwszego deployu, np. na nowy workspace. -
Nie wiemy, który z dwóch triggerów tego samego typu zadziałał. Run ma tylko typ triggera. Przy dwóch triggerach file arrival na różnych ścieżkach zadanie musi samo sprawdzić, gdzie są nowe pliki (np. Auto Loader na obu ścieżkach). Dokumentacja opisuje
{{job.trigger.file_arrival.location}}w liczbie pojedynczej i nie mówi, co zwraca przy dwóch triggerach file arrival, więc na razie nie budowałbym na tym logiki. Przy table update pomaga{{job.trigger.table_update.updated_tables}}z listą zmienionych tabel, przy file arrival takiego odpowiednika nie ma. - Trigger table update potrzebuje dostępu run-as do tabeli. Według dokumentacji tożsamość z pola Run as musi mieć
SELECTna każdej obserwowanej tabeli plusUSE CATALOGiUSE SCHEMA. Na labie sprawdziłem przypadek, gdy dostępu brakuje już przy tworzeniu joba: trigger nasystem.billing.usage, do której service principal labu nie maUSE SCHEMA, nie przeszedł (ten sam błąd przy tablicytriggersi przy starym polutrigger).jobs/createzwróciłoPERMISSION_DENIED: User does not have USE SCHEMA on Schema 'system.billing'. Gorszy jest przypadek, gdy run-as straciSELECTpóźniej albo przełączymy job na inną tożsamość: według dokumentacji trigger przestaje się wtedy ewaluować i job nie startuje, a dowiemy się o tym tylko wtedy, gdy job ma powiadomienie o błędzie (on_failure). Tego przypadku na labie nie odtworzyłem: testy uprawnień robiłem jako service principal labu, który maALL PRIVILEGESna całym katalogu, a uprawnienia odziedziczonego z katalogu nie odbierzemy na jednej tabeli. - Run-as może być też grupą. Dokumentacja Jobs zaleca na produkcji run-as jako service principal, ale job (tak jak pipeline, opisany w Lakeflow: pipeline, który nie należy do jednej osoby) może też działać jako grupa konta:
run_as.group_namew API i w zasobie joba w bundle'u. Grupa musi być przypisana do workspace'u, a wtedy to ona potrzebujeSELECTna tabelach z triggera. Według dokumentacji grupę jako run-as ustawi jej członek albo ktoś z uprawnieniem Assume, a grupa potrzebuje dostępu do wszystkiego, czego używa job, także odczytu notebooków. Dokumentacja dodaje, że bundle domyślnie wdraża pliki do katalogu domowego osoby, która robi deploy, więcworkspace.root_pathustawiamy na folder współdzielony z prawem CAN VIEW dla grupy. Na labie API odrzuciło grupy wbudowane:The group 'users' cannot be used as a run-as identity for jobs. Broad groups such as 'account users', 'admins', and 'users' are not allowed.Grupa konta, która nie jest przypisana do workspace'u, dała ten sam błąd co grupa, której nie ma:'data-engineers' cannot be set as run_as because the group does not exist.Joba uruchomionego jako grupa nie pokazuję: te testy robiłem jako service principal labu, który nie może założyć grupy konta (to robi admin konta Databricks). - Notebook czeka 90 s przed
INSERT. Daje to triggerowi czas na start po utworzeniu joba. Krótszego odstępu nie sprawdzałem. W notebooku i w nagraniu napisałem, że świeży trigger najpierw zapamiętuje stan tabeli. W dokumentacji tego nie znalazłem, więc traktuj to jako moje założenie.
Kiedy NIE używać
- Na produkcji, dopóki to Beta i zależy od przełącznika workspace'u. Jeśli ten sam bundle idzie na dev i prod, do GA trzymałbym
triggerstylko w targecie dev, bo pierwszy deploy na prod bez włączonego podglądu skończy sięFEATURE_DISABLED. Warunek: bazowy job nie ma żadnego triggera,schedulestoi w targecie prod, atriggersw targecie dev (co z triggerami i równoległymi runami robi wtedymode: development, opisuję w pułapkach). Target nie usuwa pola z bazy. Sprawdziłem to wbundle validate -o json(CLI 1.20.0): przyschedulew bazie itriggersw targecie dev konfiguracja dev ma oba pola, avalidatenie zgłasza ostrzeżenia. Dopierobundle deploykończy się błędemcannot create resources.jobs.orders: The 'triggers' field cannot be set together with any of 'schedule', 'trigger', or 'continuous'. (400 INVALID_PARAMETER_VALUE). Układ, który przeszedł na labie, jest poniżej. Zapasowy harmonogram można do tego czasu zrobić drugim, prostym jobem. Na brak świeżych danych lepszy jest alert, np. alert SQL, który sprawdzamax()kolumny z czasem ładowania, albo anomaly detection w Unity Catalog (Public Preview), które pilnuje świeżości tabel. - Gdy różne triggery mają uruchamiać różną logikę. Run nie mówi, który trigger zadziałał, tylko jakiego był typu. Dwa osobne joby są wtedy czytelniejsze.
Tak wygląda bundle z tym układem. Bazowy job nie ma triggera, target dev dostaje tablicę triggers (table update i wstrzymany zapasowy harmonogram), a target prod zwykły schedule. ${var.catalog} i ${var.schema} to zmienne bundle'a.
✓ Wymaga workspace'u z podglądem Multiple Triggers w targecie dev; sprawdzone na Premium.
bundle:
  name: multiple_triggers_demo

variables:
  catalog:
    default: workspace
  schema:
    default: dataistheway_triggers

resources:
  jobs:
    orders:
      name: news134_bundle_triggers
      tasks:
        - task_key: log_trigger
          notebook_task:
            notebook_path: ./src/log_trigger.py
            base_parameters:
              log_table: ${var.catalog}.${var.schema}.trigger_log
              trigger_type: "{{job.trigger.type}}"

targets:
  dev:
    mode: development
    default: true
    resources:
      jobs:
        orders:
          triggers:
            - table_update:
                table_names: [ "${var.catalog}.${var.schema}.source_orders" ]
            - schedule:
                quartz_cron_expression: "0 0 6 * * ?"
                timezone_id: Europe/Warsaw
              pause_status: PAUSED
  prod:
    resources:
      jobs:
        orders:
          schedule:
            quartz_cron_expression: "0 0 6 * * ?"
            timezone_id: Europe/Warsaw
Tabele source_orders i trigger_log muszą istnieć przed deployem (tworzy je krok 0 notebooka), bo trigger na nieistniejącą tabelę jest odrzucany już przy tworzeniu joba. Na labie (CLI 1.20.0) bundle deploy do dev utworzył job z dwoma triggerami, run od zmiany tabeli zapisał table do trigger_log, a bundle deploy -t prod utworzył job z samym harmonogramem. Na Free Edition tego bundle'a nie sprawdzałem.
Zobacz, jak to działa
Nagranie przebiegu notebooka. W trakcie runu film przełącza się na stronę joba w Lakeflow Jobs UI: widać trzy triggery, runy „By table update” i „By file arrival”, a po kroku 5 już tylko jeden trigger. Oczekiwanie na runy jest w filmie przyspieszone 8×.
Kod z tego artykułu na GitHubie →notebook i README krok po kroku · lakeflow-multiple-triggers
Podsumowanie
- Job może mieć do pięciu triggerów (Beta, przełącznik Multiple Triggers). W API to tablica
triggers, każdy element z jednym typem i własnympause_status. - Na labie job wystartował od zmiany tabeli i od pliku, a
{{job.trigger.type}}mówi tylko, jakiego typu był trigger. - Update
triggerszastępuje całą tablicę (na labie bez ostrzeżenia) i nie łączy się z legacyschedule,triggeranicontinuous. - W bundle'u przypinamy wersję CLI, którą sprawdziliśmy (u mnie 1.20.0), i używamy
bundle validate --strict: CLI 1.12.1 wdrożyło job bez żadnego triggera i bez błędu. - Zapasowy harmonogram w tym samym jobie to drugi run: zadanie musi być idempotentne, job potrzebuje kolejki, a stojące źródło wykryje dopiero test świeżości. Dopóki to Beta, na produkcji bezpieczniej trzymać zapas w osobnym jobie.
Chcesz kolejne wpisy? Obserwuj przez RSS albo na LinkedInie.
Komentarze
Na razie cisza na szlaku. Napisz pierwszy komentarz.