
 Krzysztof Burejza
SELECT i zastanawia się, czy AI zabierze mu warsztat.Skąd ta teza
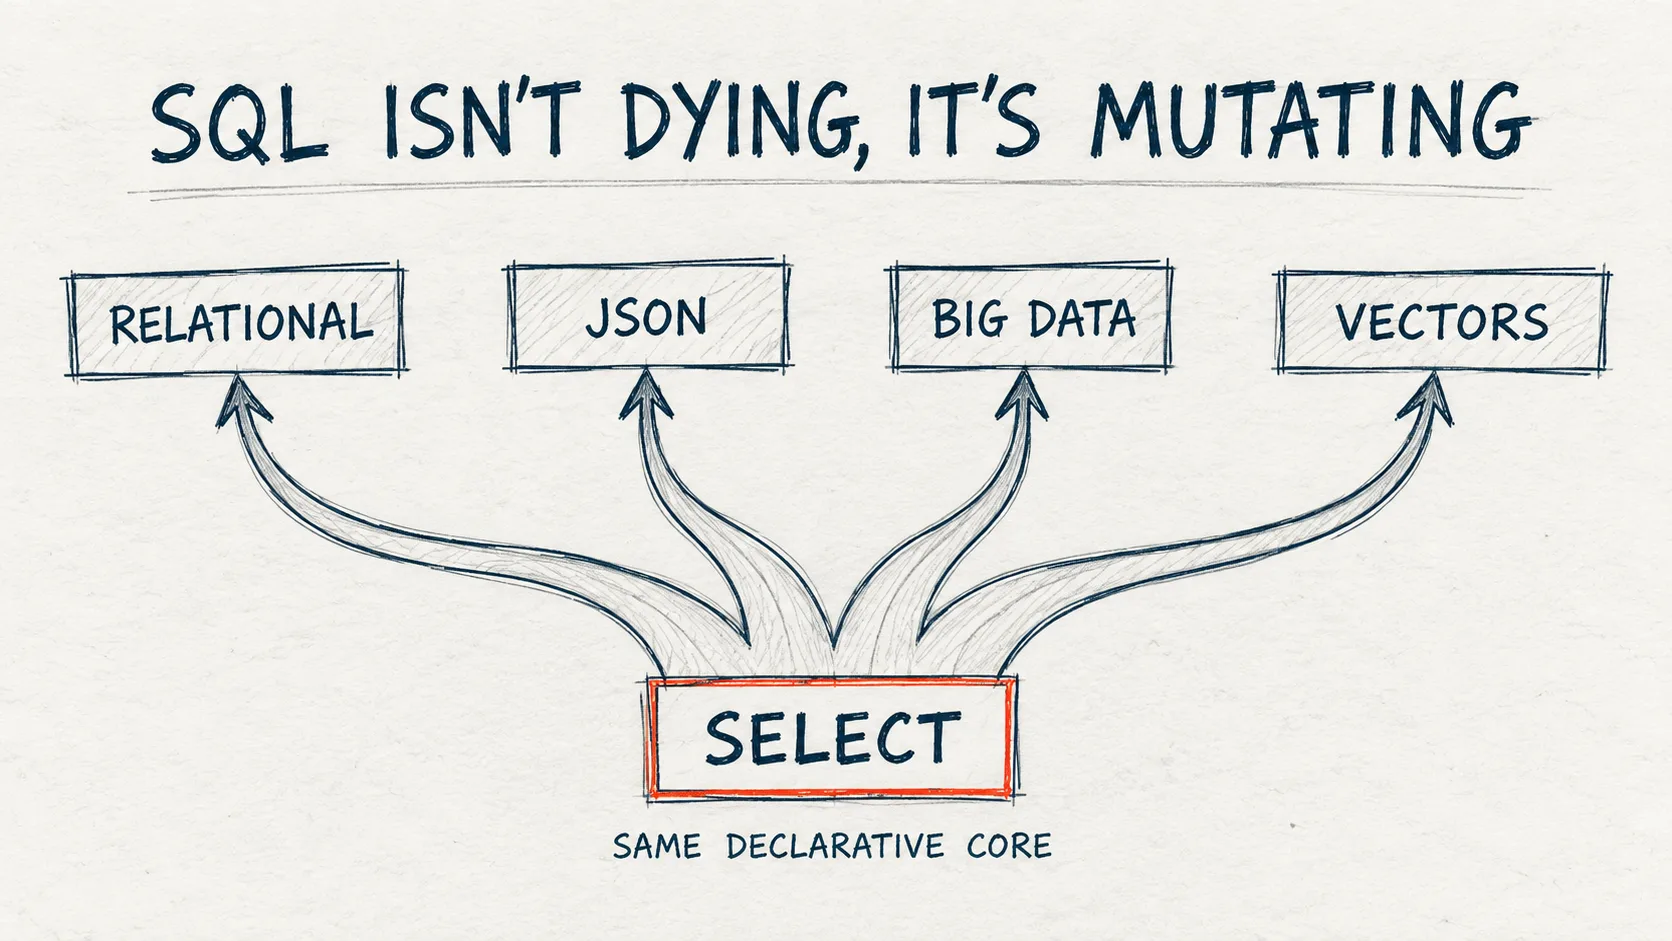
Jesienią 2025 roku przygotowałem prelekcję „O SQL, AI i Przyszłość Baz Danych”. Plan był prosty: trzy akty, SQL, AI i bazy danych przyszłości. Im dłużej zbierałem materiał, tym mocniej wracało do mnie jedno zdanie, które ostatecznie trafiło na slajd:
„SQL nie umiera, tylko mutuje.”
Mówiłem o tym w Krakowie i w Bielsku-Białej na spotkaniach ze studentami, gdzie temat był prosty: czy warto jeszcze pisać w SQL-u i się go uczyć. Wychodzi na to, że warto, bo SQL ciągle żyje i ma się dobrze.
Nie jest to obrona SQL-a z sentymentu. To obserwacja z historii tego języka i z codziennej pracy na Databricks, gdzie AI coraz częściej wołamy dokładnie tam, gdzie wcześniej pisaliśmy zwykły SELECT.
Fundament: mówimy „co”, a nie „jak”
SQL jest językiem deklaratywnym. Piszemy, jaki wynik chcemy dostać, a silnik sam decyduje, jak go policzyć. Klasyczny przykład ze slajdu:
✓ Sprawdzone na Free Edition (2026-10-17)
SELECT name, salary
FROM employees
WHERE salary > 5000
ORDER BY salary DESC;
Nie ma tu pętli, indeksów ani kolejności odczytu plików. Dzięki temu optymalizator może zmienić sposób wykonania, a zapytanie zostaje to samo. Moim zdaniem to jest główny powód, dla którego SQL przetrwał ponad pół wieku zmian technologicznych: warstwa „co” jest oddzielona od warstwy „jak”, więc pod spodem można wymienić prawie wszystko.
Dla osób, które nie pisały jeszcze w SQL-u, rozbierzmy to zapytanie na części. SELECT name, salary mówi, które kolumny chcemy zobaczyć. FROM employees wskazuje tabelę z pracownikami. WHERE salary > 5000 to filtr: zostają tylko te wiersze, w których pensja jest większa niż 5000. ORDER BY salary DESC sortuje wynik od najwyższej pensji. W demo tabela ma pięciu pracowników, z czego dwóch zarabia 5000 albo mniej, więc w wyniku zostają trzy osoby. Nigdzie nie piszemy, w jakiej kolejności czytać pliki ani jak przejść po danych. Opisujemy tylko wynik, którego oczekujemy, i to jest właśnie „co, a nie jak”.
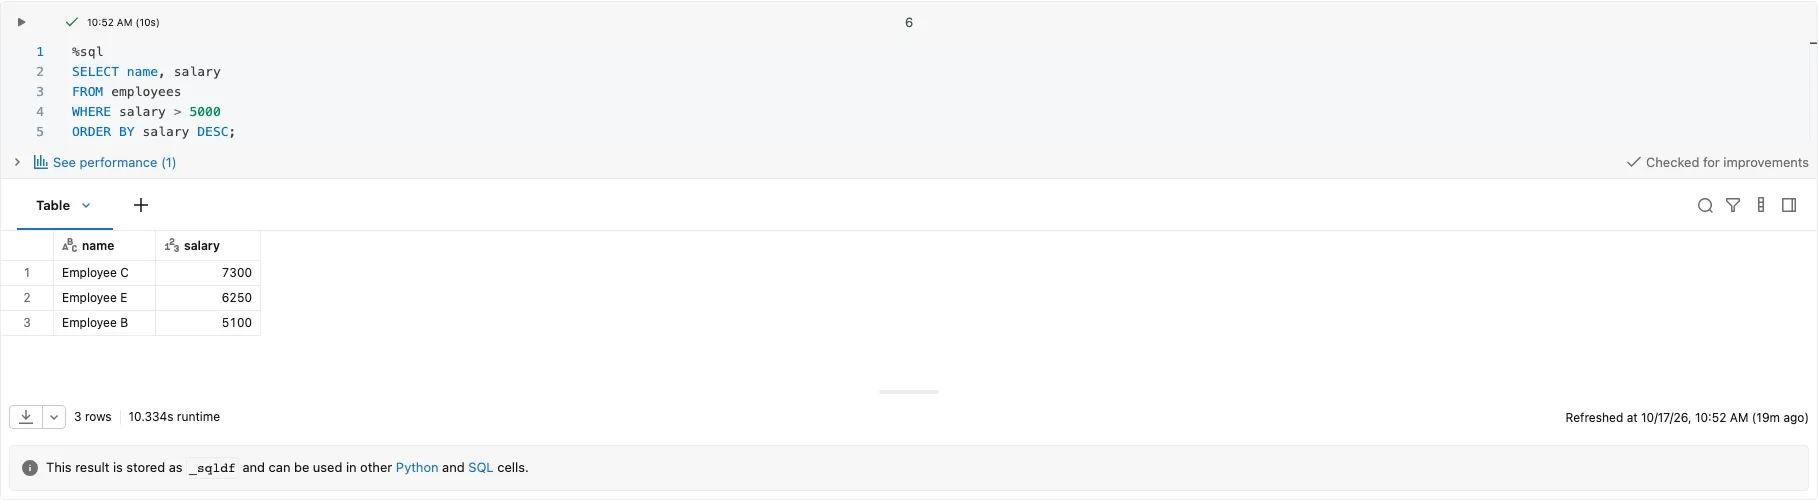
Wynik z labu: zapytanie z filtrem WHERE salary > 5000 w notebooku.
Trochę historii, bo pomaga zrozumieć skalę. SQL ma ponad 50 lat i w tym czasie przeżył kilka fal, które miały go zastąpić:
- 1970 – Edgar F. Codd z IBM publikuje „A Relational Model of Data for Large Shared Data Banks”. Dane trzymamy w tabelach (relacjach), a zapytanie opisuje wynik, a nie drogę do danych. To jest początek podejścia „co, a nie jak”.
- 1974 – Donald Chamberlin i Raymond Boyce opisują w IBM język SEQUEL. Później nazwę skrócono do SQL, bo „SEQUEL” był już znakiem towarowym innej firmy.
- 1979 – Relational Software (późniejszy Oracle) wypuszcza Oracle V2, jedną z pierwszych komercyjnych baz z SQL-em. IBM swój SQL/DS sprzedaje dopiero od 1981 roku.
- 1986–1987 – ANSI i ISO standaryzują język (SQL-86). Od tego momentu SQL nie należy do jednej firmy.
- 1992 – SQL-92 dodaje między innymi
JOIN ... ON,CASEiCAST. Tę wersję w dużej części zna dziś każda baza. - 1999 – SQL:1999 dostaje zapytania rekurencyjne (
WITH RECURSIVE) i triggery. - 2003 – SQL:2003 wprowadza do standardu funkcje okna (
ROW_NUMBER() OVER (...)) iMERGE. - 2009 – pojawia się hasło NoSQL i pierwsze głośne zapowiedzi końca SQL-a.
- 2014 – Spark SQL: SQL wraca do Big Data, tym razem na rozproszonym silniku.
- 2016 – SQL:2016 dodaje obsługę JSON, czyli odpowiedź na bazy dokumentowe.
- 2023 – SQL:2023 dostaje zapytania do grafów (SQL/PGQ) i typ JSON, a pgvector, czyli wektory w PostgreSQL, trafia do zarządzanych baz u dużych dostawców chmury. Dwa lata później SQL Server 2025 ma już natywny typ
VECTOR.
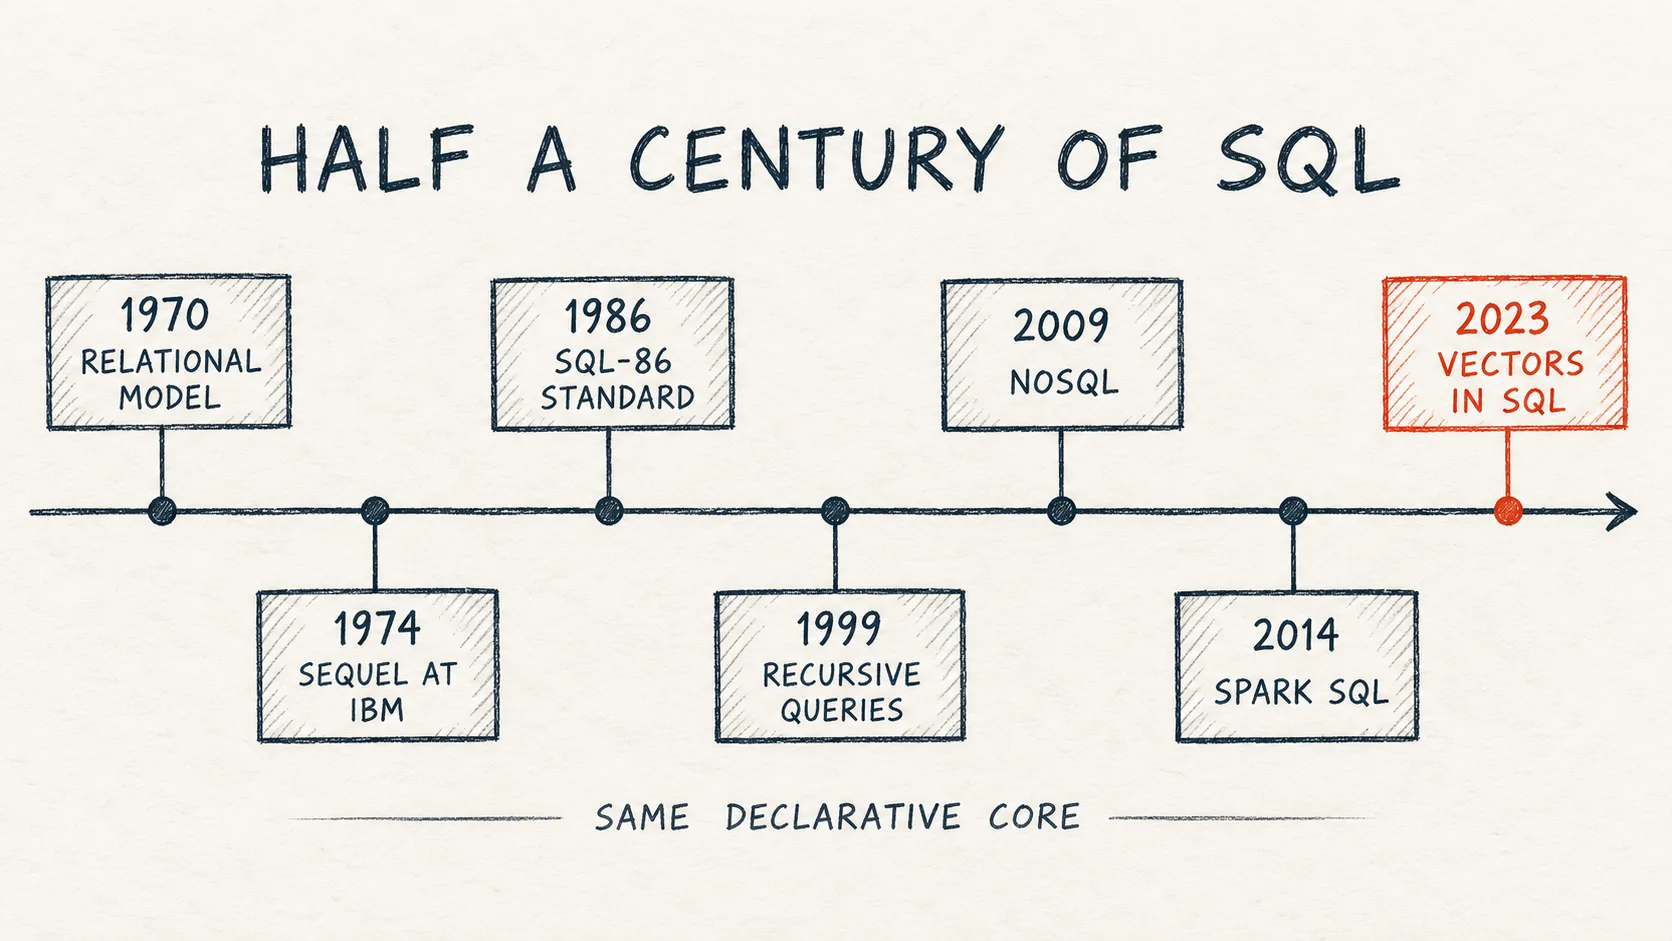
Na tej osi dobrze widać rytm: co kilka lat pojawia się coś, co ma zastąpić SQL, a kilka lat później to samo trafia do SQL-a jako nowa funkcja albo nowy typ danych.
Do tego nie jest to język niszowy. W ankiecie Stack Overflow Developer Survey 2023 SQL-a używało 51,52% zawodowych deweloperów (48,66% wszystkich respondentów).
Cztery mutacje
Najciekawsze jest to, co działo się z SQL-em, gdy pojawiała się technologia, która miała go „zabić”.
| Era | Co się pojawiło | Jak zareagował SQL |
|---|---|---|
| Relacyjna | tabele, ACID, klucze obce | SQL jako język zapytań do relacji |
| NoSQL | dokumenty, JSON | JSONB w PostgreSQL, funkcje JSON w SQL Server |
| Big Data | rozproszone przetwarzanie, pliki w data lake | Spark SQL, Presto, BigQuery, Snowflake |
| AI | embeddingi, wyszukiwanie semantyczne | typy wektorowe, funkcje AI i wyszukiwanie wektorowe wołane z SQL |
Na prelekcji podsumowałem to zdaniem, które lubię najbardziej z całego decku: „Każda era nie zastąpiła poprzedniej – rozszerzyła ją.” Relacyjne bazy nadal obsługują transakcje, hurtownie analitykę, lakehouse data science, a wektory AI. Ewolucja idzie przez specjalizację, a SQL zostaje wspólnym językiem na górze.
Dobrze to widać na przykładzie wektorów. Na slajdzie „Giganci nie czekali” pokazywałem, że PostgreSQL dostał rozszerzenie pgvector, a SQL Server 2025 natywny typ VECTOR. Zamiast przenosić dane do osobnej bazy wektorowej, możemy dodać kolumnę z embeddingami obok istniejących tabel.
Poprawka do mojego własnego slajdu: funkcja do generowania embeddingów w SQL Server 2025 nazywa się AI_GENERATE_EMBEDDINGS, a nie GENERATE_EMBEDDING. W skryptach demo była poprawna nazwa, na slajdzie nie.
Mutuje nie tylko to, co SQL obsługuje, ale też sama składnia. Na Databricks od DBR 16.2 możemy pisać zapytania jako potok (pipe syntax): zaczynamy od FROM, a filtr, sortowanie czy agregację dokładamy po kolei po operatorze |>, w takiej kolejności, w jakiej dane przechodzą przez zapytanie. Od DBR 16.3 jest SQL scripting, a od 17.0 procedury składowane. Język, który miał umrzeć, dostaje nowe konstrukcje co kilka wydań runtime'u.
Jak ta mutacja wygląda na Databricks
W Databricks SQL wyszukiwanie semantyczne jest kolejną funkcją w klauzuli FROM. Nie musimy sami liczyć wektora pytania, bo przy indeksie Delta Sync z managed embeddings robi to za nas endpoint embeddingów (przy każdym zapytaniu, więc to nie jest darmowy SELECT). Z query_type => 'HYBRID' ta sama funkcja łączy wyszukiwanie po słowach i po znaczeniu.
W demo notebook przygotowuje wszystko sam: tabelę coffee_tips z ośmioma krótkimi poradami (o kawie, ale też o herbacie i odkamienianiu czajnika), endpoint AI Search i indeks Delta Sync, w którym embeddingi liczy model databricks-gte-large-en. Potem zadajemy pytanie zwykłym tekstem:
✓ Sprawdzone na Free Edition (2026-10-17): cały notebook, z endpointem i indeksem (na Free Edition jest jeden endpoint AI Search na workspace)
SELECT *
FROM vector_search(
  index => 'workspace.dataistheway.coffee_tips_index',
  query_text => 'how to brew coffee properly',
  num_results => 3
);
W notebooku nazwa indeksu bierze się z widżetów catalog i schema (domyślnie workspace.dataistheway, czyli tak jak wyżej). Film nagrałem na naszym workspace'ie, gdzie katalog nazywa się dataistheway.
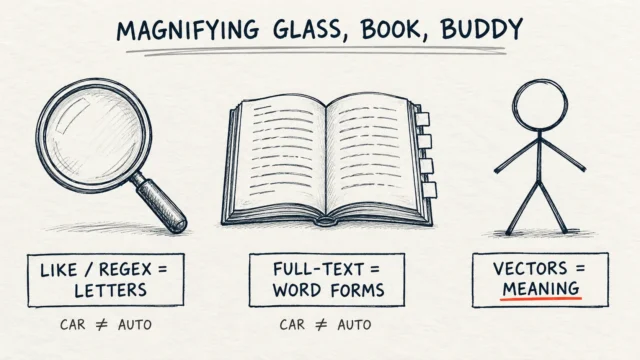
Wróciły trzy porady: o French pressie (grube mielenie i około czterech minut parzenia), o trzymaniu ziaren w szczelnym pojemniku i o ważeniu kawy (około 60 g na litr wody). Żadna z nich nie zawiera słów „brew” ani „properly”, więc WHERE tip LIKE '%brew%' nie znalazłby niczego. Porady o herbacie i czajniku do wyniku nie weszły. Wyniki podobieństwa (search_score) były blisko siebie, od 0,602 do 0,620, więc przy ośmiu wierszach nie wyciągałbym wniosków z samej kolejności.
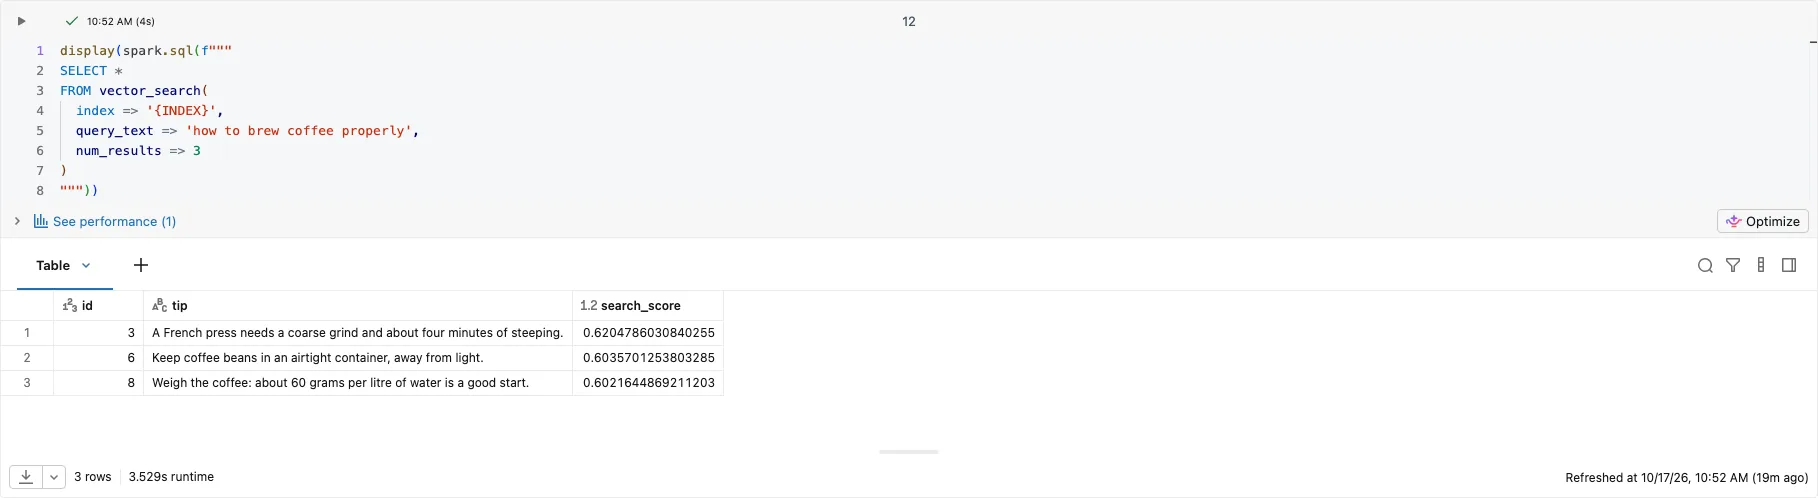
Wynik z labu: trzy najbliższe porady i ich search_score.
vector_search() jest w Public Preview, query_text działa od DBR 15.3, a funkcja nie działa na classic SQL warehouse. num_results może wynosić najwyżej 100.
To nadal jest SELECT. Zmieniło się to, co dzieje się pod spodem: zamiast porównywać litery, porównujemy znaczenia. Czym różnią się LIKE, full-text i wektory, opisuję w tekście „Lupa, książka i kumpel”.
Pułapki
- Endpoint kosztuje przez cały czas działania, a nie tylko przy zapytaniach. Dlatego notebook na końcu usuwa indeks i endpoint. Jeśli przerwiemy notebook w połowie, endpoint trzeba usunąć samemu.
- Indeks czeka na endpoint. Samo przygotowanie indeksu trwało u mnie około 20 minut, bo indeks czekał na uruchomienie endpointu.
- Drugie uruchomienie zaraz po pierwszym. Usuwanie endpointu też trwa (u mnie około 15 minut). Do tego czasu utworzenie endpointu o tej samej nazwie kończy się błędem
AlreadyExists, więc trzeba poczekać albo zmienić nazwę endpointu (ENDPOINTw notebooku).
AI bez danych to puste pudełko
Druga teza z prelekcji jest dla mnie ważniejsza niż pierwsza: „AI bez danych to puste pudełko.”
Najlepszy model językowy nie wie, jakie mamy produkty, kim są nasi klienci i co wydarzyło się wczoraj w systemie sprzedaży. Może tylko zgadywać. Z drugiej strony mamy petabajty danych, idealnie ułożonych w tabelach, ale klasyczne zapytanie wymaga znajomości struktury, a full-text search szuka słów, nie znaczeń. Pytania „co nasi klienci myślą o produkcie X?” nie zadamy w samym WHERE.
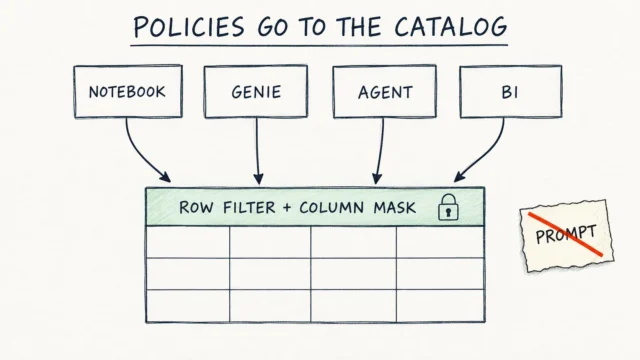
Dlatego nie widzę tu konkurencji. RAG, agenci i Genie potrzebują danych, które ktoś wcześniej zamodelował, oczyścił i opisał. Przy przygotowaniu warsztatu z agentów AI, który rok później poprowadziliśmy z Mariuszem Wiechą, sporo problemów nie leżało w modelu, tylko właśnie w danych: w zdublowanych wierszach klientów, w niejasnej definicji miary, w uprawnieniach, które znikały po odtworzeniu funkcji (więcej o tym w tekście „Polityki idą do katalogu, nie do promptu”). To jest ten obszar, w którym ludzie od SQL-a czują się najpewniej.
Od 2009 roku co kilka lat ktoś wieszczy śmierć SQL-a. A dziś mamy Spark SQL, a z poziomu SQL-a wołamy nawet modele AI.
Co z tego wynika w praktyce
Kilka rzeczy, które sam robię i polecam osobom z zespołów danych:
- Nie porzucajmy SQL-a na rzecz „samego AI”. Jeśli agent albo Genie generuje zapytanie, ktoś musi umieć je przeczytać i ocenić, czy liczy to, co trzeba.
- Uczmy się nowych funkcji w starym języku.
ai_query, funkcje AI i wyszukiwanie wektorowe na Databricks wołamy z SQL. Próg wejścia jest niski, bo składnia jest znana. Niski próg ma jednak drugą stronę: funkcja AI wSELECTwoła model dla każdego wiersza. Na produkcji o tym, kto może wołać jaki model i za ile, decydujemy w Unity Gateway, a nie w zapytaniu. - Dbajmy o semantykę danych. Komentarze na tabelach i kolumnach, definicje miar, jasne nazwy. To z nich korzystają Genie Agents (dawniej Genie spaces) i nasi agenci.
- Wybierajmy metodę do problemu.
LIKEi regex nadal są najlepsze, gdy znamy wzorzec (kod produktu, e-mail). Wektory mają sens, gdy szukamy intencji.
Jeśli mam polecić jedną rzecz na jutro: weźmy jedną tabelę, której używa zespół, i dopiszmy komentarze do kolumn. Od tego zależy, czy Genie i agenci w ogóle zrozumieją dane.
Czego ta teza nie mówi
„SQL nie umiera” nie znaczy, że wszystko należy robić w SQL. Model ML trenujemy w Pythonie, agenta składamy w kodzie, a nie w procedurze składowanej. Nie znaczy też, że SQL sam z siebie rozumie znaczenie. Rozumie je model embeddingów, a SQL daje do niego wygodny interfejs. I wreszcie: to, że SQL przetrwał dotąd, nie jest gwarancją na zawsze. To zależy :) Na razie jednak każda fala nowości kończyła się tym samym: nowym typem danych i nowymi funkcjami w znanym języku.
Zobacz, jak to działa
Na nagraniu cały notebook z labu, od zapytania SELECT do vector_search() i sprzątania. Czekanie na indeks jest przyspieszone 8×.
Kod z tego artykułu na GitHubie →notebook i README krok po kroku · sql-isnt-dying-its-mutating
Podsumowanie
Na zamknięcie prelekcji użyłem zdania, które dobrze streszcza całą serię:
„Struktura bez semantyki to martwe dane. Semantyka bez struktury to chaos.”
- SQL przetrwał, bo oddziela „co” od „jak”, więc pod spodem można wymienić silnik.
- Każda era rozszerzyła poprzednią: JSON, Big Data, a teraz wektory i AI.
- AI potrzebuje danych, a dane potrzebują ludzi, którzy je rozumieją.
Dalej: „Lupa, książka i kumpel: LIKE, full-text i wektory po ludzku”.
Chcesz kolejne wpisy? Obserwuj przez RSS albo na LinkedInie.
Komentarze
Na razie cisza na szlaku. Napisz pierwszy komentarz.