
 Krzysztof Burejza
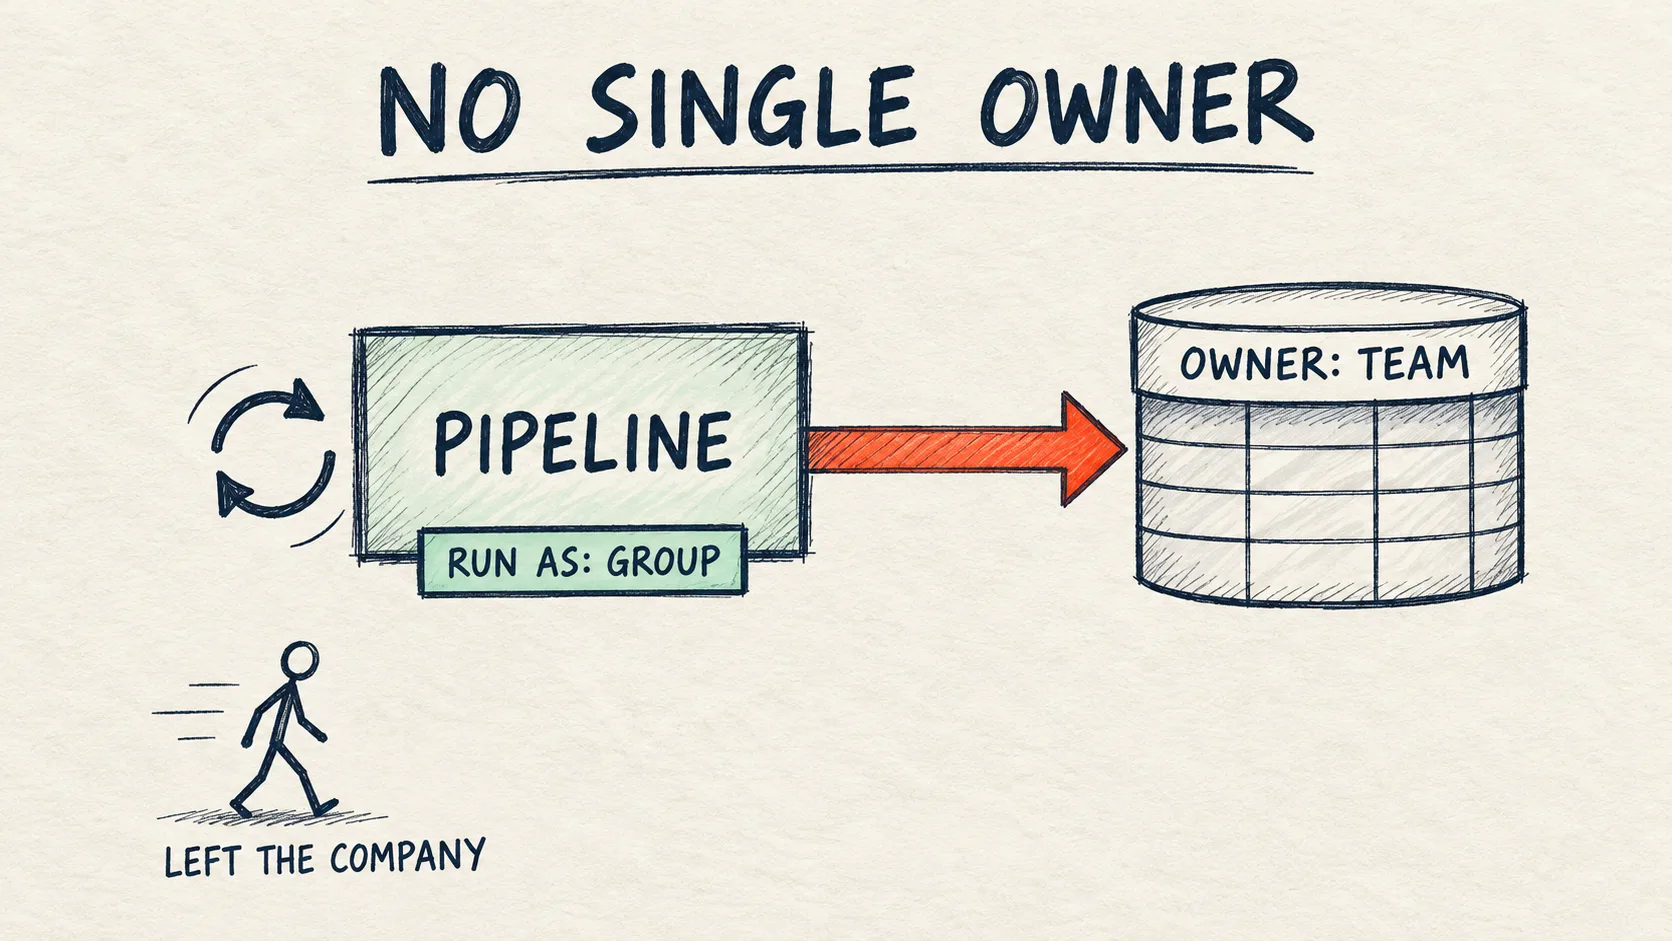
run_as (API ignoruje updated_run_as), właściciel tabel zmienia się od razu razem z run-as, a ręcznej zmiany run-as kolejny deploy bundla nie cofa.Problem
Pipeline domyślnie działa jako osoba, która go utworzyła. Dokumentacja wprost opisuje, co się dzieje, gdy ta osoba odejdzie z firmy i jej konto zostanie wyłączone: pipeline może przestać działać, a tabele, które opublikował, mogą stać się niedostępne dla innych. W projektach często widzę pipeline'y produkcyjne, które „należą” do kogoś, kto dawno zmienił zespół.
Do tej pory alternatywą był service principal. Teraz doszła trzecia opcja: grupa konta. To druga z dwóch zmian Lakeflow z tego samego dnia. O pierwszej, czyli kilku triggerach na jednym jobie, pisałem w artykule Lakeflow Jobs: kilka triggerów na jednym jobie.
Jak to działa
Run-as pipeline'u może być teraz grupą konta, obok użytkownika i service principala. Aktualizacje działają z uprawnieniami grupy, a w pipeline'ach Unity Catalog właścicielem opublikowanych tabel jest grupa. Release note nie oznacza tej funkcji jako Preview ani Beta.
Kontekst z RBAC: rola w Databricks to zwykła grupa konta, więc pipeline z run-as ustawionym na grupę działa po prostu jako ta rola.
Grupa czy service principal? Dokumentacja dalej nazywa service principal najlepszą praktyką dla automatyzacji. Grupa ma sens, gdy pipeline ma należeć do zespołu zamiast do technicznego konta: tabele są wtedy własnością zespołu, a zmiana składu zespołu nic nie psuje. Ceną jest to, że uprawnienia nadane grupie dla pipeline'u dostaje każdy jej członek (więcej w „Kiedy NIE używać”).
Warunki z dokumentacji:
- Grupa konta przypisana do workspace'u. Grupy lokalne workspace'u nie działają, tak samo jak wbudowane
admins,usersiaccount users. - Kto ustawia: członek grupy albo ktoś z uprawnieniem Assume na grupie (przy rolach z wyłącznym dostępem). Do tego CAN_MANAGE na pipeline'ie. Przy wdrożeniu z CI/CD tym „kimś” jest service principal pipeline'u wdrożeniowego. Musi być członkiem grupy albo mieć na niej Assume, a członkostwo daje mu też wszystkie uprawnienia grupy do danych.
- Grupa potrzebuje wszystkiego, czego potrzebuje pipeline: entitlement Workspace access, Can read na plikach i notebookach z kodem,
USE CATALOG,USE SCHEMAiCREATE TABLEna schemacie docelowym,CREATE SCHEMA, jeśli pipeline tworzy schematy,MODIFYna istniejących tabelach, które pipeline aktualizuje, oraz dostęp do źródeł. Dokumentacja wymienia też Can use na cluster policy pipeline'u i prawo do tworzenia compute. Na labie był serverless, a grupa miała z entitlementów tylko Workspace access i aktualizacja przeszła. Dokumentacja podkreśla, że nadanie tych uprawnień sobie nic nie daje, bo aktualizacja działa jako grupa. Które z nich są naprawdę potrzebne, sprawdziłem macierzą (w pułapkach). - Run-as i właściciel pipeline'u to osobne ustawienia. Zmiana run-as na grupę nie zmienia właściciela pipeline'u.
W REST API przy tworzeniu pipeline'u ustawiamy run_as.group_name. Tak wygląda pipeline z notebooka do tego artykułu (kod pipeline'u to jeden materialized view w pliku SQL):
pipeline = {
    "name": "dataistheway_etl",
    "catalog": catalog,
    "schema": schema,
    "serverless": True,
    "libraries": [{"file": {"path": PIPE_DIR + "/mv_total_by_country.sql"}}],
    "run_as": {"group_name": GROUP},
}
pid = api.do("POST", "/api/2.0/pipelines", body=pipeline)["pipeline_id"]
print("run_as_user_name:", api.do("GET", f"/api/2.0/pipelines/{pid}")["run_as_user_name"])

def run_update():
    t0 = time.time()
    uid = api.do("POST", f"/api/2.0/pipelines/{pid}/updates", body={})["update_id"]
    while True:
        st = api.do("GET", f"/api/2.0/pipelines/{pid}/updates/{uid}")["update"]["state"]
        if st in ("COMPLETED", "FAILED", "CANCELED"):
            return f"{st} ({time.time() - t0:.0f} s)"
        time.sleep(10)

print("update as the group:", run_update())
✓ Sprawdzone na Free Edition (2026-10-17): kroki 1–7 z notebooka przechodzą, ale krok 3 uruchomiony zaraz po założeniu grupy skończył się błędem członkostwa i przeszedł dopiero po kilku minutach (opis w pułapkach). Wymaga Unity Catalog i serverless.
Przy edycji istniejącego pipeline'u (PUT /api/2.0/pipelines/{pipeline_id}) dokumentacja każe użyć pola updated_run_as. Tu lab pokazał pierwszą rozbieżność. Notebook próbuje obu pól po kolei:
spec = api.do("GET", f"/api/2.0/pipelines/{pid}")["spec"]
try:
    api.do("PUT", f"/api/2.0/pipelines/{pid}", body={**spec, "updated_run_as": {"user_name": me.user_name}})
    print("updated_run_as accepted")
except Exception as e:
    print("updated_run_as:", str(e).splitlines()[0])

api.do("PUT", f"/api/2.0/pipelines/{pid}", body={**spec, "run_as": {"user_name": me.user_name}})
print("run_as_user_name:", api.do("GET", f"/api/2.0/pipelines/{pid}")["run_as_user_name"])
✓ Sprawdzone na Free Edition (2026-10-17): ten sam wynik, updated_run_as odrzucone, run_as przyjęte.
Na labie PUT z pełną specyfikacją i samym updated_run_as (bez run_as) API odrzuciło tak, jakby run-as miał zostać wyczyszczony:
Once configured, run_as of the pipeline can not be set to null.
Please set run_as to dataistheway-etl-team to preserve the pipeline's run_as
Ten sam PUT z run_as: {"user_name": ...} przeszedł, a run_as_user_name od razu pokazał mój login.
Skąd ten błąd, sprawdziłem osobno na pipeline'ie z run-as ustawionym na service principal labu. GET /api/2.0/pipelines/{pipeline_id} zwraca spec bez pola run_as (tożsamość widać tylko w run_as_user_name). PUT zastępuje całą definicję, więc body zbudowane z tej odpowiedzi API traktuje jak wyczyszczenie run-as. Tym samym błędem skończył się nawet PUT, który zmieniał tylko nazwę pipeline'u. Samo updated_run_as, nawet z tą samą tożsamością, nie zastępuje run_as, a body z oboma polami przeszło. Sprawdziłem też updated_run_as z inną tożsamością niż run_as. API przyjęło oba body, ale o wyniku zawsze decydował run_as: run_as = grupa i updated_run_as = service principal zostawiło grupę, a odwrotnie ustawiło service principala. updated_run_as jest więc po prostu ignorowane. Wniosek praktyczny: każdy PUT pipeline'u z ustawionym run-as musi zawierać run_as, także skrypt, który zmienia coś zupełnie innego. Po zmianie odczytujemy run_as_user_name.
W Declarative Automation Bundles (dawniej Databricks Asset Bundles) według dokumentacji ustawiamy group_name w mapowaniu run_as zasobu pipeline'u. Druga rozbieżność: w schemacie bundli z Databricks CLI v1.16.1 definicja pipelines.RunAs ma tylko user_name i service_principal_name, a group_name jest w niej tylko dla jobów (jobs.JobRunAs, opisane jako Private Preview). Sprawdziłem to na labie na małym bundle'u: databricks bundle validate w CLI v1.16.1 zgłasza ostrzeżenie unknown field: group_name przy resources.pipelines.<klucz>.run_as, a w rozwiązanej konfiguracji zostaje pusty run_as. bundle deploy tą wersją nie przechodzi: CLI wysyła pusty obiekt, a API odrzuca utworzenie pipeline'u błędem run_as object must have user_name, service_principal_name or group_name fields filled. Pipeline nie powstaje, ale pliki bundla zdążą się wgrać do workspace'u. W schemacie CLI group_name pojawia się w pipelines.RunAs od v1.18.0 (w v1.17.0 go nie ma), a w v1.20.0 validate nie zgłasza już ostrzeżenia, a deploy z grupą przechodzi (niżej). Od v1.20.0 bundle wdraża się tylko silnikiem direct, bo silnik Terraform został usunięty z CLI. Uwaga: schemat, także w v1.20.0, nadal oznacza to pole dla pipeline'ów jako Private Preview.
Przy bundle'u są jeszcze dwie rzeczy, o które zespół potknie się najpierw. Pierwsza to poziom YAML-a: grupę ustawiamy w run_as samego zasobu (resources.pipelines.<klucz>.run_as). Według strony o run identity run_as na poziomie bundle'a i targetu przyjmuje tylko user_name albo service_principal_name, choć changelog CLI v1.20.0 mówi o obsłudze group_name także tam, więc dokumentacja jest tu niespójna. Druga to miejsce kodu, bo grupa musi go czytać. Dokumentacja jobów każe ustawić workspace.root_path na folder pod /Workspace/Shared/ i nadać grupie CAN VIEW. Na labie sprawdziłem oba warianty, z tą samą sekcją permissions (grupa z CAN_VIEW) na górze bundla:
root_pathpod/Workspace/Shared/: CLI (v1.16.1 i v1.20.0) ostrzega przyvalidateideploy, że folder bundla jest zapisywalny dla wszystkich użytkowników workspace'u, bo dziedziczyCAN_MANAGEdlausers. Sekcjapermissionstrafiła tylko na pipeline, a na folderze grupa nie dostała żadnego wpisu. Aktualizacja jako grupa i tak przeszła. Kod, który działa z uprawnieniami grupy, może jednak podmienić każdy.- Domyślny folder (bez
root_path): pliki lądują w home folderze tożsamości, która robi deploy. CLI nadał grupieCAN_READna tym folderze, a pisać mogą tylko deployer i admini. Aktualizacja jako grupa przeszła.
Dlatego zostawiam folder domyślny. W CI to home folder service principala, więc kod pipeline'u zmienia tylko wdrożenie. Ten plik wdrożyłem i uruchomiłem na labie:
# A pipeline that runs as an account group (run_as.group_name).
# Tested on Databricks CLI v1.20.0 (the field has been in the schema since v1.18.0).
bundle:
  name: run_as_group_demo

variables:
  catalog:
    default: workspace
  schema:
    default: dataistheway_run_as
  group_name:
    default: dataistheway-etl-team

# No workspace.root_path: the code stays in the home folder of whoever deploys
# (in CI: the service principal), so other users can't change it.
# These permissions give the group CAN_VIEW on the pipeline and Can read on that folder.
permissions:
  - level: CAN_VIEW
    group_name: ${var.group_name}

resources:
  pipelines:
    etl:
      name: dataistheway_etl_bundle
      catalog: ${var.catalog}
      schema: ${var.schema}
      serverless: true
      libraries:
        - file:
            path: ./src/mv_total_by_country.sql
      run_as:
        group_name: ${var.group_name}

targets:
  dev:
    default: true
✓ Sprawdzone na Free Edition (2026-10-19): deploy i run tego bundla z grupą przechodzą, MV należy do grupy. Bundle sprawdziłem na CLI v1.20.0. Pole group_name jest w schemacie od v1.18.0, ale deployu na 1.18 i 1.19 nie sprawdzałem.
Przed deployem grupa konta musi być przypisana do workspace'u, tożsamość, która robi deploy, musi być jej członkiem, a grupa musi mieć granty z macierzy niżej. Tabela źródłowa source_orders musi już istnieć w schemacie. Bundle uruchamiamy zwykłymi komendami, a zmienne (catalog, schema, group_name) podajemy w zmiennych środowiskowych BUNDLE_VAR_catalog, BUNDLE_VAR_schema i BUNDLE_VAR_group_name: databricks bundle deploy, potem databricks bundle run etl. Na labie bundle szedł na katalog dataistheway, schemat news135_runas i grupę news135-etl-team (tej samej grupy używał notebook na Free Edition), stąd te nazwy w wynikach i błędach niżej. Na labie bundle deploy utworzył pipeline i jego uprawnienia (Resources: 2 created), run_as_user_name pokazał news135-etl-team, a aktualizacja z bundle run etl skończyła się COMPLETED w ok. 40 s. Właścicielem mv_total_by_country jest grupa, a source_orders należy do service principala, który ją utworzył.
Dryf sprawdziłem tak: po deployu przełączyłem run-as przez API na service principala. Właściciel MV od razu zmienił się na service principala. bundle plan pokazał potem 0 to change, 2 unchanged, a kolejny bundle deploy nic nie zmienił: run-as i właściciel tabel zostały przy service principalu. Grupa wróciła dopiero przy deployu, który zmieniał coś w definicji pipeline'u (na próbę dodałem development: true), bo wtedy CLI wysyła całą definicję razem z run_as. Ręcznej zmiany run-as kolejny deploy więc nie cofnie, dopóki ktoś nie zmieni pipeline'u w bundlu. Dokumentacja silnika direct mówi, że kolejny plan albo deploy aktualizuje zasoby zmienione poza bundlem. Przy run-as na labie tak nie było. Najpewniej dlatego, że GET pipeline'u nie zwraca run_as (opis wyżej), więc CLI nie ma z czym porównać. Dlatego po każdym deployu w CI odczytuję run_as_user_name i przerywam wdrożenie, jeśli to nie jest grupa.
Joby też mogą działać jako grupa. Dokumentacja opisuje Run as = grupa dla jobów bez etykiety Preview, a od CLI v1.18.0 schemat bundli oznacza group_name dla jobów jako GA.
Krok po kroku: demo na labie
Notebook pipeline_run_as_group.py robi wszystko przez REST API z poziomu notebooka, na serverless. Uruchamiamy go jako admin workspace'u, bo zakłada grupę konta. Obok jest folder pipeline/ z kodem pipeline'u. Na początku notebook tworzy tabelę źródłową source_orders (5 wierszy).
- Zakłada grupę konta
dataistheway-etl-teamz nami jako członkiem, przypisuje ją do workspace'u (/api/2.0/preview/permissionassignments/principals/{id},USER) i nadaje entitlementworkspace-access. - Nadaje grupie
USE CATALOGoraz na schemacieUSE SCHEMA,CREATE TABLE,CREATE MATERIALIZED VIEW,SELECTiMODIFY, a także Can read na folderze z kodem pipeline'u. - Tworzy serverless pipeline
dataistheway_etlzrun_as.group_namei uruchamia aktualizację. - Pokazuje
table_ownerzinformation_schema.tables. - Próbuje utworzyć pipeline z
run_as.group_namerównymusers. - Przełącza run-as z powrotem na nas: najpierw
updated_run_as, potemrun_as, i od razu sprawdza właściciela MV. - Próbuje
ALTER MATERIALIZED VIEW ... SET OWNER TOgrupa.
Na końcu notebook usuwa pipeline z cascade=true, tabelę, granty i grupę.
Wyniki z labu (Azure Databricks Premium, trial, cały notebook około dwóch minut, w tym dwie 40-sekundowe pauzy na pokazanie UI w nagraniu):
- Krok 1–2: grupa konta powstała, a przypisanie do workspace'u, entitlement i granty przeszły bez błędu.
- Krok 3: pipeline z
run_as.group_namepowstał od razu,run_as_user_name=dataistheway-etl-team. Aktualizacja jako grupa:COMPLETEDw 32 s. - Krok 4:
mv_total_by_countryma właścicieladataistheway-etl-team, asource_orders, utworzona przeze mnie w notebooku, należy do mnie. - Krok 5:
usersodrzucone (treść błędu niżej w pułapkach). - Krok 6:
updated_run_asodrzucone,run_asprzyjęte. Właścicielmv_total_by_countryzmienił się na mnie zaraz po zmianie ustawień, bez nowej aktualizacji. - Krok 7:
SET OWNER TOgrupa skończyło się błędemCHANGE_OWNER_NOT_ALLOWED_FOR_PIPELINE_TABLE.
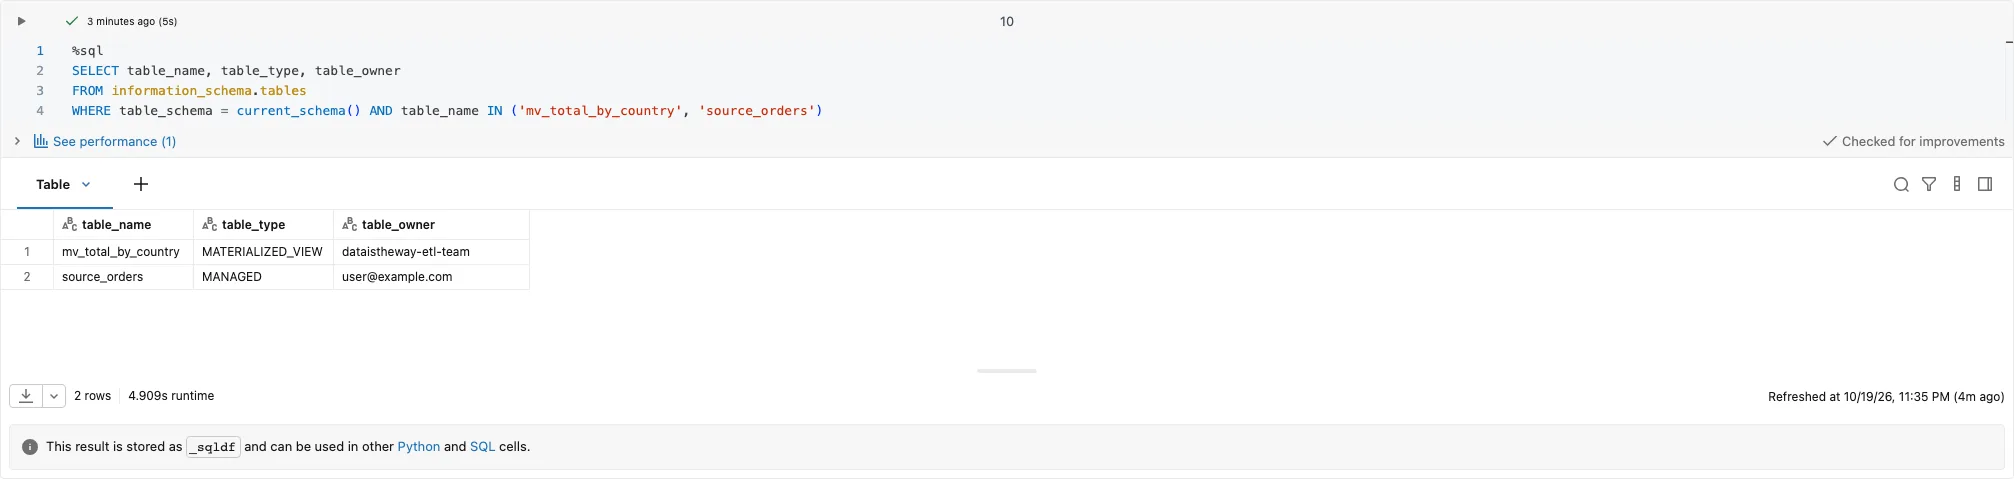
Wynik z labu: MV z pipeline'u należy do grupy, tabela źródłowa do mnie.
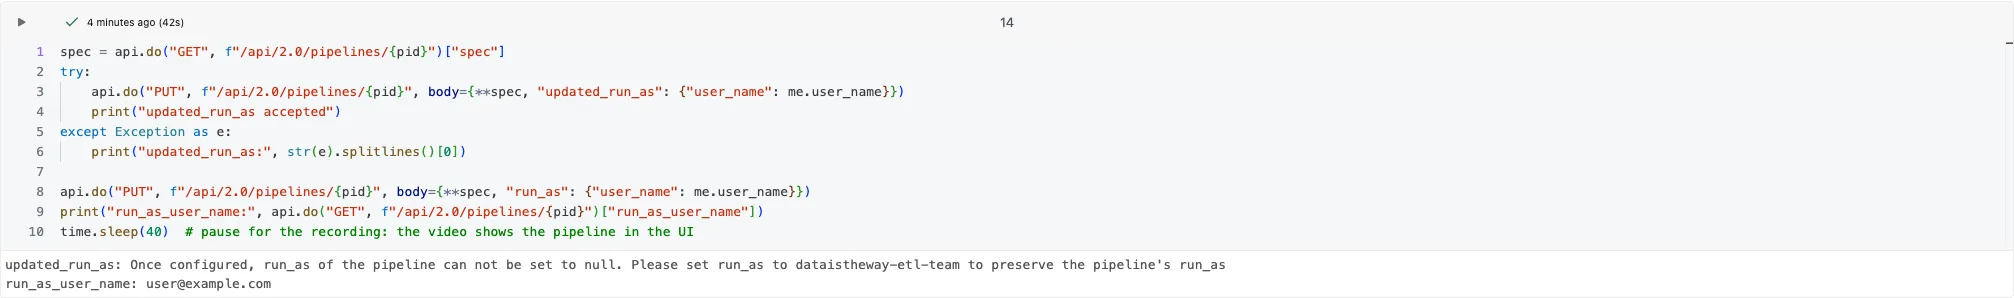
Wynik z labu: updated_run_as odrzucone, run_as przyjęte.
Pułapki
- Wbudowane grupy odpadają.
admins,usersiaccount usersnie mogą być run-as pipeline'u, tak samo jak grupy lokalne workspace'u. Na labie endpoint pipeline'ów zwrócił:The group 'users' cannot be used as a run-as identity for jobs. Broad groups such as 'account users', 'admins', and 'users' are not allowed.Komunikat mówi o jobach, choć dotyczy pipeline'u, więc nie dajmy się zmylić. Free Edition zwraca ten sam komunikat. - „Group does not exist” nie zawsze znaczy literówkę. Grupa konta, która nie jest przypisana do workspace'u, daje przy deployu bundle'a ten sam błąd co grupa, której nie ma wcale:
'<grupa>' cannot be set as run_as because the group does not exist. Zanim zaczniemy szukać literówki, sprawdzamy przypisanie grupy do workspace'u. - Świeżo utworzona grupa może jeszcze „nie znać” swoich członków. Na Free Edition krok 3 zaraz po kroku 1 skończył się błędem
Cannot bind the group provided in 'run_as' field (news135-etl-team) to the pipeline. The user creating or updating the pipeline must be a member of the group or have 'Can Assume' permission on the group., choć byłem w tej grupie od jej utworzenia. Ten sam POST kilka minut później przeszedł. Na labie Premium krok 3 przeszedł od razu. Jeśli skrypt zakłada grupę i od razu tworzy pipeline, ten błąd może oznaczać opóźnienie, a nie brak członkostwa. - Grupa potrzebuje swoich grantów, ale nie wszystkich, które się wymienia. Nasze granty nie pomagają, bo aktualizacja działa jako grupa. Na labie zabierałem grupie po jednym uprawnieniu i uruchamiałem pipeline z bundla w dwóch sytuacjach: pierwsza aktualizacja (MV jeszcze nie ma) i odświeżenie istniejącego MV.
| Bez uprawnienia | Pierwsza aktualizacja | Odświeżenie MV | Błąd |
|---|---|---|---|
USE CATALOG |
deploy nie tworzy pipeline'u | aktualizacja nie startuje | przy deployu Principal 'news135-etl-team' does not have USE CATALOG on Catalog 'dataistheway'. (403 PERMISSION_DENIED), przy starcie User does not have USE CATALOG on Catalog 'dataistheway'. |
USE SCHEMA |
FAILED | FAILED | The pipeline's run-as identity 'news135-etl-team' does not have permissions on 'dataistheway.news135_runas'. Details: User does not have USE SCHEMA on Schema 'dataistheway.news135_runas'. |
CREATE TABLE |
FAILED | FAILED | The pipeline's run-as identity 'news135-etl-team' does not have permission to create table in schema dataistheway.news135_runas |
CREATE MATERIALIZED VIEW |
FAILED | COMPLETED | Principal 'news135-etl-team' does not have CREATE MATERIALIZED VIEW on Schema 'dataistheway.news135_runas'. |
SELECT |
FAILED | FAILED | [INSUFFICIENT_PERMISSIONS] Insufficient privileges: Principal 'news135-etl-team' does not have SELECT on Table 'dataistheway.news135_runas.source_orders'. |
MODIFY |
COMPLETED | COMPLETED | – |
| Can read na folderze z kodem | nie sprawdzałem | FAILED | [LIBRARY_FILE_NOT_FOUND] File '.../files/src/mv_total_by_country.sql' was not found or the run_as user does not have permissions to access it. |
Granty na schemacie (USE SCHEMA, CREATE TABLE, CREATE MATERIALIZED VIEW, SELECT, MODIFY) zabierałem na poziomie schematu. Dla MV z pipeline'u wystarczyły więc USE CATALOG, USE SCHEMA, CREATE TABLE, CREATE MATERIALIZED VIEW (tylko przy tworzeniu), SELECT na źródle i Can read na kodzie. MODIFY nie był potrzebny ani przy tworzeniu, ani przy odświeżeniu, a końcowy przebieg bundla przeszedł bez niego. CREATE TABLE jest potrzebne nawet przy odświeżeniu. Błędy nazywają run-as grupy wprost, z wyjątkiem braku Can read, który wygląda jak brak pliku. Entitlementu Workspace access nie sprawdzałem, bo service principal labu nie może go zdjąć grupie, a na czas testu nie dodajemy go do admins. Ten entitlement ma znaczenie od 14 września 2026, kiedy grupa users straciła entitlements, a nowym principalom nadaje się je jawnie.
- Właściciel pipeline'u i run-as to dwie różne rzeczy. Po zmianie run-as na grupę właścicielem pipeline'u dalej jest ta sama osoba. Tabele należą do grupy, ale sam pipeline nie. Właściciela zmieniamy osobno. Najprościej, gdy pipeline wdraża bundle z CI/CD na service principalu: wtedy właścicielem pipeline'u jest ten SP, a run-as to grupa, i ani jedno, ani drugie nie zależy od konkretnej osoby. W demo pipeline powstaje z mojego konta, więc w filmie widać właśnie stan „Owner = osoba”.
- Właściciel tabel idzie za run-as, i to od razu. Na labie po przełączeniu run-as z grupy na mnie właściciel MV zmienił się zaraz po zapisaniu ustawień, bez czekania na aktualizację. Zmiana run-as „na chwilę, do testu” zabiera więc grupie własność tabel. Dlatego run-as na produkcji ustawia tylko wdrożenie (bundle z CI), a nie ręczna edycja w UI.
- Polityki ABAC na źródłach. Według dokumentacji ABAC pipeline odświeża MV i streaming tables z tożsamością run-as (a gdy run-as nie jest ustawiony, z tożsamością właściciela pipeline'u). Jeśli grupa podlega polityce ABAC na tabelach źródłowych, MV na stałe zawiera zamaskowane albo odfiltrowane dane. Zmiana run-as na grupę może więc zmienić treść tabel, nie tylko właściciela. Od 3 sierpnia 2026 samo odświeżenie nie wymaga już wyjątku z polityki. Jeśli MV ma trzymać niezamaskowane dane, dokumentacja każe dodać tożsamość run-as do
EXCEPT, ale wyjątek obejmuje wtedy każdego członka grupy we wszystkich tabelach objętych polityką, także w notebooku, SQL-u i Genie. Propagacja tagów (Beta) nie obejmuje MV i streaming tables z pipeline'ów, więc czytelników MV chroni dopiero polityka na samym MV, czyli governed tagi nadane ręcznie na jego kolumnach (ALTER MATERIALIZED VIEW ... ALTER COLUMN ... SET TAGS, DBR 16.3+). Dokumentacja ostrzega tylko, że update pipeline'u może cofnąć zmiany zALTERsprzeczne z definicją, a o tagach nie pisze. Na labie zwykłe tagi (nie governed) nadane przezALTER MATERIALIZED VIEWna kolumnę i na samo MV przetrwały zwykłą aktualizację i full refresh. Przy źródłach z ABAC run-as to więc service principal albo pusta grupa-rola (patrz „Kiedy NIE używać”), a nie grupa zespołu. Assume na takiej grupie-roli ma tylko service principal z CI, bo po przyjęciu roli zEXCEPTpolityka nie obejmuje już sesji i każdy, kto ma Assume, zobaczy dane bez maski. Role (RBAC) są przy tym w Public Preview. SET OWNER TOnie zmieni właściciela tabeli pipeline'u. Dokumentacja mówi, że grupę jako właściciela MV lub streaming table ustawia się w UI. Błąd z SQL-a był szerszy niż opis w dokumentacji:[CHANGE_OWNER_NOT_ALLOWED_FOR_PIPELINE_TABLE] Changing owner is not supported for a table managed by the pipeline with ID '<id>'. Modify the run-as identity of the pipeline instead.Komunikat nie wspomina o grupach, tylko odsyła do run-as. Na Free Edition końcówka brzmi trochę inaczej (Modify the run as user of the pipeline instead.), więc w skryptach łapiemy kod błędu, a nie cały tekst. Skrypty, które po migracji „naprawiają” właściciela tabel przez SQL, tu nie zadziałają.
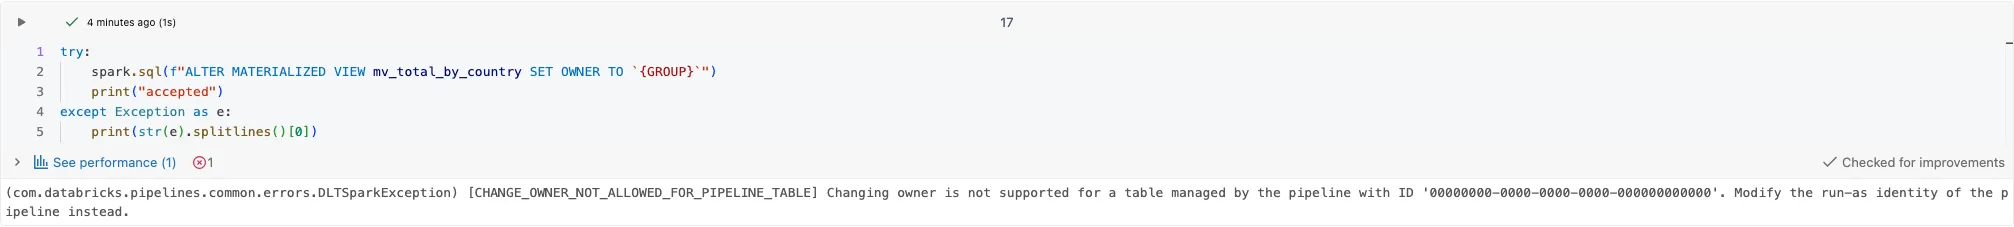
Wynik z labu: ALTER MATERIALIZED VIEW ... SET OWNER TO grupa.
- Zmiana run-as może przerwać aktywną aktualizację. Według dokumentacji pipeline ciągły restartuje się z nową tożsamością, a triggered stosuje ją przy następnym uruchomieniu.
updated_run_askontrarun_as. Dokumentacja każe przy edycji użyćupdated_run_as, ale na labie pełny PUT z samymupdated_run_as(bezrun_as) skończył się błędem „run_as of the pipeline can not be set to null”, a przeszedł dopierorun_as. Ten sam błąd dostaje każdy PUT zbudowany z odpowiedzi GET bez dopisanegorun_as, bo GET go nie zwraca. Z inną tożsamością niżrun_asAPI przyjmujeupdated_run_as, ale go ignoruje. Po każdej zmianie warto odczytaćrun_as_user_name, tak jak w kroku 6.- Sprzątanie bywa niepełne. Przy wcześniejszej wersji tego demo usunięta grupa konta istniała jeszcze następnego dnia, a w schemacie zostawały wewnętrzne tabele
__materialization_mat_..._mv_total_by_country, mimo usunięcia pipeline'u zcascade=true. Nazwa grupy i schematu to widgety notebooka. Jeśli po poprzednim przebiegu grupa nadal istnieje, krok 1 skończy się błędem, więc przed powtórnym uruchomieniem zmieniamy nazwę grupy albo usuwamy starą w konsoli konta. bundle destroyzostawia tabele. Pobundle destroypipeline znika, alemv_total_by_countryzostaje w schemacie. Pierwsza aktualizacja nowego pipeline'u z tego samego bundla skończyła się wtedy błędemTable ... is already managed by pipeline <id>. A table can only be owned by one pipeline.Na labie pomogłoDROP MATERIALIZED VIEWprzed kolejnym deployem.
Czego nie sprawdzałem
Te rzeczy opisuję wyżej na podstawie dokumentacji albo schematu CLI, bez labu:
run_asz grupą na poziomie bundla i targetu (sprawdzałem tylkorun_aszasobu pipeline'u).- Joby z run-as ustawionym na grupę.
- Deploy bundla z grupą na CLI v1.18 i v1.19.
- Klasyczny compute i Can use na cluster policy (lab był na serverless).
- Pipeline bez entitlementu Workspace access (powód przy macierzy uprawnień).
- Streaming tables i tabele, które pipeline aktualizuje (macierz dotyczy MV).
- Ustawienie grupy jako właściciela MV w UI.
- Zmianę run-as w trakcie aktywnej aktualizacji.
- Źródła z politykami ABAC i governed tagi z polityką na MV.
- Pustą grupę-rolę z Assume tylko dla service principala z CI.
Kiedy NIE używać
- Gdy grupa ma ludzi i szerokie uprawnienia. Wszystko, co nadamy grupie dla pipeline'u (np.
MODIFYna tabelach produkcyjnych), dostaje każdy jej członek. Jeśli tego nie chcemy, lepszy jest service principal albo pusta grupa używana jako rola z uprawnieniem Assume. Prosta reguła na środowiska: na dev i test run-as może być grupą zespołu, na produkcji service principalem albo pustą grupą-rolą, na której Assume ma tylko service principal z CI. Inaczej każdy członek zespołu dostajeMODIFYna tabelach produkcyjnych. To wzorzec z dokumentacji RBAC (w Public Preview), na labie go nie budowałem. - Dla jobów, jeśli nie sprawdziliśmy tego u siebie. Opis dla jobów jest w dokumentacji, ale ja testowałem tylko pipeline.
- Gdy wdrażamy pipeline bundle'em z CLI starszym niż v1.20.0. Na v1.16.1 deploy kończy się błędem 400 i pipeline nie powstaje. Pole jest w schemacie od 1.18, a deploy i run z grupą sprawdziłem na 1.20.0, więc tę wersję albo nowszą przypinam w CI. Na 1.18 i 1.19 można jeszcze wymusić silnik Terraform, a dokumentacja providera Terraform dla
databricks_pipelinewymienia wrun_astylkouser_nameiservice_principal_name, więc tej drogi bym nie zakładał. Grupa ustawiona przez API po deployu nie jest obejściem: kolejny deploy jej nie poprawi ani nie cofnie, dopóki nie zmienimy definicji pipeline'u (opis dryfu wyżej).
Zobacz, jak to działa
Nagranie przebiegu notebooka. W trakcie runu film przełącza się na stronę pipeline'u w UI: widać aktualizację, właściciela i „Run as” = grupa, a po kroku 6 znowu użytkownika. Oczekiwanie na aktualizację jest w filmie przyspieszone 8×. W nagraniu notebook ma katalog labu dataistheway i dwie dodatkowe linie time.sleep(40) na pokazanie UI. W repo ich nie ma.
Kod z tego artykułu na GitHubie →notebook i README krok po kroku · lakeflow-pipeline-run-as-group
Podsumowanie
- Pipeline może działać jako grupa konta (
run_as.group_name). Tabele, które publikuje, należą wtedy do grupy. - Grupa musi mieć granty pipeline'u: dla MV z labu
USE CATALOG,USE SCHEMA,CREATE TABLE,CREATE MATERIALIZED VIEW,SELECTi Can read na kodzie, bezMODIFY, plus entitlement Workspace access (z dokumentacji, bez niego nie testowałem). Wbudowaneadmins,usersiaccount usersnie są dozwolone. - Przy edycji dokumentacja mówi o
updated_run_as, ale na labie API je ignoruje, a PUT bezrun_aszostaje odrzucony. GET nie zwracarun_as, więc dopisujemy go do każdego PUT. Po zmianie run-as tabele od razu przechodzą na nową tożsamość. - Bundle z
run_as.group_namesprawdziłem na CLI v1.20.0 i tę wersję przypinam w CI. Kod zostawiamy w folderze deployera, a po deployu sprawdzamyrun_as_user_name, bo ręcznej zmiany run-as kolejny deploy nie cofa. - Run-as i właściciel pipeline'u to osobne ustawienia, a
SET OWNER TOna tabeli pipeline'u kończy się błędemCHANGE_OWNER_NOT_ALLOWED_FOR_PIPELINE_TABLE.
Chcesz kolejne wpisy? Obserwuj przez RSS albo na LinkedInie.
Komentarze
Na razie cisza na szlaku. Napisz pierwszy komentarz.