
 Krzysztof Burejza
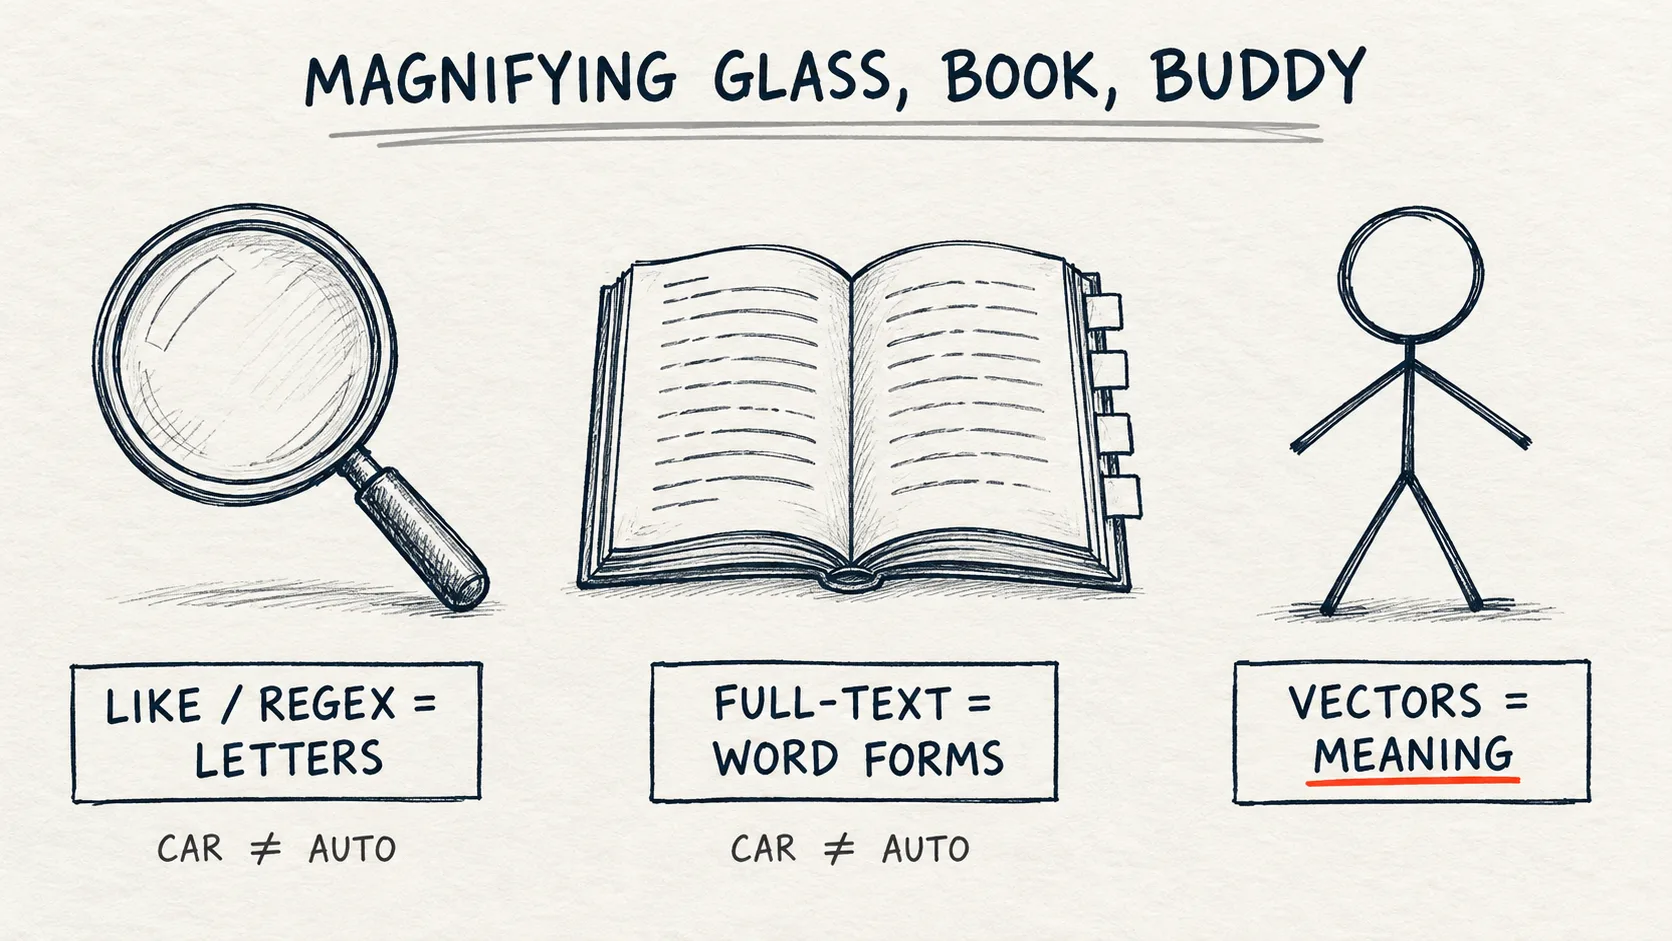
LIKE i regex patrzą na litery, full-text search zna odmiany słów, a wyszukiwanie wektorowe porównuje znaczenie. Na zbiorze 60 artykułów o kawie pytanie „jak prawidłowo parzyć kawę” przez LIKE nie znajduje nic, bo żaden z czterech właściwych artykułów nie zawiera tych słów. Tekst dla osób, które piszą WHERE na co dzień i chcą wiedzieć, kiedy wystarczy lupa, a kiedy trzeba zadzwonić do kumpla.Problem
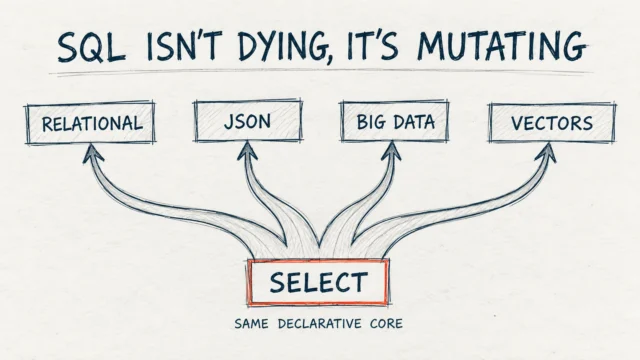
W tekście „SQL nie umiera, tylko mutuje” pisałem, że SQL nie umiera, tylko mutuje. Najlepiej widać to na wyszukiwaniu tekstu, bo tu przez ostatnie lata zmieniło się najwięcej.
Przykład z moich prelekcji: mamy bazę 60 artykułów o kawie. Cztery z nich (ID 1–4) to teksty dla profesjonalnego baristy: profilowanie ciśnienia, chemia wody, dystrybucja kawy w kolbie, refraktometr i procent ekstrakcji. Pozostałe 56 to szum: historia kawy, przepisy, regiony uprawy. Barista wpisuje pytanie: „Jak prawidłowo parzyć kawę?”.
Tytuły artykułów, których szuka, brzmią na przykład „Zaawansowana ekstrakcja: Profilowanie ciśnienia i Flow Control”. Nie ma w nich ani „parzyć”, ani „kawę”. Człowiek od razu widzi, że to o tym samym. Zapytanie SQL nie widzi.
Poprawka do samego siebie: na slajdzie „Porażka w praktyce” pokazywałem wyniki w stylu „247 artykułów, większość nieistotnych”. To były liczby ilustracyjne, a zbiór demo miał 60 wierszy. Poniżej są liczby policzone na prawdziwych danych z demo.
Jak to działa
Na prelekcji o SQL i AI użyłem analogii, która na sali działała lepiej niż jakakolwiek definicja. Szukamy informacji o „pojazdach spalinowych”.
- LIKE i regex to lupa. Patrzymy na każdą literę. Znajdziemy „pojazd”, ale nie „samochód”, „auto” ani „car”. Widzimy znaki, nie sens.
- Full-text to książka z indeksem. Mamy alfabetyczny spis haseł, który zna odmiany, więc znajdziemy „pojazd” i „pojazdy”. „Samochód” to jednak inne hasło w indeksie. Musimy wiedzieć, czego szukać.
- Wektory to kumpel, co kuma. Mówimy „coś o tych czterech kółkach z silnikiem”, a kumpel odpowiada: „Aha, chodzi Ci o samochody”. Rozumie intencję, nawet jeśli użyjemy innych słów.
Pierwsze dwa to wyszukiwanie składniowe (syntactic search), trzecie to wyszukiwanie semantyczne (semantic search).
Tę analogię wymyśliłem jeszcze przed prelekcją.
| Metoda | Jak działa | Zalety | Wady | Kiedy |
|---|---|---|---|---|
| LIKE | dopasowanie wzorca %...% |
proste, bez konfiguracji | literalne, % z przodu wyklucza indeks |
filtry na małych tabelach |
| Regex | wzorce, np. ^[A-Z]{2}\d{4}$ |
precyzja | łatwo o błąd, wolne | walidacja, kody, e-maile |
| Full-text | indeks, stemming, ranking | szybkie, zna odmiany | bez synonimów | wyszukiwarki po słowach |
| Wektory | embeddingi i najbliżsi sąsiedzi | rozumie znaczenie i synonimy | wymaga modelu i zasobów | wyszukiwanie po intencji |
Krok po kroku
Lupa: LIKE
Zapytanie z demo na SQL Server 2025, ten sam wzorzec na tytule i na treści:
T-SQL, SQL Server 2025 (poza Databricks)
SELECT id, title FROM dbo.ArticlesAboutCoffee
WHERE body COLLATE Latin1_General_CI_AS LIKE N'%jak%prawidłowo%parzyć%kawę%';
Wynik: 0 wierszy w treści i 0 w tytułach. Dla porównania title LIKE N'%kawa%' zwraca 18 tytułów, ale gubi 10 tytułów, w których pada „kawy”, „kawę”, „kaw” albo „kawowe”. Lupa nie zna odmiany.
Na Databricks to samo zrobimy w SQL bez żadnej konfiguracji. Notebook do artykułu (code/lupa_ksiazka_kumpel.sql) nie potrzebuje danych z prelekcji: generuje 12 krótkich, syntetycznych artykułów o kawie, z czego ID 1–4 to znowu teksty dla profesjonalnego baristy, a pozostałe 8 to szum.
✓ Działa na Free Edition
SELECT id, title
FROM coffee_articles
WHERE body ILIKE '%parzyć%' OR title ILIKE '%parzyć%';
Na labie (29.09.2026) to zapytanie zwróciło 0 wierszy, tak samo jak pełny wzorzec '%jak%prawidłowo%parzyć%kawę%'. W treściach są „parzenia” i „parzona”, ale nie „parzyć”. Z odmianą jest to samo co na SQL Server: title ILIKE '%kawa%' trafiło 1 tytuł z 12, a title RLIKE '(?i)kaw(a|y|ę|owe)' 4 tytuły.
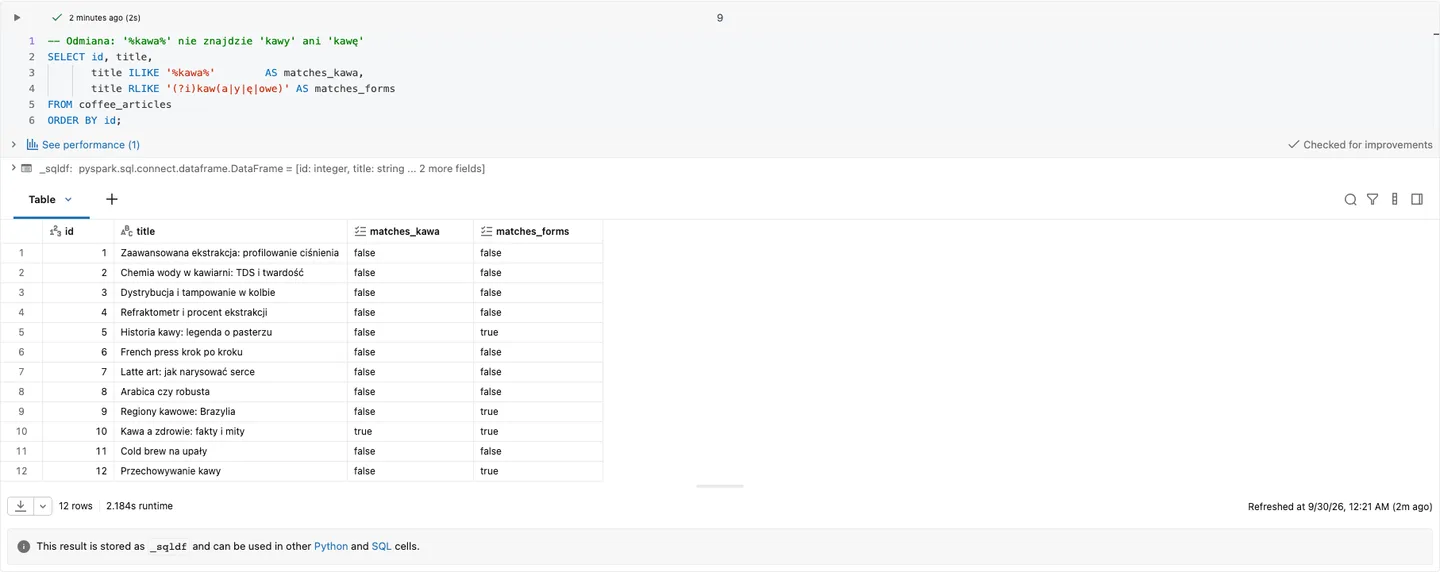
Wynik z labu (Databricks, 29.09.2026): ILIKE '%kawa%' znajduje 1 tytuł z 12, regex z formami słowa 4, a żaden z artykułów dla baristy (ID 1–4) nie ma „kawy” w tytule w żadnej formie.
Lupa z lepszym szkłem: regex
Regex pozwala szukać całych słów i list wariantów:
✓ Działa na Free Edition
SELECT id, title,
       regexp_extract(body, '(?i)(espresso|aeropress|french press|chemex|v60|moka)', 1) AS first_method
FROM coffee_articles
WHERE body RLIKE '(?i)(espresso|aeropress|french press|chemex|v60|moka)';
W skrypcie demo miałem też zapytanie, które wyglądało rozsądnie, a zwracało wszystko:
T-SQL, SQL Server 2025 (poza Databricks)
-- BŁĄD: pusta alternatywa na końcu dopasuje każdy tekst
WHERE REGEXP_LIKE(body, N'(jak|prawidlowo|parzyc|kawe|)', 'i')
Ostatni znak | przed nawiasem dodaje pustą alternatywę, a pusty ciąg pasuje do każdego tekstu. Na 60 artykułach to 60 trafień. Po usunięciu pustej alternatywy zostaje 12, w tym przypadkowe trafienia na „jak” wewnątrz innych słów.
Na Databricks ten sam błąd wygląda tak samo, tylko zamiast REGEXP_LIKE piszemy RLIKE. Na labie (29.09.2026), na 12 syntetycznych artykułach, wzorzec z pustą alternatywą trafił 12 z 12 wierszy, a bez niej 0. Te krótkie teksty nie zawierają żadnego z tych czterech słów w zapisie bez ogonków, więc różnica jest jeszcze bardziej widoczna.
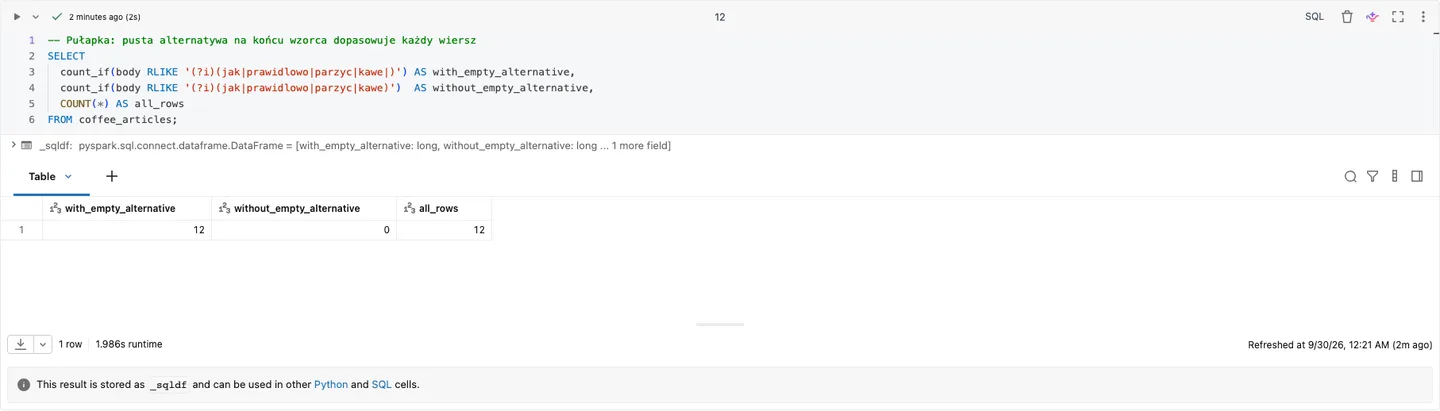
Wynik z labu (Databricks, 29.09.2026): jeden znak | zmienia 0 trafień w 12 z 12, bez żadnego błędu ani ostrzeżenia.
Książka: full-text search
Full-text search w SQL Server wymaga przygotowania: katalogu, unikalnego indeksu na kluczu i indeksu pełnotekstowego z językiem polskim (1045).
T-SQL, SQL Server 2025 (poza Databricks)
CREATE FULLTEXT CATALOG CoffeeCat;
CREATE UNIQUE INDEX UX_ArticlesAboutCoffee_Id ON dbo.ArticlesAboutCoffee(id);
CREATE FULLTEXT INDEX ON dbo.ArticlesAboutCoffee
  (title LANGUAGE 1045, body LANGUAGE 1045)
  KEY INDEX UX_ArticlesAboutCoffee_Id ON CoffeeCat
  WITH CHANGE_TRACKING AUTO;

SELECT TOP 10 d.id, d.title, k.rank
FROM FREETEXTTABLE(dbo.ArticlesAboutCoffee, (title, body), N'jak prawidłowo parzyć kawę') AS k
JOIN dbo.ArticlesAboutCoffee d ON d.id = k.[KEY]
ORDER BY k.rank DESC;
FREETEXTTABLE rozbija pytanie na słowa i szuka ich form, a kolumna rank mówi o trafności. To duży krok od lupy. Dalej jednak szukamy słów: artykuł o profilowaniu ciśnienia nie zawiera „parzyć” w żadnej formie.
W Databricks SQL nie ma odpowiednika CONTAINSTABLE. Wyszukiwanie pełnotekstowe daje tam AI Search w trybie FULL_TEXT albo HYBRID, ale FULL_TEXT na świeżym workspace'ie był na próbie 15.09.2026 podglądem wyłączonym domyślnie. Wrócę do tego w części o porównaniu obu platform.
Kumpel: podobieństwo znaczenia
Najprostszy sposób, żeby na Databricks zobaczyć „kumpla” w akcji, to funkcja ai_similarity. Porównuje dwa teksty i zwraca wynik podobieństwa, bez indeksu i bez własnego modelu.
✓ Działa na Free Edition
SELECT id, title,
       ai_similarity(body, 'Jak prawidłowo parzyć kawę?') AS score
FROM coffee_articles
ORDER BY score DESC
LIMIT 5;
Na labie (29.09.2026) kumpel nie wypadł tak dobrze, jak w analogii. Dla pytania „Jak prawidłowo parzyć kawę?” pierwsze miejsca zajęły „Historia kawy” (0,679), „Regiony kawowe: Brazylia” (0,671) i „Cold brew na upały” (0,628). Z czterech artykułów dla baristy w pierwszej piątce znalazła się tylko „Chemia wody w kawiarni” (ID 2, czwarte miejsce, 0,626).
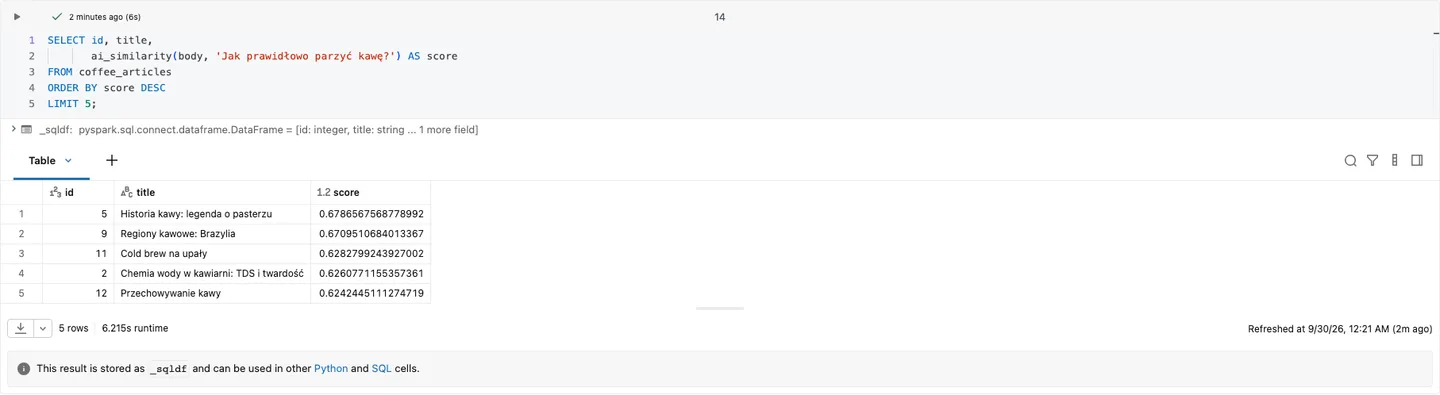
Wynik z labu (Databricks, 29.09.2026): dosłowne pytanie baristy stawia na szczycie teksty, w których po prostu dużo jest o kawie, a nie te, których barista szuka.
Dopiero gdy pytanie opisało intencję wprost, 'Profesjonalne techniki parzenia kawy dla zaawansowanych baristów', w pierwszej piątce pojawiły się trzy artykuły dla baristy (ID 1, 2 i 3). Na pierwszym miejscu dalej jednak była Brazylia (0,695).
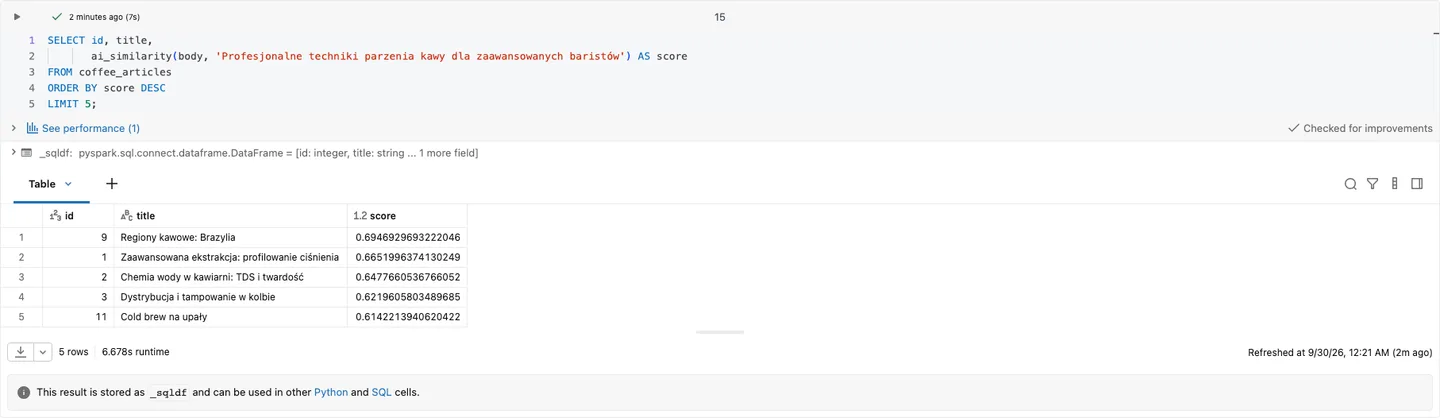
Wynik z labu (Databricks, 29.09.2026): lepiej opisana intencja wciąga do piątki trzy z czterech właściwych artykułów, ale wszystkie wyniki mieszczą się w wąskim przedziale 0,61–0,69.
Wniosek jest dla mnie taki, że kumpel rozumie więcej niż lupa, jednak na krótkich polskich tekstach i przy jednym zdaniu pytania nie jest wyrocznią. Wynik zależy od modelu i od tego, jak sformułujemy pytanie, więc ranking warto sprawdzić na własnych przykładach, zanim na nim coś zbudujemy.
Na małej tabeli to wystarczy. Przy tysiącach dokumentów liczenie podobieństwa dla każdego wiersza przy każdym pytaniu przestaje mieć sens i wtedy potrzebujemy embeddingów zapisanych w tabeli oraz indeksu.
Pułapki
- Kolacja i ogonki.
Latin1_General_CI_ASnie rozróżnia wielkości liter, ale rozróżnia ogonki, więc „parzyc” nie znajdzie „parzyć”.Polish_100_CI_AIignoruje ogonki. Wynik tego samegoLIKEzależy od kolacji kolumny. - Pusta alternatywa w regexie.
(a|b|)pasuje do wszystkiego. Taki błąd nie rzuca wyjątkiem, tylko zwraca całą tabelę. %na początku wzorca.LIKE '%kawa%'nie skorzysta z indeksu B-tree, więc na dużej tabeli to pełny skan.- Full-text bez synonimów. Indeks zna „pojazd” i „pojazdy”, ale „samochód” to dla niego inne słowo. Listę synonimów (thesaurus) trzeba utrzymywać ręcznie.
- Wektory zawsze coś zwrócą. Wyszukiwanie wektorowe zwraca najbliższych sąsiadów, nawet jeśli pytanie nie ma nic wspólnego z danymi. Pytanie o Bielsko-Białą w bazie o kawie też dostanie „najlepsze” pięć artykułów.
- Model embeddingów a język.
databricks-gte-large-ento model angielski. Na wstępnej próbie przed warsztatem polska parafraza dostała 0,611, a zdanie niezwiązane 0,574. Margines jest mały, więc dla polskich tekstów warto sprawdzić model na własnych przykładach. Na labie (29.09.2026)ai_similaritydla obu pytań dało całej pierwszej piątce wyniki między 0,61 a 0,69, a w obu przypadkach wysoko był tekst o Brazylii, który z parzeniem nie ma nic wspólnego.
Kiedy NIE używać
- Wektorów do kodów, e-maili, numerów. Jeśli znamy wzorzec (
^[A-Z]{2}\d{4}$), regex da wynik deterministyczny i tani. Kumpel „mniej więcej” do numeru faktury to zły pomysł. - LIKE do pytań o znaczenie. Dołożenie kolejnych
OR LIKEz synonimami szybko robi się nieutrzymywalne. - Full-text, gdy nie mamy go jak utrzymać. Indeks pełnotekstowy to kolejny obiekt do administrowania. Na małej tabeli czasem wystarczy
ILIKE.
Zobacz, jak to działa
Nagranie przechodzi przez notebook od utworzenia tabeli, przez ILIKE i RLIKE, aż po oba zapytania z ai_similarity.
Pełny notebook jest w folderze code/ (lupa_ksiazka_kumpel.sql), razem z wersją T-SQL dla SQL Server.
Podsumowanie
- Lupa (
LIKE, regex) widzi litery, książka (full-text) widzi słowa i ich odmiany, kumpel (wektory) widzi znaczenie. - Na 60 artykułach o kawie
LIKEdla „jak prawidłowo parzyć kawę” zwraca 0 wierszy, a%kawa%gubi 10 tytułów z inną formą słowa. - Regex z pustą alternatywą dopasowuje wszystko. Sprawdzajmy liczbę trafień, zanim uwierzymy w wynik.
ai_similarityna labie postawiło dla dosłownego pytania tylko jeden z czterech artykułów dla baristy w pierwszej piątce. Kumpel też potrzebuje dobrze zadanego pytania i sprawdzenia na własnych danych.
Stan na:
Chcesz kolejne wpisy? Obserwuj przez RSS albo na LinkedInie.
Komentarze
Na razie cisza na szlaku. Napisz pierwszy komentarz.