
 Krzysztof Burejza
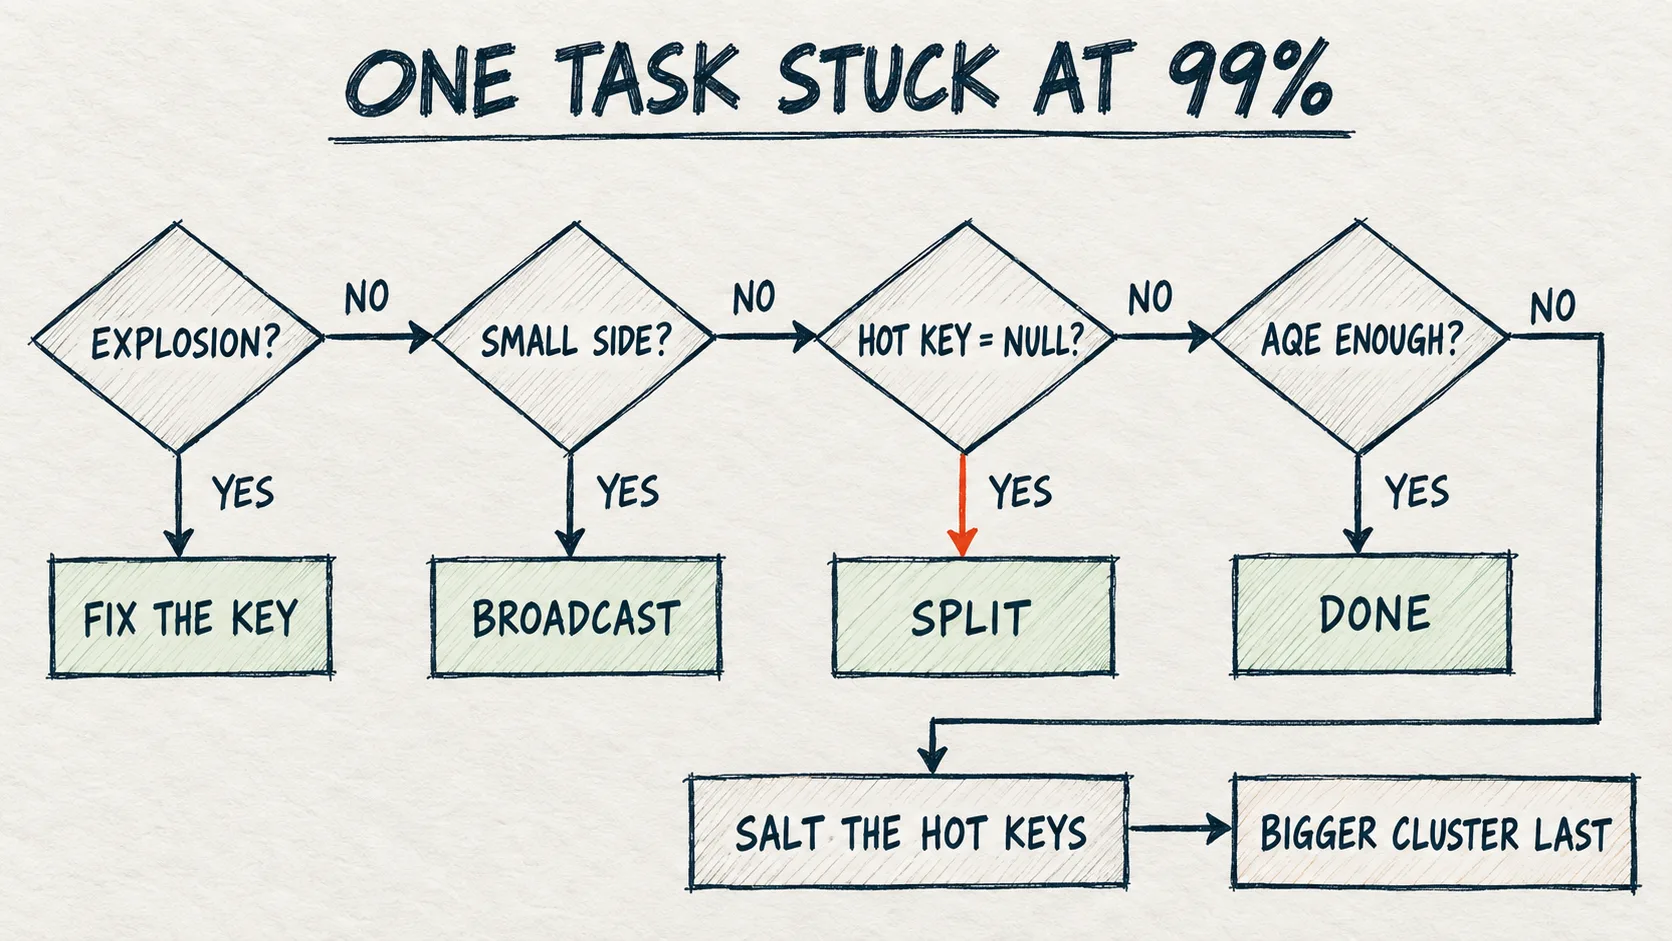
Problem
Objaw jest zawsze podobny. Job, który zwykle trwa kilka minut, wisi na 199 z 200 tasków. Jeden task pracuje od kwadransa, pozostałe skończyły w kilka sekund. Albo job pada z OOM na jednym executorze, a reszta klastra ma wolną pamięć.
Typowe demo skew buduje się celowo: 90% wierszy faktów dostaje jeden klucz klienta. To dobrze pokazuje mechanizm, ale najczęstsza pułapka leży gdzie indziej. Ktoś słyszy „skew”, od razu dopisuje salting z internetu, a prawdziwą przyczyną była eksplozja joina albo tysiące pustych kluczy, które wystarczyło odfiltrować.
W popularnych poradach o skew powtarzają się dwa błędy. Jedna z typowych tabel „Skew Solutions” zaleca dla skośnego groupBy rozwiązanie „repartition() + salting”, a przy kluczach NULL często pada zdanie, że „NULL-e i tak nie pasują w inner/left join”. Pierwsze nie pomaga, a drugie jest prawdą tylko dla inner joina. Wyjaśniam to w drzewku.
W jednym z projektów najbardziej skośny był klucz client_id: jeden klient miał 800 tys. zamówień, a pozostali po około 20 tys. Naprawa idzie wtedy w dwóch krokach, dokładnie jak w drzewku niżej: najpierw AQE, które przy joinie samo dzieli skośną partycję, a dopiero gdy to nie wystarcza, salting samego gorącego klucza.
Jak to działa
Shuffle rozdziela wiersze między partycje według hasha klucza. Wszystkie wiersze z tym samym kluczem trafiają do tej samej partycji, a jedną partycję przetwarza jeden task. Jeśli klucz CUST000001 ma 90% wierszy, to jeden task dostaje 90% pracy, niezależnie od tego, ile mamy rdzeni.
Spark ma na to trzy wbudowane mechanizmy i warto znać ich granice:
| Mechanizm | Co robi | Czego nie robi |
|---|---|---|
| AQE skew join | Dzieli za dużą partycję joina na kilka tasków i powiela dla nich odpowiadającą partycję drugiej strony | Działa tylko dla joinów z shuffle'em. Partycja musi być jednocześnie 5× większa od mediany i większa niż 256 MB (domyślne progi) |
| Częściowa agregacja | groupBy z sum, count, max liczy wynik częściowy w każdym tasku przed shuffle'em, więc gorący klucz przesyła po jednym wierszu z taska |
Nie pomaga przy agregacjach, których nie da się złożyć z części: collect_list, dokładne percentyle, funkcje okna |
| Broadcast join | Mała strona trafia w całości do każdego executora, duża strona nie jest shufflowana | Wymaga, żeby jedna strona była mała (domyślny próg automatyczny to 10 MB) |
Z tabeli wynika wniosek, który łatwo przeoczyć: na małych danych AQE nie uzna partycji za skośną, nawet jeśli ma 90% wierszy. Jeśli cała tabela ma 100 MB, żadna partycja nie przekroczy 256 MB. Skew na małych danych po prostu nie boli, a na dużych AQE często już go rozwiązał. Problem zostaje w środku: kilka GB na gorącym kluczu, agregacja, której nie da się podzielić, albo outer join.
Drzewko decyzyjne
0. Czy to na pewno skew?
Trzy problemy wyglądają podobnie w logach, a naprawia się je zupełnie inaczej:
- Eksplozja joina. Liczba wierszy wyjściowych joina jest wielokrotnie większa niż wejściowych. Wszystkie taski są wolne, nie jeden. Naprawą jest klucz joina, nie compute.
- Spill we wszystkich taskach. Partycje są za duże dla pamięci, ale równe. Pomaga więcej partycji albo mniejszy wolumen po wcześniejszym filtrowaniu.
- Skew. Jeden task (albo kilka) trwa wielokrotnie dłużej niż mediana.
Na klasycznym klastrze sprawdzamy to w Spark UI: zakładka Stages, najwolniejszy stage, „Summary metrics for tasks” i porównanie maksimum z medianą. Na serverless tej zakładki nie ma, a query profile pokazuje metryki per operator, bez rozkładu tasków. Wtedy pytamy dane wprost:
✓ Działa na Free Edition
SELECT customer_id,
       count(*)                                         AS cnt,
       round(100 * count(*) / sum(count(*)) OVER (), 2) AS pct
FROM retailhub_demo.bronze.skew_facts
GROUP BY customer_id
ORDER BY cnt DESC
LIMIT 20;
Jeśli pierwszy wiersz ma kilkadziesiąt procent, a drugi ułamek procenta, mamy gorący klucz. Jeśli pierwszym wierszem jest NULL, przechodzimy od razu do kroku 3.
Na labie (29.09.2026, serverless) na syntetycznych danych z notebooka (2 mln faktów, 10 000 klientów) wyszło: CUST000001 ma 1 800 024 wiersze (90,0%), drugi jest NULL z 39 939 wierszami (2,0%), a kolejny klient ma już tylko 34 wiersze. Taki obraz to jednocześnie gorący klucz i kandydat do kroku 3.
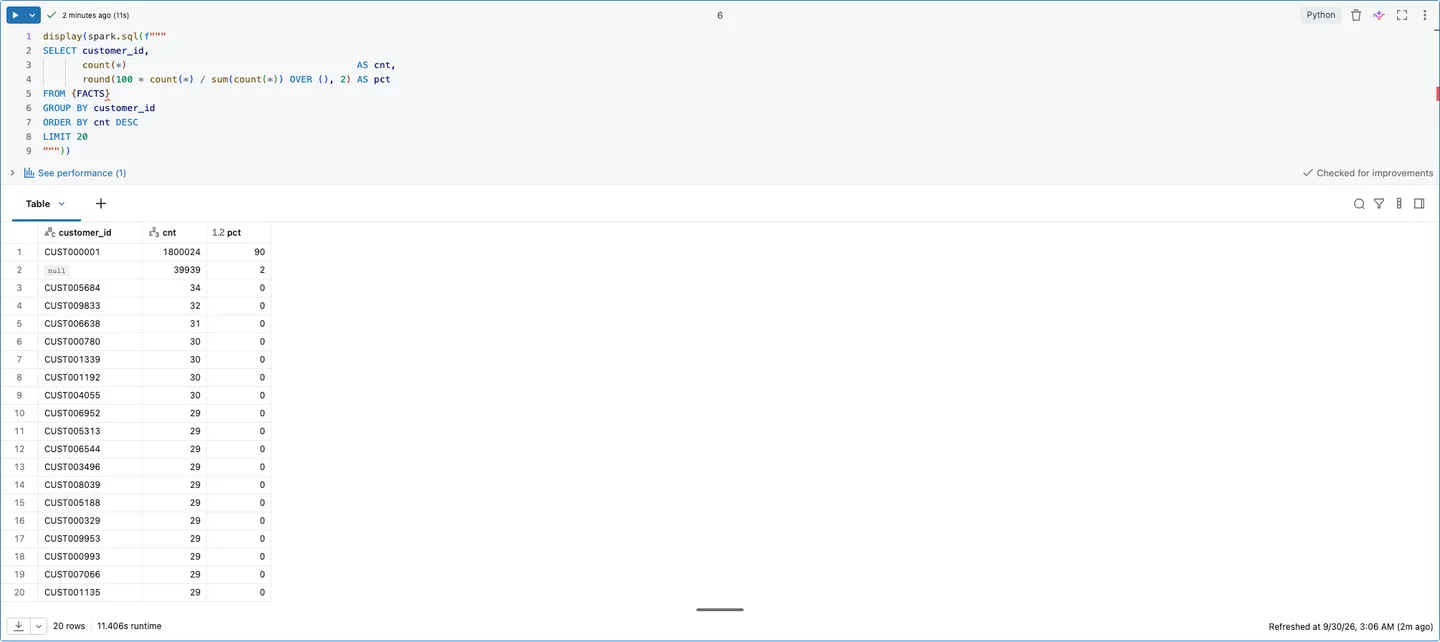
Wynik z labu (Databricks, 29.09.2026): jeden klucz ma 90% wierszy, a drugi w kolejności jest NULL z 2%.
1. Gdzie siedzi gorący klucz?
Ten sam klucz może boleć w różnych operacjach, a każda ma inne lekarstwo:
- join → kroki 2–5,
groupBy→ krok 6,- funkcja okna z
PARTITION BYpo gorącym kluczu → krok 6, - pliki źródłowe (jeden plik 10 GB obok stu po 100 MB) albo partycja z ostatniego miesiąca → krok 7.
2. Czy jedna strona joina jest mała?
Jeśli tak, broadcast rozwiązuje problem u źródła, bo duża strona nie przechodzi przez shuffle i nie ma gorącej partycji. AQE sam zamienia join na broadcast, gdy po filtrach strona okaże się mała, ale możemy to wymusić hintem. Na serverless to jedyna droga, bo progu autoBroadcastJoinThreshold nie da się tam nawet odczytać.
✓ Działa na Free Edition
SELECT /*+ BROADCAST(d) */ f.*, d.segment
FROM retailhub_demo.bronze.skew_facts f
JOIN retailhub_demo.bronze.skew_dim d ON f.customer_id = d.customer_id;
Na labie (29.09.2026) plan z hintem pokazał PhotonBroadcastHashJoin bez shuffle'a po stronie faktów, a join zwrócił 1 960 061 wierszy, czyli 2 mln minus wiersze z NULL-em.
Granica jest prosta: broadcastowana strona musi zmieścić się w pamięci każdego executora. Wymiar z milionami wierszy i szerokimi kolumnami to już ryzyko OOM na driverze i executorach.
3. Czy gorącym kluczem jest NULL?
To najczęstszy „skew”, który wcale nie wymaga saltingu. Zachowanie zależy od typu joina:
- Inner join. Optymalizator sam dodaje filtr
isnotnull(klucz)po obu stronach, bo NULL i tak nie może spełnić warunku równości. Wiersze z NULL-em nie dochodzą do shuffle'a. Warto to sprawdzić w planie, zamiast dopisywać filtr w ciemno. - Left, right i full outer join. Wiersze z NULL-em muszą zostać w wyniku, więc przechodzą przez shuffle i wszystkie lądują w jednej partycji. Tu komentarz ze źródła był błędny: w left joinie NULL-e nie pasują, ale nie znikają.
Naprawa dla outer joina: odcinamy NULL-e przed joinem i doklejamy je z pustymi kolumnami wymiaru.
✓ Działa na Free Edition
from pyspark.sql import functions as F

facts = spark.table("retailhub_demo.bronze.skew_facts")
dim   = spark.table("retailhub_demo.bronze.skew_dim")

nulls    = facts.filter(F.col("customer_id").isNull())
nonnulls = facts.filter(F.col("customer_id").isNotNull())

dim_cols = [c for c in dim.columns if c != "customer_id"]
left_joined = (
    nonnulls.join(dim, "customer_id", "left")
    .unionByName(nulls.select("*", *[F.lit(None).cast(dim.schema[c].dataType).alias(c)
                                     for c in dim_cols]))
)
Kontrola poprawności: left_joined.count() musi być równe facts.count(), jeśli klucz w wymiarze jest unikalny. Na labie (29.09.2026) obie wersje, rozdzielona i zwykły left join, zwróciły po 2 000 000 wierszy. W planie inner joina filtr isnotnull(customer_id) był po obu stronach, zarówno przy broadcaście, jak i przy sort-merge joinie, więc 39 939 NULL-i odpadło jeszcze przed shuffle'em. Ten sam problem dotyczy groupBy po kolumnie z dużą liczbą NULL-i: grupa NULL jest jedną grupą i jednym taskiem.
4. Czy AQE już sobie radzi?
AQE jest domyślnie włączone na Databricks, a na serverless zawsze. Jeśli gorąca partycja przekracza progi z tabeli wyżej, AQE podzieli ją sam. Na klasycznym klastrze widać to w Spark UI w planie zapytania (węzeł czytający shuffle z informacją o partycjach skośnych), a progi możemy obniżyć. Na serverless progów nie zmienimy, a na labie (29.09.2026) nie dało się ich nawet odczytać: spark.conf.get zwrócił AnalysisException dla wszystkich czterech ustawień AQE, łącznie z spark.sql.adaptive.enabled. To, że AQE działa, widać dopiero w planie, który zaczyna się od AdaptiveSparkPlan.
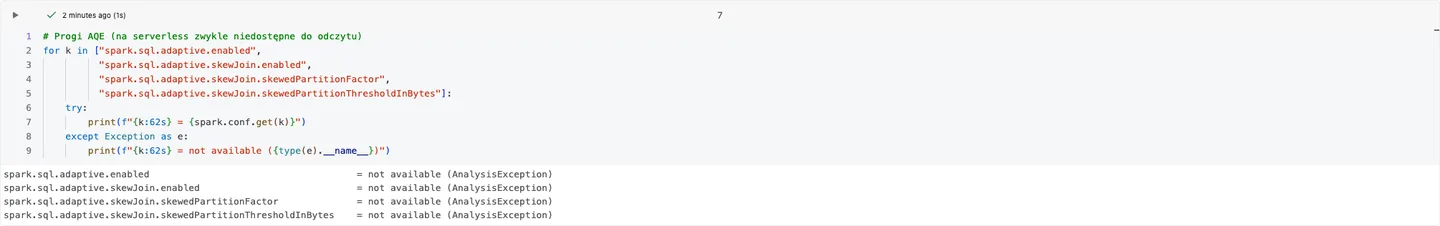
Wynik z labu (Databricks, 29.09.2026): na serverless progów AQE nie odczytamy przez spark.conf.get, więc nie sprawdzimy też ich domyślnych wartości.
Wniosek praktyczny: jeśli job wisi na jednym tasku, mimo że AQE jest włączone, to albo operacja nie jest joinem, albo partycja nie przekracza progu, albo AQE ją podzielił, a gorący klucz i tak jest za duży dla jednego zestawu tasków. Wtedy przechodzimy do saltingu.
5. Salting: tylko gorące klucze
Salting rozbija gorący klucz na N podkluczy. Po stronie faktów każdy wiersz gorącego klucza dostaje losową sól od 0 do N−1. Po stronie wymiaru wiersz tego klucza powielamy N razy, po jednym dla każdej soli. Join idzie po parze (klucz, sól). Materiał źródłowy podaje próg orientacyjny: salting ma sens, gdy AQE nie wystarcza, a nierównowaga kluczy przekracza 100:1.
Solimy tylko gorące klucze, bo powielenie całego wymiaru N razy to N razy więcej danych po drugiej stronie joina.
✓ Działa na Free Edition
N = 16
hot_keys = [r["customer_id"] for r in
            facts.groupBy("customer_id").count()
                 .filter("count > 100000").select("customer_id").collect()]

facts_s = facts.withColumn(
    "salt",
    F.when(F.col("customer_id").isin(hot_keys), (F.rand() * N).cast("int"))
     .otherwise(F.lit(0)))

dim_s = (dim.withColumn(
            "salts",
            F.when(F.col("customer_id").isin(hot_keys), F.sequence(F.lit(0), F.lit(N - 1)))
             .otherwise(F.array(F.lit(0))))
            .withColumn("salt", F.explode("salts"))
            .drop("salts"))

salted = facts_s.join(dim_s.hint("merge"), ["customer_id", "salt"]).drop("salt")
Hint merge wymusza tu sort-merge join, żeby na małym wymiarze demo nie zamieniło się w broadcast. W prawdziwym przypadku saltingu obie strony są duże i hint nie jest potrzebny. Wynik sprawdzamy liczbą wierszy: salted join musi zwrócić tyle samo co zwykły.
Na labie (29.09.2026, serverless) lista gorących kluczy miała jeden element, CUST000001. Oba joiny zwróciły po 1 960 061 wierszy, zwykły sort-merge join trwał 1,2 s, a salted 1,3 s. Na 2 mln wierszy to różnica w szumie, co zgadza się z tezą z tabeli: na małych danych skew po prostu nie boli. Salting widać za to w rozkładzie: zamiast 1 800 024 wierszy pod jednym kluczem mamy 16 par (klucz, sól) po około 112 tys. wierszy (od 111 829 do 113 031 wierszy na każdą z 16 wartości soli). Liczby tasków na serverless nie odczytamy, bo nie ma tam zakładki Stages. Dodatkowo początkowy plan sort-merge joina miał shuffle na 21 partycji, a nie 200, a Photon zgłosił węzeł SortMergeJoin jako nieobsługiwany, więc sam join wymuszony hintem idzie poza Photonem.
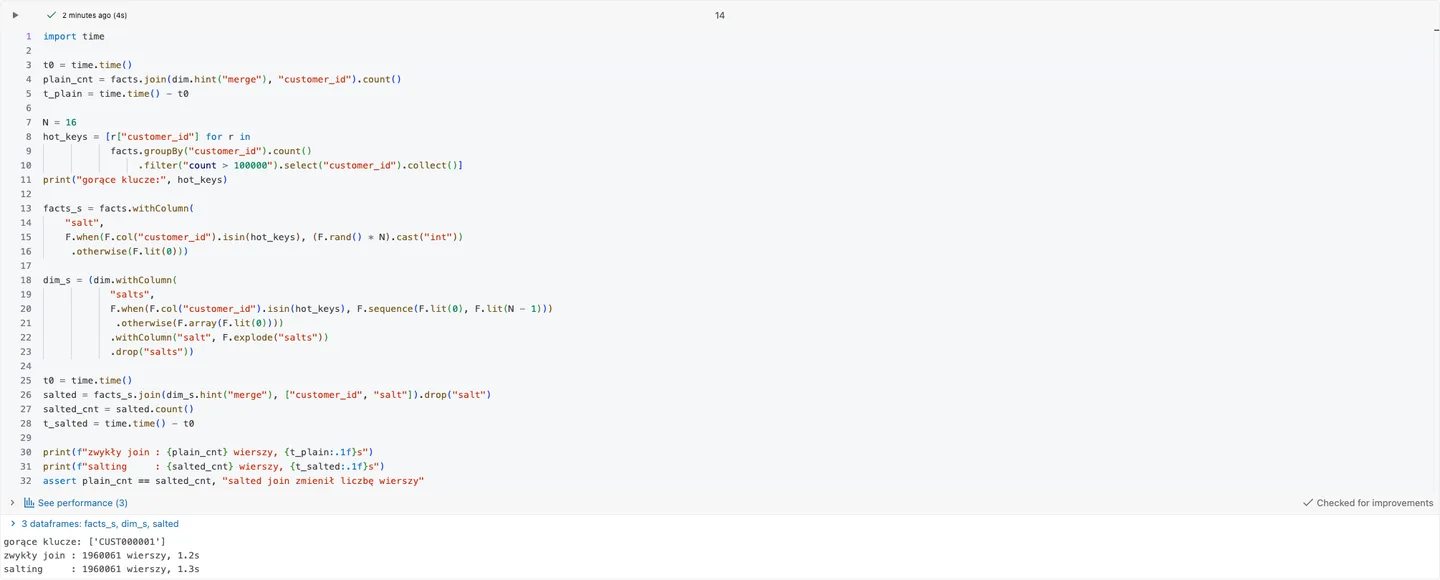
Wynik z labu (Databricks, 29.09.2026): salting nie zmienia liczby wierszy, a na 2 mln wierszy nie zmienia też czasu.
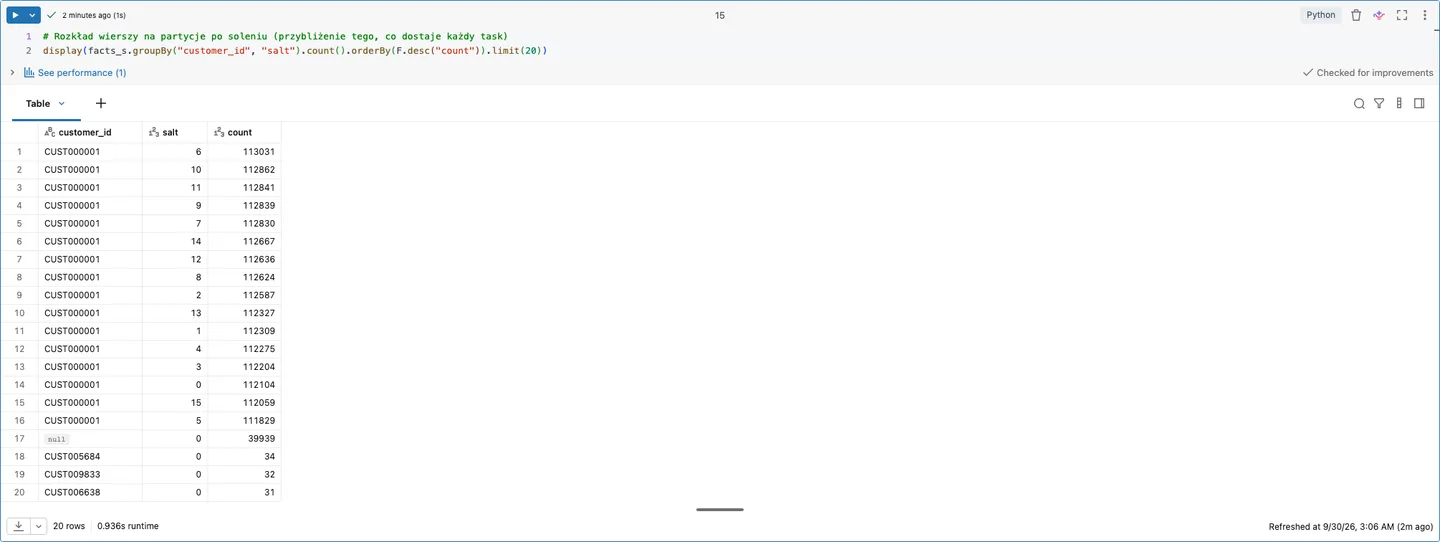
Wynik z labu (Databricks, 29.09.2026): gorący klucz rozkłada się równo na 16 podkluczy, po około 1/16 wierszy na każdy.
Koszt saltingu to trzy rzeczy: kod, który trzeba utrzymać, lista gorących kluczy, która z czasem się zmienia, i powielenie ich wierszy w wymiarze. Dlatego jest w drzewku tak późno.
6. Skośny groupBy i funkcje okna
Popularne zalecenie „repartition() + salting” nie działa dla groupBy: groupBy i tak robi shuffle po kluczu, więc wcześniejszy repartition zostaje zignorowany albo dokłada jeszcze jeden shuffle. Właściwe pytanie brzmi: czy agregację da się złożyć z części?
sum,count,min,max,avg. Częściowa agregacja już to robi. SkośnygroupByz takimi funkcjami rzadko jest problemem.count(DISTINCT x). Rozbijamy na dwa kroki: najpierw unikalne pary (klucz, x), potem zwykłecount. Pierwszy shuffle idzie po parze, więc gorący klucz rozkłada się na wiele partycji.- Funkcja okna po gorącym kluczu.
row_number() OVER (PARTITION BY customer_id ORDER BY ts)sortuje wszystkie wiersze klucza w jednym tasku. Jeśli potrzebujemy tylko najnowszego wiersza na klucz,max_byrobi to agregacją z częściową agregacją.
✓ Działa na Free Edition
# count(DISTINCT product_id) per customer in two steps
distinct_products = (facts.select("customer_id", "product_id").distinct()
                          .groupBy("customer_id").count())

# latest order per customer without a window function
latest = (facts.groupBy("customer_id")
               .agg(F.max_by(F.struct(*facts.columns), F.col("order_ts")).alias("r"))
               .select("r.*"))
Na labie (29.09.2026) wersja dwuetapowa dała dokładnie ten sam wynik co countDistinct (0 różnic w exceptAll).
Dla collect_list po gorącym kluczu dobrej odpowiedzi nie ma: wynik i tak jest jedną ogromną tablicą w jednym wierszu. Wtedy pytamy, czy ta tablica jest w ogóle potrzebna.
7. Skew w danych na dysku
Jeden plik źródłowy 10 GB obok stu po 100 MB albo tabela partycjonowana po dacie, w której ostatni miesiąc jest o rząd wielkości większy, dają skośne taski już przy odczycie. Tu pomaga OPTIMIZE i Liquid Clustering zamiast statycznego partycjonowania.
8. Większy klaster: na końcu
Więcej executorów nie pomaga, bo gorąca partycja i tak trafia do jednego taska. Większy węzeł może pomóc na OOM, ale leczy objaw. Dobrze to podsumowuje jedno hasło: naprawiamy klucz, nie klaster.
Pułapki
- Salting na całym kluczu. Powielenie całego wymiaru N razy potrafi być droższe niż skew, który miało naprawić. Solimy tylko klucze z listy gorących.
- Salt z
rand()bez kontroli wyniku. Po zmianie joina zawsze porównujemy liczbę wierszy ze zwykłym joinem. Pomyłka w warunku joina (np. braksaltpo jednej stronie) daje cichą eksplozję. - Lista gorących kluczy wpisana na sztywno. Rozkład danych się zmienia. Listę liczymy w jobie albo trzymamy w tabeli konfiguracyjnej.
- Stroimy progi AQE na serverless. Nie da się. Zostają hinty i przebudowa zapytania.
- Mierzymy na małych danych. Na kilku milionach wierszy AQE nawet nie uzna partycji za skośną, a różnice czasu są w szumie (na labie 1,2 s vs 1,3 s przy 2 mln wierszy). Liczymy taski i wiersze na partycję.
- Szukamy skew, a problemem jest eksplozja. Najpierw porównujemy wiersze wejściowe i wyjściowe joina.
Kiedy NIE używać
Saltingu i ręcznego rozbijania agregacji nie stosujemy „na zapas”. Jeśli job kończy się w akceptowalnym czasie, AQE i broadcast zwykle wystarczają, a ręczna optymalizacja to dodatkowy kod do utrzymania. Nie stosujemy ich też, gdy przyczyną jest zły model danych, np. join faktów z faktami po kluczu, który nie jest unikalny w żadnej tabeli. Tam trzeba zmienić model, nie plan zapytania.
Zobacz, jak to działa
Nagranie przechodzi przez notebook z labu krok po kroku: rozkład klucza, broadcast, NULL-e w inner i left joinie, salting oraz przebudowę groupBy.
Pełny notebook jest w code/data_skew.py. Dane są syntetyczne i generowane w notebooku, więc wyniki można odtworzyć na własnym workspace'ie.
Podsumowanie
- Zanim nazwiemy problem skew, wykluczamy eksplozję joina i równomierny spill.
- Na serverless nie ma rozkładu tasków, więc rozkład klucza sprawdzamy zapytaniem
GROUP BY ... ORDER BY cnt DESC. - Kolejność naprawy: broadcast, obsługa NULL-i w outer joinach, AQE, salting tylko gorących kluczy, przebudowa agregacji i okien. Większy klaster na końcu.
- AQE dzieli tylko partycje joinów powyżej progów (domyślnie 5× mediana i 256 MB), więc nie pomoże przy
groupBy, oknach ani małych danych. - Naprawiamy klucz, nie klaster.
Stan na:
Chcesz kolejne wpisy? Obserwuj przez RSS albo na LinkedInie.
Komentarze
Na razie cisza na szlaku. Napisz pierwszy komentarz.