
 Krzysztof Burejza
Problem
Objaw jest zawsze podobny. Job, który zwykle trwa kilka minut, wisi na 199 z 200 tasków, bo jeden task pracuje od kwadransa, a pozostałe skończyły w kilka sekund. Albo job pada z OOM na jednym executorze, a reszta klastra ma wolną pamięć.
Typowe demo skew buduje się celowo: 90% wierszy faktów dostaje jeden klucz klienta. To dobrze pokazuje mechanizm, jednak w praktyce ktoś słyszy „skew”, dopisuje salting z internetu, a przyczyną była eksplozja joina albo tysiące pustych kluczy, które wystarczyło odfiltrować.
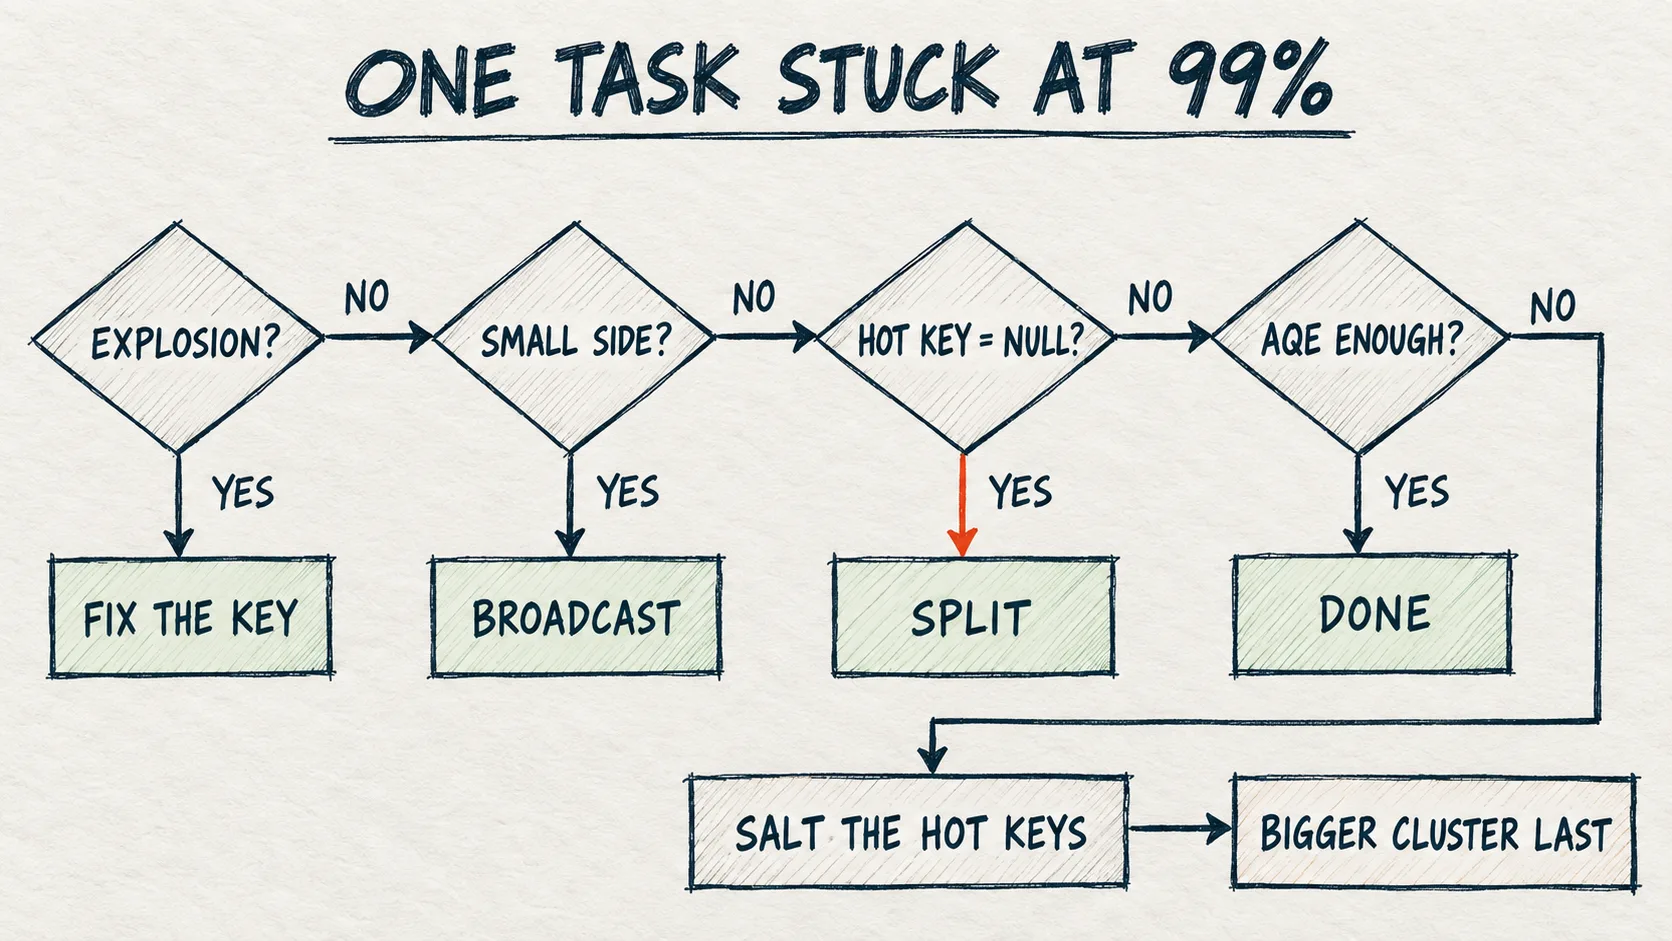
W jednym z projektów najbardziej skośny był klucz client_id: jeden klient miał 800 tys. zamówień, a pozostali po około 20 tys. Naprawa idzie wtedy w dwóch krokach, dokładnie jak w drzewku niżej: najpierw AQE, które przy joinie samo dzieli skośną partycję, a dopiero gdy to nie wystarcza, salting samego gorącego klucza.
Jak to działa
Shuffle rozdziela wiersze między partycje według hasha klucza. Wszystkie wiersze z tym samym kluczem trafiają do tej samej partycji, a jedną partycję przetwarza jeden task. Jeśli klucz CUST000001 ma 90% wierszy, to jeden task dostaje 90% pracy, niezależnie od tego, ile mamy rdzeni.
Spark ma na to trzy wbudowane mechanizmy i warto znać ich granice:
| Mechanizm | Co robi | Czego nie robi |
|---|---|---|
| AQE skew join | Dzieli za dużą partycję joina na kilka tasków i powiela dla nich odpowiadającą partycję drugiej strony | Działa tylko dla joinów z shuffle'em. Partycja musi być jednocześnie 5× większa od mediany i większa niż 256 MB (domyślne progi według dokumentacji; na serverless nie dało się ich odczytać). Nie działa dla FULL OUTER JOIN, a w LEFT OUTER dzieli tylko lewą stronę (w RIGHT OUTER tylko prawą) |
| Częściowa agregacja | groupBy z sum, count, max liczy wynik częściowy w każdym tasku przed shuffle'em, więc gorący klucz przesyła po jednym wierszu z taska |
Nie zmniejsza danych, gdy wynik częściowy musi zachować wszystkie elementy (collect_list, dokładne percentyle). Funkcje okna to osobny przypadek (krok 6) |
| Broadcast join | Mała strona trafia w całości do każdego executora, duża strona nie jest shufflowana | Wymaga, żeby jedna strona była mała. Statyczny próg Sparka (spark.sql.autoBroadcastJoinThreshold) to domyślnie 10 MB, a próg, przy którym AQE na Databricks zamienia join na broadcast w trakcie wykonania (spark.databricks.adaptive.autoBroadcastJoinThreshold), to 30 MB |
Z tabeli wynika, że na małych danych AQE nie uzna partycji za skośną, nawet jeśli ma 90% wierszy, bo zwykle nie przekroczy ona 256 MB po shuffle'u. Na dużych danych AQE często już skew rozwiązał, więc problem zostaje w środku: kilka GB na gorącym kluczu, agregacja, której wynik częściowy nie zmniejsza danych, albo join nieobsługiwany przez AQE.
Klasyczny klaster czy serverless: co się zmienia przy skew
| Klasyczny klaster (według dokumentacji) | Serverless | |
|---|---|---|
| Rozkład pracy między taski | Spark UI → Stages → „Summary metrics for tasks”, porównanie maksimum z 75. percentylem | Spark UI nie ma. Query profile może zgłosić insight DATA_SKEW, a rozkład klucza sprawdzamy zapytaniem GROUP BY ... ORDER BY cnt DESC |
Progi AQE (skewedPartitionFactor, skewedPartitionThresholdInBytes) |
możemy odczytać i zmienić przez spark.conf.set |
nie zmienimy. Na labie spark.conf.get zwrócił AnalysisException dla każdego klucza AQE, który sprawdzaliśmy |
Próg broadcastu (autoBroadcastJoinThreshold) |
ustawiamy sami | nie ma go na liście obsługiwanych configów, więc zostają hinty broadcast |
spark.sql.shuffle.partitions |
domyślnie 200 | domyślnie auto (tak zwrócił spark.conf.get na labie). Shuffle sort-merge joina miał u nas 21 partycji (na Free Edition 16) |
| Rozmiar i typ maszyn | dobieramy sami, łącznie z większymi workerami | nie wybieramy, serverless skaluje się sam |
Na klasycznym klastrze możemy więc najpierw stroić AQE, a na serverless od razu zostaje nam kod: hint broadcast, rozdzielenie NULL-i i salting. Wyniki w tym wpisie są z serverless, a to, co piszę o klasycznym klastrze (Spark UI, progi AQE), pochodzi z dokumentacji, nie z mojego testu.
Przy migracji na serverless trzeba usunąć z kodu odczyty nieobsługiwanych ustawień, bo notebook zatrzyma się już na pierwszym: [CONFIG_NOT_AVAILABLE.WITHOUT_SUGGESTION] Configuration spark.sql.adaptive.enabled is not available. Dodatkowo zapytania w jobie na serverless według dokumentacji nie mają domyślnego limitu czasu (2,5 h dotyczy tylko notebooków), dlatego job, który może zawisnąć, warto zabezpieczyć ustawieniem spark.databricks.execution.timeout (w sekundach).
Drzewko decyzyjne
0. Czy to na pewno skew?
Trzy problemy wyglądają podobnie w logach, a naprawia się je zupełnie inaczej:
- Eksplozja joina: wierszy wyjściowych jest wielokrotnie więcej niż wejściowych. Może dotyczyć jednego klucza, bo 10 tys. wystąpień po każdej stronie to 100 mln dopasowań i jeden bardzo wolny task, dlatego sprawdzamy liczność klucza po obu stronach i liczbę wierszy wyjściowych. Eksplozja i skew mogą wystąpić razem, a eksplozję naprawia klucz joina, nie compute.
- Spill we wszystkich taskach: partycje są za duże dla pamięci, ale równe. Pomaga więcej partycji albo wcześniejsze filtrowanie.
- Skew: jeden task (albo kilka) trwa wyraźnie dłużej niż reszta.
W Spark UI przewodnik Databricks uznaje stage za podejrzany, gdy maksimum jest o 50% lub więcej wyższe od 75. percentyla. Na serverless query profile (link See performance pod komórką) według dokumentacji zgłasza oprócz DATA_SKEW także EXPLODING_JOIN, czyli join, który zwraca dużo więcej wierszy, niż czyta. Insighty nie mówią jednak, który klucz robi skew, dlatego rozkład klucza sprawdzamy zapytaniem. W kodzie FACTS i DIM to tabele <catalog>.<schema>.skew_facts i skew_dim (domyślnie workspace.dataistheway), a facts i dim to ich DataFrame'y.
✓ Sprawdzone na Free Edition (2026-10-19)
display(spark.sql(f"""
SELECT customer_id,
       count(*)                                         AS cnt,
       round(100 * count(*) / sum(count(*)) OVER (), 2) AS pct
FROM {FACTS}
GROUP BY customer_id
ORDER BY cnt DESC
LIMIT 20
"""))
Jeśli pierwszy wiersz ma kilkadziesiąt procent, a drugi ułamek procenta, mamy gorący klucz, a jeśli pierwszym wierszem jest NULL, przechodzimy do kroku 3.
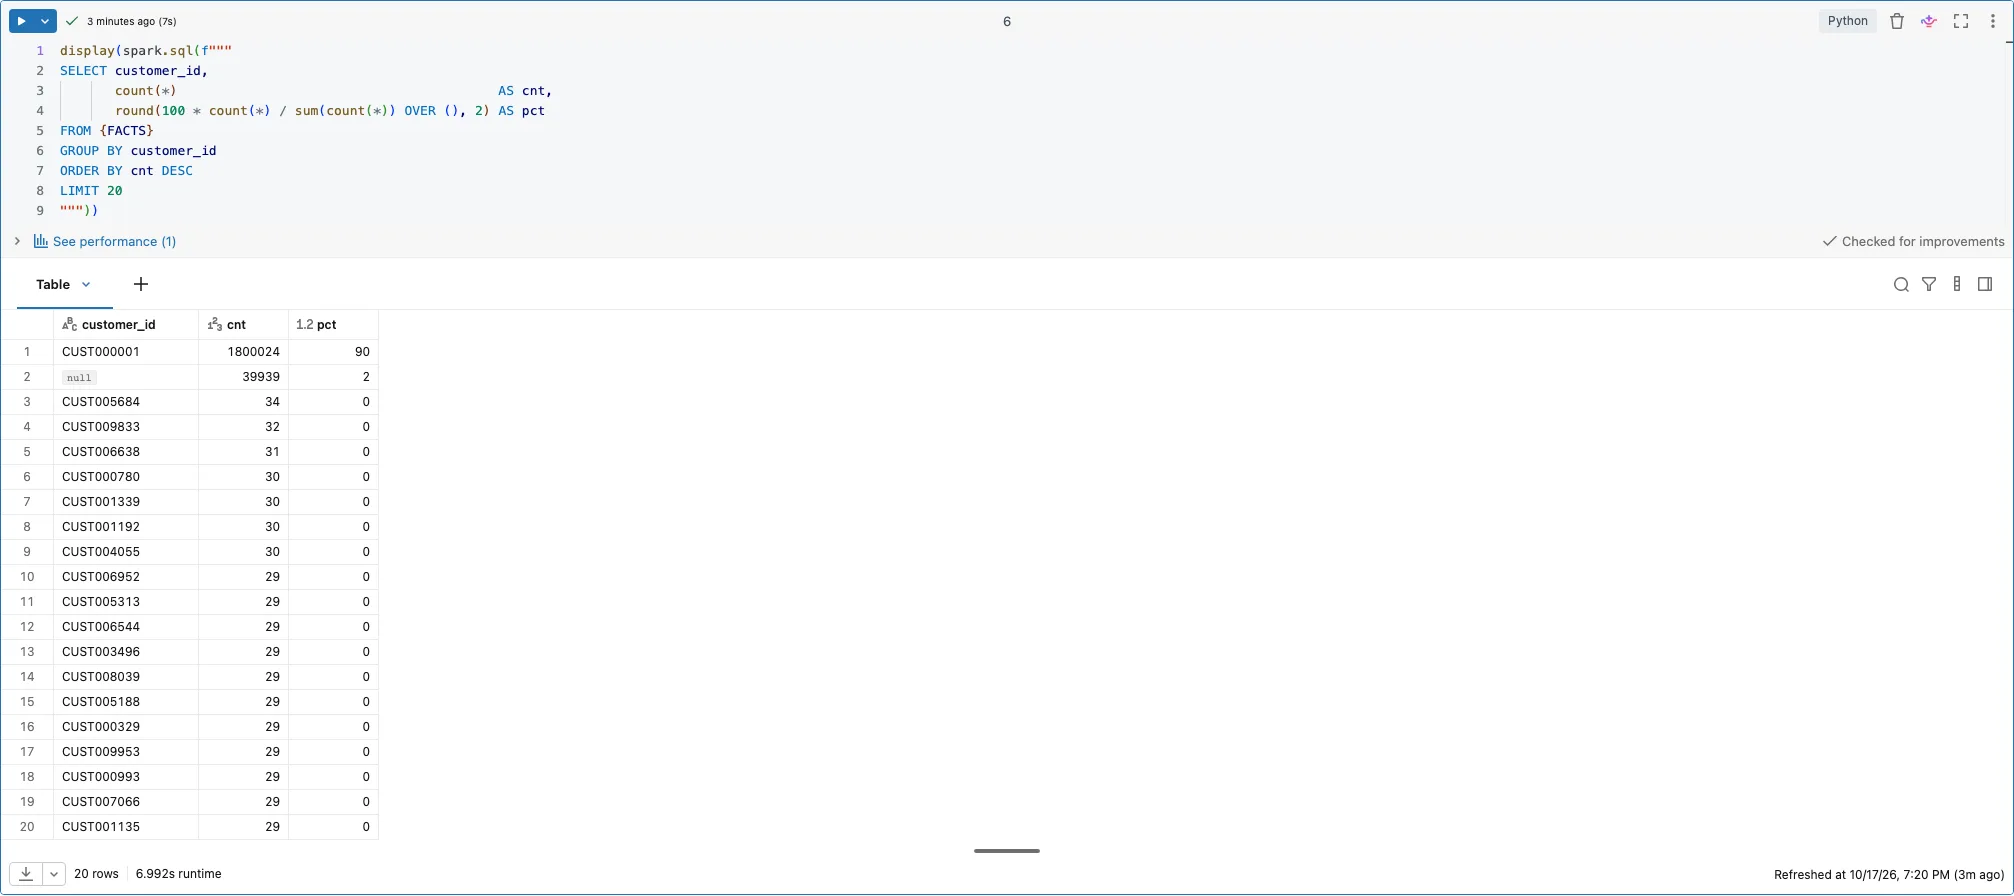
Wynik z labu: pierwsze wiersze zapytania o rozkład klucza.
1. Gdzie siedzi gorący klucz?
Każda operacja ma inne lekarstwo:
- join → kroki 2–5,
groupBy→ krok 6,- funkcja okna z
PARTITION BYpo gorącym kluczu → krok 6, - odczyt plików, np. jeden duży plik w formacie, którego nie da się podzielić, obok wielu małych → krok 7.
2. Czy jedna strona joina jest mała?
Jeśli tak, broadcast rozwiązuje problem u źródła, bo duża strona nie przechodzi przez shuffle i nie ma gorącej partycji. AQE sam wybiera broadcast, gdy po filtrach strona okaże się mała, a na serverless wymusimy go tylko hintem.
✓ Sprawdzone na Free Edition (2026-10-19)
bc = spark.sql(f"""
SELECT /*+ BROADCAST(d) */ f.*, d.segment
FROM {FACTS} f
JOIN {DIM} d ON f.customer_id = d.customer_id
""")
print("rows:", bc.count())
bc.explain()
Na labie plan pokazał PhotonBroadcastHashJoin bez shuffle'a po stronie faktów, a join zwrócił 1 960 061 wierszy, czyli 2 mln minus wiersze z NULL-em. Broadcastowana strona musi jednak zmieścić się w pamięci każdego executora, więc duży, szeroki wymiar to ryzyko OOM na driverze i executorach.
3. Czy gorącym kluczem jest NULL?
To najczęstszy „skew”, który wcale nie wymaga saltingu. Zachowanie zależy od typu joina:
- W inner joinie optymalizator sam dodaje filtr
isnotnull(klucz)po obu stronach, bo NULL nie spełni warunku równości, więc wiersze z NULL-em nie dochodzą do shuffle'a. Lepiej sprawdzić to w planie, niż dopisywać filtr w ciemno. - W left, right i full outer joinie wiersze z NULL-em muszą zostać w wyniku, więc wszystkie lądują w jednej partycji. Popularna rada, że „NULL-e i tak nie pasują w inner/left join”, jest tu błędna: w left joinie NULL-e nie pasują, ale nie znikają.
✓ Sprawdzone na Free Edition (2026-10-19)
facts.join(dim.hint("merge"), "customer_id", "inner").explain()
W planie inner joina filtr isnotnull(customer_id) był po obu stronach, więc 39 939 NULL-i odpadło przed shuffle'em.
Naprawa dla outer joina: odcinamy NULL-e przed joinem i doklejamy je z pustymi kolumnami wymiaru.
✓ Sprawdzone na Free Edition (2026-10-19)
nulls    = facts.filter(F.col("customer_id").isNull())
nonnulls = facts.filter(F.col("customer_id").isNotNull())

dim_cols = [c for c in dim.columns if c != "customer_id"]
left_joined = (
    nonnulls.join(dim, "customer_id", "left")
    .unionByName(nulls.select("*", *[F.lit(None).cast(dim.schema[c].dataType).alias(c)
                                     for c in dim_cols]))
)

plain_left = facts.join(dim, "customer_id", "left")
print("facts:", facts.count(), "| left_joined:", left_joined.count(), "| plain left join:", plain_left.count())
assert left_joined.count() == facts.count() == plain_left.count()
Przy unikalnym kluczu w wymiarze liczba wierszy musi się zgadzać z facts.count() i na labie obie wersje zwróciły po 2 000 000. Ten sam problem dotyczy groupBy po kolumnie z dużą liczbą NULL-i, bo grupa NULL jest jedną grupą i jednym taskiem.
4. Czy AQE już sobie radzi?
AQE jest domyślnie włączone na Databricks i gorącą partycję powyżej progów z tabeli podzieli sam. Na klasycznym klastrze widać to w Spark UI (zakładka SQL/DataFrame), gdzie węzeł SortMergeJoin ma isSkew=true, a progi możemy obniżyć. Na serverless progów nie zmienimy ani nie odczytamy, a podziału skośnej partycji na labie nie zobaczyłem, bo explain() przez Spark Connect pokazuje plan analizowany od nowa (na labie zawsze AdaptiveSparkPlan z isFinalPlan=false).
✓ Sprawdzone na Free Edition (2026-10-19)
# AQE settings (usually not readable on serverless)
for k in ["spark.databricks.optimizer.adaptive.enabled",
          "spark.sql.adaptive.enabled",
          "spark.sql.adaptive.skewJoin.enabled",
          "spark.sql.adaptive.skewJoin.skewedPartitionFactor",
          "spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes",
          "spark.sql.shuffle.partitions"]:
    try:
        print(f"{k:62s} = {spark.conf.get(k)}")
    except Exception as e:
        print(f"{k:62s} = not available ({type(e).__name__})")
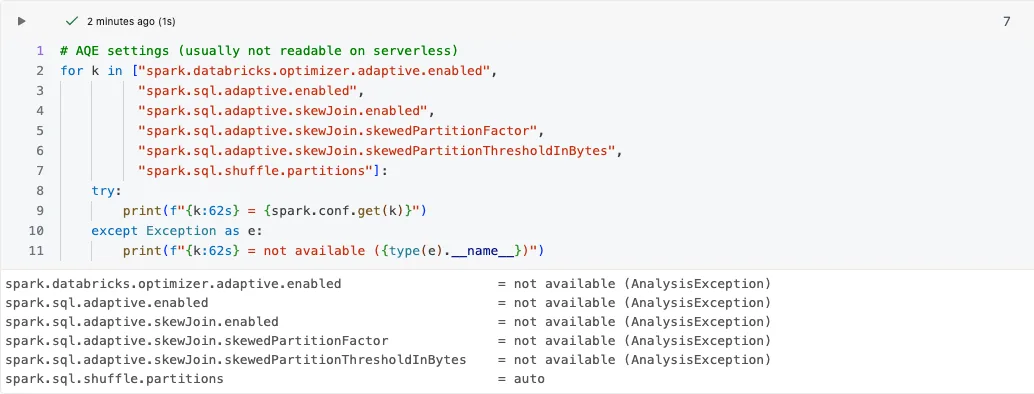
Wynik z labu: odczyt ustawień AQE przez spark.conf.get na serverless.
Drugi warunek to typ joina. AQE dzieli skośną partycję w inner i cross joinie po obu stronach, w left outer, left semi i left anti tylko po lewej, w right outer tylko po prawej, a full outer joina nie optymalizuje wcale. Jeśli gorący klucz siedzi po nieobsługiwanej stronie, zamiana stron joina nie pomoże, bo strona zachowywana zostaje ta sama, więc zostaje zmiana typu joina, broadcast albo salting.
Jeśli job wisi na jednym tasku mimo włączonego AQE, to operacja nie jest joinem, join nie jest obsługiwany, partycja nie przekracza progu albo gorący klucz jest za duży nawet po podziale, a wtedy przechodzimy do saltingu. Zamiast starszego hintu SKEW dokumentacja zaleca dziś obsługę skew w AQE, która zwykle jest szybsza.
5. Salting: tylko gorące klucze
Salting rozbija gorący klucz na N podkluczy. Po stronie faktów każdy wiersz gorącego klucza dostaje losową sól od 0 do N−1, a po stronie wymiaru wiersz tego klucza powielamy N razy, po jednym dla każdej soli, i join idzie po parze (klucz, sól). Często podawany próg orientacyjny: salting ma sens, gdy AQE nie wystarcza, a nierównowaga kluczy przekracza 100:1.
✓ Sprawdzone na Free Edition (2026-10-19)
import time

t0 = time.time()
plain_cnt = facts.join(dim.hint("merge"), "customer_id").count()
t_plain = time.time() - t0

N = 16
hot_keys = [r["customer_id"] for r in
            facts.groupBy("customer_id").count()
                 .filter("count > 100000").select("customer_id").collect()]
print("hot keys:", hot_keys)

facts_s = facts.withColumn(
    "salt",
    F.when(F.col("customer_id").isin(hot_keys), (F.rand() * N).cast("int"))
     .otherwise(F.lit(0)))

dim_s = (dim.withColumn(
            "salts",
            F.when(F.col("customer_id").isin(hot_keys), F.sequence(F.lit(0), F.lit(N - 1)))
             .otherwise(F.array(F.lit(0))))
            .withColumn("salt", F.explode("salts"))
            .drop("salts"))

t0 = time.time()
salted = facts_s.join(dim_s.hint("merge"), ["customer_id", "salt"]).drop("salt")
salted_cnt = salted.count()
t_salted = time.time() - t0

print(f"plain join  : {plain_cnt} rows, {t_plain:.1f}s")
print(f"salting     : {salted_cnt} rows, {t_salted:.1f}s")
assert plain_cnt == salted_cnt, "salted join changed the row count"
Hint merge wymusza sort-merge join, żeby mały wymiar z demo nie poszedł broadcastem (przy prawdziwym saltingu nie jest potrzebny), jednak Photon zgłosił węzeł SortMergeJoin jako nieobsługiwany, więc taki join idzie poza Photonem. Próg gorącego klucza (count > 100000) lepiej liczyć względnie, np. jako udział z kroku 0. NULL-i nie solimy, bo isin() ich nie dopasuje, dlatego obsługuje je krok 3.
Na labie gorącym kluczem był tylko CUST000001, a 1,6 s wobec 1,5 s to szum (w innych przebiegach raz szybszy był jeden, raz drugi), bo przy 2 mln wierszy skew jeszcze nie boli.
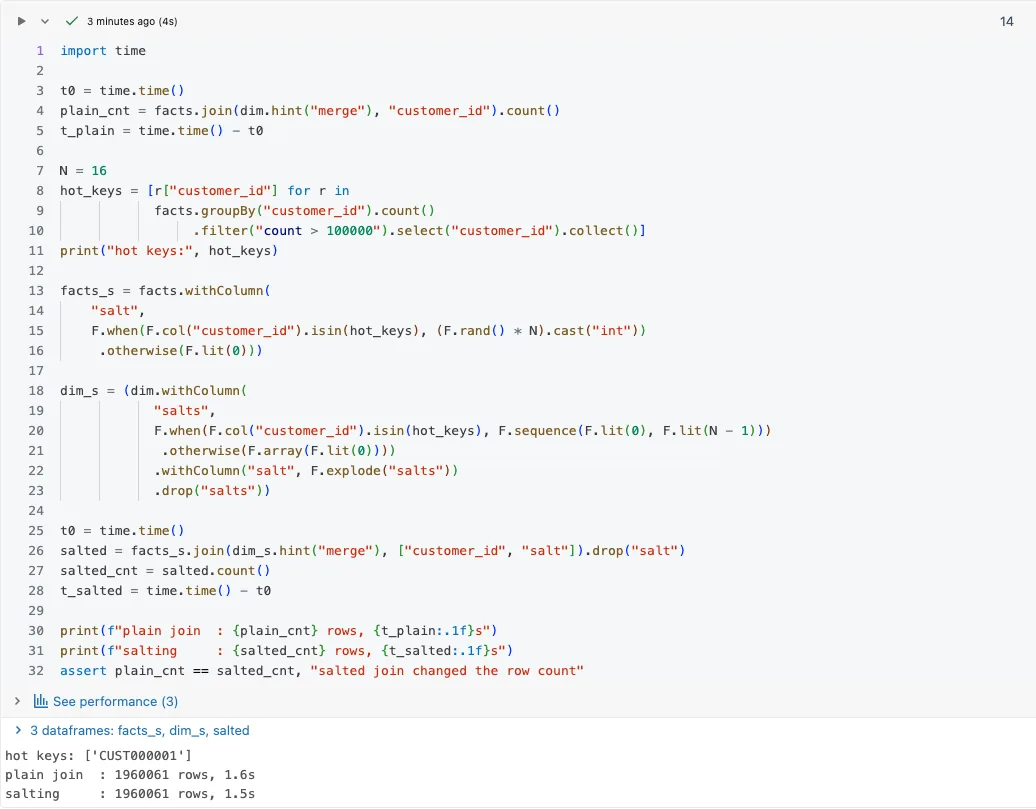
Wynik z labu: zwykły join i join z saltingiem, oba z hintem merge.
Salting widać za to w rozkładzie wierszy:
✓ Sprawdzone na Free Edition (2026-10-19)
# Row distribution after salting (an approximation of what each task gets)
display(facts_s.groupBy("customer_id", "salt").count().orderBy(F.desc("count")).limit(20))
Każda para (klucz, sól) to w przybliżeniu praca jednego taska joina, więc zamiast 1 800 024 wierszy pod jednym kluczem mamy 16 par po około 112 tys. wierszy.
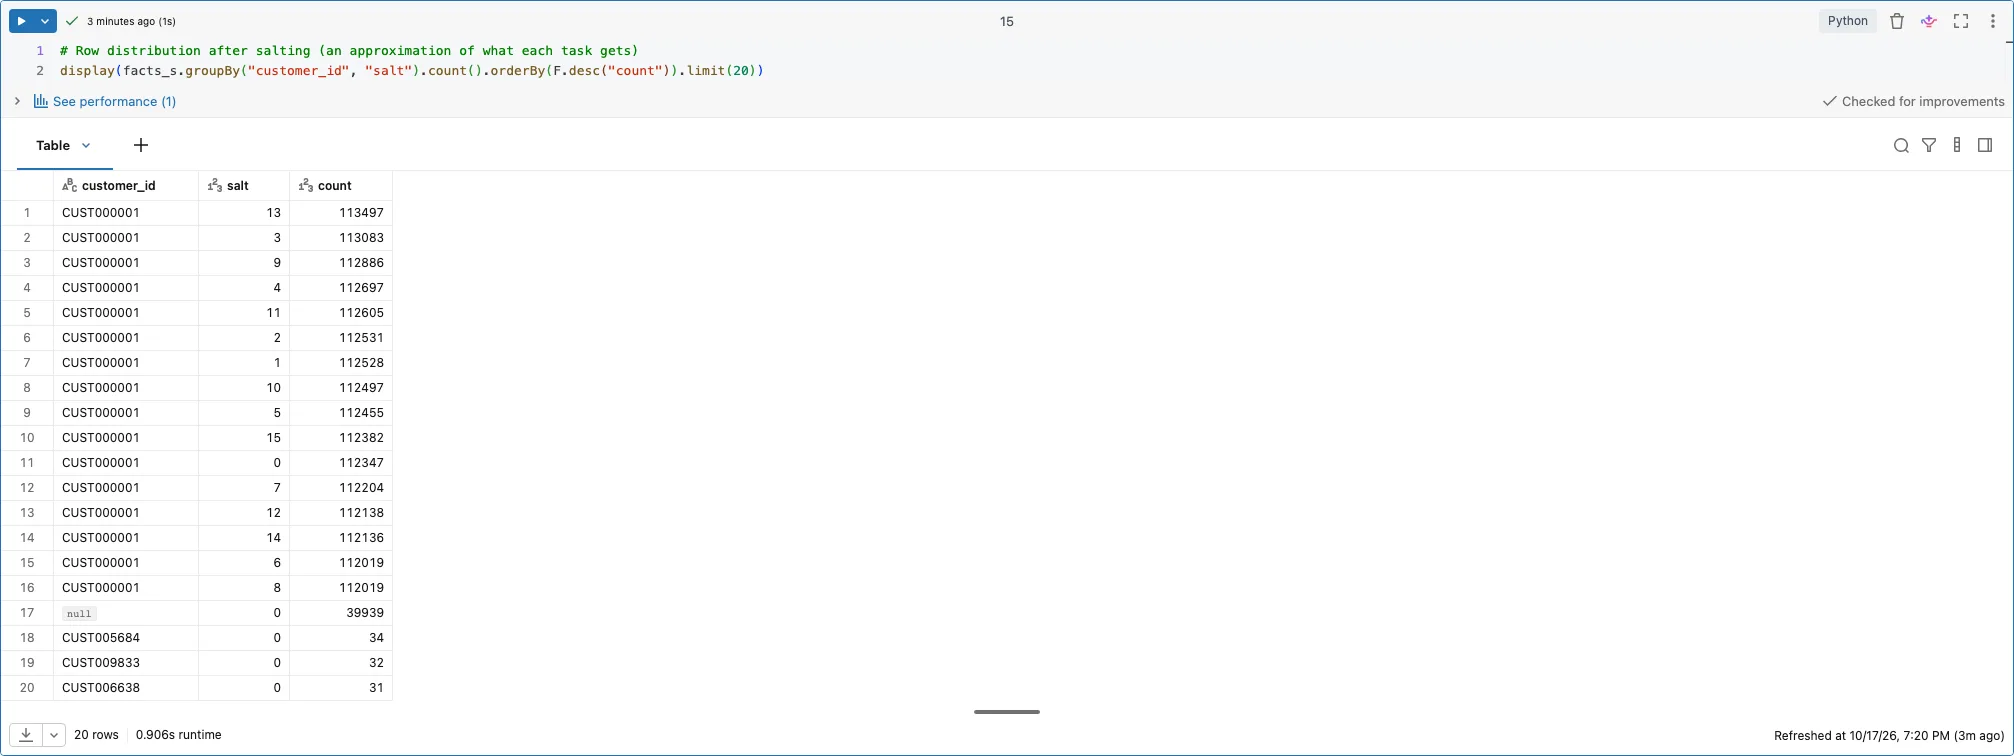
Wynik z labu: liczba wierszy na parę (klucz, sól) po soleniu.
Skoro Photon nie obsługuje SortMergeJoin, lepszy jest tam hint shuffle_hash, który też wymusza shuffle, ale join zostaje w Photonie, a AQE obsługuje skew także w shuffle hash joinie. Do pomiaru czasu lepszy jest kilkukrotny zapis do sinku noop niż count(), który pozwala Sparkowi pominąć kolumny niepotrzebne do policzenia wierszy.
✓ Sprawdzone na Free Edition (2026-10-19)
# The same two joins with shuffle_hash instead of merge, timed with the noop sink (3 runs each)
for name, df in [("plain join", facts.join(dim.hint("shuffle_hash"), "customer_id")),
                 ("salting", facts_s.join(dim_s.hint("shuffle_hash"), ["customer_id", "salt"]))]:
    times = []
    for _ in range(3):
        t0 = time.time()
        df.write.format("noop").mode("overwrite").save()
        times.append(round(time.time() - t0, 1))
    print(f"{name:12s}: {times} s")
df.explain()
Na labie plan miał węzeł PhotonShuffledHashJoin („The query is fully supported by Photon”), a czasy obu wariantów różniły się o dziesiąte części sekundy, które w innych przebiegach się zmieniały.
Koszt saltingu to kod do utrzymania, lista gorących kluczy, która się zmienia, oraz powielone wiersze w wymiarze, dlatego jest w drzewku tak późno.
6. Skośny groupBy i funkcje okna
Popularne zalecenie „repartition() + salting” dla skośnego groupBy miesza dwie rzeczy. Sam repartition() po tym samym kluczu szkodzi, bo przed tym shuffle'em nie ma częściowej agregacji, co widać w planie:
✓ Sprawdzone na Free Edition (2026-10-19)
# repartition() by the key before groupBy: where does the partial aggregation go?
facts.repartition("customer_id").groupBy("customer_id").agg(F.sum("amount")).explain()
facts.groupBy("customer_id").agg(F.sum("amount")).explain()
Na labie w pierwszym planie przed shuffle'em REPARTITION_BY_COL nie ma żadnej agregacji, więc wszystkie 1 800 024 wiersze gorącego klucza idą do jednej partycji, a w drugim partial_sum(amount) liczy się w każdym tasku przed shuffle'em.
Salting agregacji działa inaczej: agregujemy po parze (klucz, sól), a potem łączymy wyniki po samym kluczu. Pytanie brzmi więc, czy częściowa agregacja zmniejsza dane gorącego klucza:
- Przy
sum,count,min,maxiavgjuż to robi, więc drugi etap z solą jest zwykle zbędną pracą. count(DISTINCT x)Spark sam planuje w kilku krokach (najpierw usuwa duplikaty par (klucz, x) w każdym tasku), więc ręczne rozbicie nadistinct()icountnie jest optymalizacją.- Salting w dwóch etapach pomaga, gdy przed gorącą partycją nie ma częściowej agregacji, np. zaraz po joinie po tym samym kluczu albo przy
applyInPandas. Przycollect_listdrugi etap i tak zbiera wszystko w jednym tasku. - Funkcja okna
row_number() OVER (PARTITION BY customer_id ORDER BY ts)sortuje wszystkie wiersze klucza w jednym tasku. Najnowszy wiersz na klucz damax_byz częściową agregacją, a ponieważ przy remisieorder_tswybiera dowolny wiersz, w pipeline'ie dokładamy rozstrzygnięcie remisu, np.F.struct("order_ts", "order_id")jako drugi argument.
✓ Sprawdzone na Free Edition (2026-10-19)
# count(DISTINCT product_id) per customer: what Spark plans on its own
direct = facts.groupBy("customer_id").agg(F.countDistinct("product_id").alias("count"))

# the same written by hand in two steps; count("product_id") skips NULL like count(DISTINCT) does
two_step = (facts.select("customer_id", "product_id").distinct()
                 .groupBy("customer_id").agg(F.count("product_id").alias("count")))

print("rows that differ:", two_step.exceptAll(direct).count() + direct.exceptAll(two_step).count())

# compare the physical plans: look for an aggregate keyed by (customer_id, product_id) in both
direct.explain()
two_step.explain()
Na labie oba warianty dały ten sam plan (PhotonGroupingAgg po (customer_id, product_id) przed shuffle'em) i wynik. Spark bez Photona może najpierw zrobić shuffle po parze, co nie zmienia wniosku. W ręcznej wersji łatwo za to o błąd z NULL-ami:
✓ Sprawdzone na Free Edition (2026-10-19)
# NULL check: products [7, 7, NULL] -> count(DISTINCT) = 1; .count() after distinct() would give 2
t = spark.createDataFrame([("C1", 7), ("C1", 7), ("C1", None), ("C2", None)], "customer_id string, product_id int")
display(t.groupBy("customer_id").agg(F.countDistinct("product_id").alias("count_distinct"))
         .join(t.distinct().groupBy("customer_id").agg(F.count("product_id").alias("two_step_agg"),
                                                       F.count("*").alias("two_step_rows")), "customer_id")
         .orderBy("customer_id"))
count(DISTINCT x) pomija NULL, a .count() po distinct() liczy wiersze, więc dla klienta z produktami [7, 7, NULL] daje 2 zamiast 1, a dla klienta z samymi NULL-ami 1 zamiast 0. W danych z demo product_id nie ma NULL-i, więc tam błąd nie byłby widoczny.
Wzorzec saltingu w dwóch etapach pokazuję na sum, choć tu nie jest potrzebny:
✓ Sprawdzone na Free Edition (2026-10-19)
# salted two-stage aggregation: partial result per (key, salt), then merge per key
# (doubles summed in a different order can differ in the last bits, so compare rounded)
N = 16
# sum only shows the pattern: partial aggregation already handles sum on its own
salted_sum = (facts.withColumn("salt", (F.rand(42) * N).cast("int"))
                   .groupBy("customer_id", "salt").agg(F.sum("amount").alias("part"))
                   .groupBy("customer_id").agg(F.round(F.sum("part"), 2).alias("amount")))
plain_sum = facts.groupBy("customer_id").agg(F.round(F.sum("amount"), 2).alias("amount"))
print("rows that differ:", salted_sum.exceptAll(plain_sum).count())
Salted sum zgadza się ze zwykłym (0 różnic po zaokrągleniu do groszy). Najnowszy wiersz na klienta bez funkcji okna, przez max_by:
✓ Sprawdzone na Free Edition (2026-10-19)
# latest order per customer without a window function
latest = (facts.groupBy("customer_id")
               .agg(F.max_by(F.struct(*facts.columns), F.col("order_ts")).alias("r"))
               .select("r.*"))
display(latest.orderBy("customer_id").limit(10))
Dla collect_list po gorącym kluczu dobrej odpowiedzi nie ma, bo wynik i tak jest jedną ogromną tablicą w jednym wierszu, co grozi OOM. Wtedy pytamy, czy ta tablica jest w ogóle potrzebna.
7. Skew w danych na dysku
Skośne taski mogą pojawić się już przy odczycie, ale duży plik nie oznacza jednego taska. Spark dzieli Parquet, Delta i nieskompresowany CSV na kawałki (domyślnie do 128 MB, spark.sql.files.maxPartitionBytes). Jeden task na plik dostajemy przy formacie niepodzielnym, np. CSV albo JSON skompresowanym gzipem, oraz przy opcji multiLine.
Dlatego najpierw sprawdzamy format i kompresję plików. Przy niepodzielnym formacie pomaga jednorazowe przepisanie do Delty, a OPTIMIZE i Liquid Clustering pomagają głównie przy wielu małych plikach i partycjonowaniu niepasującym do filtrów (dokumentacja wymienia też tabele z mocno przekrzywionymi danymi). Przy skew na zapisie hint /*+ REBALANCE */ dzieli zbyt duże partycje wyjściowe (tylko z włączonym AQE).
8. Większy klaster: na końcu
Więcej executorów nie pomaga, bo gorąca partycja i tak trafia do jednego taska. Większy węzeł może pomóc na OOM, ale leczy objaw. Dlatego naprawiamy klucz, nie klaster.
Pułapki
- Salting całego klucza: powielenie całego wymiaru N razy potrafi być droższe niż sam skew, dlatego solimy tylko klucze z listy gorących.
- Salt z
rand()bez kontroli wyniku: po zmianie joina porównujemy liczbę wierszy ze zwykłym joinem, bo braksaltpo jednej stronie warunku daje cichą eksplozję. - Lista gorących kluczy na sztywno: rozkład się zmienia, więc listę trzymamy w tabeli konfiguracyjnej odświeżanej osobnym jobem albo liczymy na próbce, a nie pełnym skanem w każdym runie.
- Szukanie skew, gdy problemem jest eksplozja: jeden wolny task jej nie wyklucza, więc najpierw porównujemy wiersze wejściowe i wyjściowe joina.
Kiedy NIE używać
Saltingu i ręcznego rozbijania agregacji nie stosujemy „na zapas”. Jeśli job kończy się w akceptowalnym czasie, AQE i broadcast zwykle wystarczają, a ręczna optymalizacja to dodatkowy kod do utrzymania. Nie pomogą też przy złym modelu danych, np. joinie faktów z faktami po kluczu nieunikalnym w obu tabelach, bo tam trzeba zmienić model, a nie plan zapytania.
Zobacz, jak to działa
Na nagraniu cały notebook z labu, krok po kroku w tej samej kolejności co w tekście.
Kod z tego artykułu na GitHubie →notebook i README krok po kroku · data-skew-decision-tree
Dane są syntetyczne i generowane w notebooku, więc wyniki można odtworzyć na własnym workspace'ie.
Chcesz kolejne wpisy? Obserwuj przez RSS albo na LinkedInie.
Komentarze
Na razie cisza na szlaku. Napisz pierwszy komentarz.