
 Krzysztof Burejza
Artykuł powstał na bazie mojej prelekcji „Multi-Agent Data Engineering: Claude, Codex, Local AI and Databricks with Omnigent” na 4. spotkaniu Warsaw Databricks Community (27.10.2026). Na prelekcji miałem 45 minut i sześć nagranych demo, więc tutaj mogę dopisać szczegóły, na które nie starczyło czasu. Pracuję w Databricks jako Resident Solutions Architect, ale bloga prowadzę prywatnie, a opinie w nim są moje.
Wersja Omnigent: demo nagrywałem 26–27.10.2026 na Omnigent 0.20.0 w buildzie deweloperskim (commit 611429347, z jedną lokalną poprawką w deploy.py). Stabilne 0.20.0 wyszło 28.10.2026, dzień po prelekcji, a mój build jest od niego o około 50 commitów starszy. Projekt jest w wersji alpha i zmienia się bardzo szybko, więc w nowszych wersjach komendy, nazwy polityk i interfejs mogą się zmienić.
Problem
Przez ostatni rok większość z nas pracowała z jednym asystentem AI. Prosimy go o pipeline, a potem o review tego samego kodu i zwykle słyszymy, że wszystko wygląda dobrze. Recenzent ma jednak te same założenia co autor, bo to ten sam model z tym samym kontekstem. Od tego pytania zacząłem prelekcję: „Who reviews the reviewer?”
Żeby review miało co znaleźć, w danych demo zostawiłem pułapkę. Zwroty przychodzą jako osobne zdarzenia z dodatnią ilością, więc proste SUM(quantity * unit_price) liczy zwrot jak sprzedaż. Na danych demo taka suma daje 372 479,64, czyli o 23 944,09 (wartość zwrotów) więcej niż sprzedaż brutto 348 535,55 i o 47 888,18 więcej niż prawidłowy przychód netto 324 591,46. Zakładałem, że błąd wyłapie dopiero drugi model w roli recenzenta, ale stało się to wcześniej, w planie (opisuję to przy demo 3).
Dlaczego więcej niż jeden agent
Powody są podobne jak w zespole ludzi, gdzie mamy code review i podział ról. Każdy agent może mieć inne zadanie (planista, implementer, recenzent, skaner) oraz inny model. Model innego dostawcy może łapać inne błędy niż ten, który napisał kod. Wrażliwy kod możemy dać do sprawdzenia modelowi lokalnemu, a model w chmurze używać tam, gdzie to się opłaca. Dodatkowo dużą pracę, np. migrację kilkudziesięciu notebooków, można rozdzielić na kilku agentów naraz.
Warto jednak pamiętać, że N agentów nie daje N razy lepszego wyniku. Dochodzi koordynacja, wyższy rachunek, dłuższy czas, konflikty przy edycji tych samych plików oraz pytanie, kto odpowiada za wynik. Dlatego potrzebujemy warstwy, która tym zarządza, i w moich demo był to Omnigent.
Czym jest Omnigent
Omnigent to open-source'owy control plane (w dokumentacji nazywany meta-harness) dla agentów do kodu, takich jak Claude Code, Codex, Pi, Cursor czy Copilot. Harness to po prostu program agenta, który Omnigent uruchamia. Omnigent prowadzi agentów jako sesje, które możemy współdzielić, objąć politykami i orkiestrować. Nie zastępuje Claude Code ani Codexa, tylko daje im wspólne miejsce do pracy.
Na Databricks jest też wersja zarządzana (Beta, włącza ją admin workspace'u na stronie Previews), ale tylko w regionach z Unity Gateway i bez własnych polityk w Pythonie (wspiera polityki w CEL). Dlatego w demo postawiłem serwer samodzielnie na Databricks Apps.
Architektura na Databricks
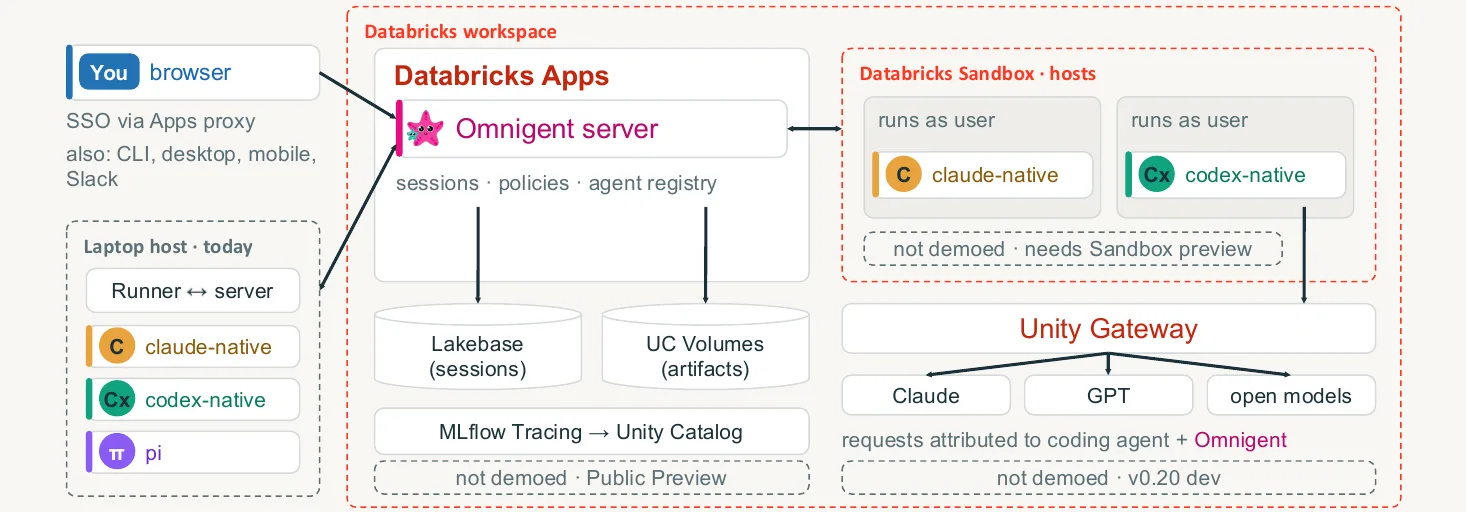
Serwer Omnigent działa jako Databricks App, więc logowanie idzie przez proxy Apps, czyli przez SSO workspace'u (u mnie Entra ID). Sesje i historia są w Lakebase (Postgres), a artefakty w Unity Catalog Volume. Sam agent działa na hoście, u mnie na MacBooku zarejestrowanym na serwerze. Sesja żyje na serwerze, a agent pracuje na hoście, dlatego tę samą sesję widzimy w terminalu i w przeglądarce.
Na diagramie są też trzy rzeczy, których nie pokazywałem: hosty w Databricks Sandbox (Beta, wymaga włączenia w Previews, wybrane regiony), atrybucja wywołań modeli w Unity Gateway (od Omnigent 0.20.0) oraz MLflow Tracing do Unity Catalog (GA od lipca 2026). Opisuję je na podstawie dokumentacji, nie testowałem ich.
Agent to folder z YAML
Każdy agent ma swój config.yaml z wyborem harnessu (Claude Code, Codex, Pi), promptem, listą sub-agentów i guardrailami. Sub-agent to podfolder z własnym config.yaml, a skill to plik Markdown. Guardraile to polityki Omnigent, np. blast_radius blokuje force-push i destrukcyjne komendy oraz pyta przed pushem albo deployem, a spawn_bounds ogranicza, ilu sub-agentów można uruchomić w jednej turze. Jeden zestaw polityk działa na wszystkie harnessy przez ich hooki. Warto tutaj dodać, że to kontrola tego, co agent może zrobić w sesji Omnigent, a nie granica bezpieczeństwa wobec ludzi, bo kto ma dostęp do laptopa, uruchomi Claude Code albo Codexa poza Omnigent.
Na start nie potrzebujemy kluczy API. Logujemy się do Claude Code i Codexa planami, które już mamy (Claude Pro/Max, plan ChatGPT), a według dokumentacji Omnigent sam wykrywa te logowania (omni setup). Tego kroku nie nagrywałem, bo harnessy miałem już skonfigurowane. Można też podać klucz API, gateway zgodny z OpenAI albo Anthropic (OpenRouter, LiteLLM, Ollama, vLLM, Azure) albo profil Databricks z Foundation Models / Unity Gateway. Moje dema działały na prywatnych subskrypcjach i tylko w labie. W zespole lepiej użyć API i Unity Gateway, żeby zużycie było rozliczane i przypisane do konkretnych osób.
Sześć demo
Wszystkie nagrania są z labu: Omnigent na Databricks Apps w workspace'ie Azure (trial Premium), a hostem był MacBook z 36 GB RAM. Dane i pipeline to bundle retailhub, czyli generator danych oraz warstwy bronze i silver w Lakeflow. Warstwy gold celowo nie ma, bo jej zbudowanie to zadanie dla agentów. Czekanie w filmach jest przyspieszone (oznaczenie „▶▶ ×N”), a angielskie napisy są wtopione w obraz.
Demo 1: Omnigent w workspace'ie Databricks
Deploy serwera to projekt Lakebase i wolumen w Unity Catalog, deploy.py --no-otel, nadanie service principalowi aplikacji uprawnień do Lakebase (grant_sp_perms.py) i ponowny deploy. Nagranie zaczyna się już po deployu i pokazuje zasoby aplikacji (postgres to Lakebase, artifact_volume to wolumen na artefakty), host online i skonfigurowane harnessy.
Następnie uruchamiam Claude Code w terminalu na Macu:
✓ Sprawdzone na workspace'ie Premium (trial Azure, 2026-10-26): serwer na Databricks Apps, agent lokalnie na hoście; Free Edition nie sprawdzałem
omnigent claude
Sesja od razu pojawia się w przeglądarce, razem z widokiem terminala. Pytanie wpisane w przeglądarce trafia do tej samej sesji i Claude odpowiada w terminalu. Pierwsza odpowiedź zajęła 1 min 37 s, w filmie jest przyspieszona. Na koniec udostępniam sesję drugiemu użytkownikowi z prawem Edit. Widzi ten sam transkrypt i terminal, a jego wiadomości mają jego awatar. Wiadomości kolegi obsługuje jednak Claude Code na moim hoście i na mojej subskrypcji, dlatego w zespole każdy powinien pracować na własnym planie albo kluczu API, najlepiej przez Unity Gateway.
Kod z tego artykułu na GitHubie →notebook i README krok po kroku · multi-agent-de-omnigent
Demo 2: Debby, czyli Claude kontra GPT
Debby to wbudowany agent, który ma prowadzącego na claude-sdk, dwóch sub-agentów (Claude i GPT, przy czym GPT działa przez harness Codexa) oraz skill do debaty. Obu zadałem to samo pytanie projektowe dla warstwy gold: materialized view czy streaming table i jak liczyć zwroty. Debby nagrywałem po demo z Polly, dlatego Claude widzi w repo już gold.sql z PR #1.
Obaj doszli do tego samego wniosku: materialized view z kolumnami przychodu brutto, zwrotów i netto. Po komendzie /debate każdy skrytykował odpowiedź drugiego i przyznał mu kilka racji. Uzasadnienie stało się dokładniejsze, ale werdykt się nie zmienił. Otwarte pytania, czyli jak ostre mają być expectations i gdzie robić deduplikację, Debby zostawiła do mojej decyzji. Odpowiedzi zajęły około 3 minut, a runda debaty około 10.
Demo 3: Claude buduje, Codex recenzuje
Polly to wbudowany orkiestrator Omnigent. Deleguje pracę i prosi o review model innego dostawcy, ale sama nie pisze kodu i nigdy nie robi merge'a. Zadanie wpisałem w przeglądarce, a Polly prowadziła je w sześciu krokach:
Add a gold layer to the retailhub pipeline in demo/: daily revenue per store and product category, with expectations (non-null keys, revenue >= 0). Open a PR. Claude Code implements, Codex reviews. Work in English.
- Plan (2 min 2 s). Polly przeczytała
generate_data.pyi jeszcze przed napisaniem kodu wpisała pułapkę do planu: zwroty przychodzą jako dodatnie wiersze, a część zdarzeń nie mastore_id. - Implementacja (8 min 57 s). Claude Code w osobnym git worktree napisał
gold.sql, uruchomiłbundle validate, deploy i przebieg pipeline'u w labie (targetdev, moim profilem CLI, 1 683 wiersze), a potem otworzył PR #1. Przychód liczy netto, więc pułapka nie doszła do recenzenta. - Limit Codexa. Pierwsze review Codexa zatrzymało się po 2 sekundach na limicie planu ChatGPT. Polly nie zmieniła dostawcy bez pytania. Zrobiła tymczasowe review lokalnym modelem, które dało „PASS”, ale z odwróconą logiką znaku, więc oznaczyła je jako niewiążące i czekała na Codexa (w filmie jest o tym tylko jeden napis). Po resecie limitu dałem jej znać wiadomością „Codex quota is back…”, bo jej timer jeszcze nie ruszył.
- Review Codexa (2 min 15 s) z wynikiem PASS i trzema uwagami. Polly przyjęła dwie z nich: unikalność sklepów nie jest wymuszona, więc zduplikowany wiersz wymiaru pomnożyłby przychód, a komentarz w kodzie obiecuje więcej, niż sprawdzają expectations, bo
COALESCEukrywa klucze NULL. Trzecią odrzuciła z uzasadnieniem: Codex chciał opisać liczby wierszy jako wynik z danych testowych, a Polly sprawdziła je na przebiegu w labie. - Na moje polecenie Polly odesłała obie uwagi do Claude Code. Poprawki zajęły 6 min 16 s, a ponowne review Codexa 2 min 11 s i skończyło się PASS z zamkniętymi uwagami. Codex dorzucił jedną nową, hipotetyczną uwagę, którą zostawiłem do decyzji.
- PR #1 jest otwarty, a merge robię ja, nie Polly.
Najważniejsza część rozwiązania z PR #1 to znak przy każdym zdarzeniu (pełny gold.sql jest w repo z kodem):
✓ Sprawdzone na workspace'ie Premium (trial Azure, 2026-10-26): Lakeflow Spark Declarative Pipelines na serverless, 1 683 wiersze; Free Edition nie sprawdzałem
CASE WHEN o.event_type = 'RETURN' OR o.status = 'RETURNED' THEN -1 ELSE 1 END AS sign,
...
CAST(SUM(sign * gross_amount) AS DECIMAL(18, 2)) AS revenue,
CAST(SUM(CASE WHEN sign > 0 THEN gross_amount ELSE 0 END) AS DECIMAL(18, 2)) AS gross_revenue,
CAST(SUM(CASE WHEN sign < 0 THEN gross_amount ELSE 0 END) AS DECIMAL(18, 2)) AS returned_revenue,
Warunek OR nie liczy zwrotu podwójnie, bo w generatorze danych status RETURNED mają tylko zdarzenia zwrotu, a wiersz sprzedaży swojego statusu nie zmienia. Zwrot dostaje -1, więc revenue to przychód netto, a brutto i zwroty są w osobnych kolumnach. Zwroty księgujemy w dniu zwrotu, dlatego przychód netto w danym dniu może wyjść ujemny i na danych demo dotyczy to 95 z 1 683 wierszy. Z tego powodu expectation revenue >= 0 tylko ostrzega, a twarde warunki (FAIL UPDATE) są na trzech kluczach i na gross_revenue >= 0. Agent sam złagodził tu wymaganie z mojego polecenia (revenue >= 0). Uzasadnienie jest dobre, ale to decyzja biznesowa, którą powinien zatwierdzić człowiek, a nie model w roli recenzenta.
Cały przebieg z Polly to około 25 minut pracy agentów (plus czekanie na reset limitu Codexa) i 8,47 USD według cennika z omnigent usage, z czego 7,49 USD za Claude'a i 0,98 USD za dwa review Codexa. To jednak tylko szacunek, bo faktycznie płaciłem w ramach subskrypcji Claude Max i ChatGPT.
Demo 4: lokalny model jako prywatny recenzent
W tym demo używam Pi z modelem qwen3-coder 30B (build z kontekstem 32k) w Ollamie, na MacBooku z 36 GB RAM. Na liście modeli są tylko modele lokalne z Ollamy. Poprosiłem o review PR #1 i silver.sql pod kątem danych osobowych i expectations.
Model znalazł prawdziwą lukę: customer_name i customer_email trafiają do silver bez maskowania, i zaproponował column mask (w praktyce column mask albo widok/ABAC, zależnie od polityki dostępu). Zajęło mu to 54 sekundy (w drugim podejściu, bo pierwsze trwało 104 sekundy i dało mniej konkretną odpowiedź) i kosztowało 0 USD kosztu API. Miał też jeden fałszywy alarm (twierdził, że klucze w gold nie mają expectations, a mają) i przybliżone numery linii. Na pierwszy przebieg to wystarczy, ale na takim review nie opierałbym decyzji o merge'u. Kodu nie widzi żaden dostawca modelu (o tym, gdzie trafia transkrypt, piszę w pułapkach).
Demo 5: prywatne review, model w chmurze nie widzi plików
W tym demo chciałem rozdzielić czytanie kodu od oceny review. Agent private-review ma dwie role. local_reviewer (Pi w Ollamie) czyta silver.sql i diff PR #1 na laptopie. Sędzia (Claude na claude-sdk) nie dostaje od harnessu narzędzi do plików ani powłoki i ocenia tylko tekst review, a pozostałe narzędzia, np. ui_open_file z interfejsu Omnigent, blokuje polityka. Pokazuję jedną z czterech polityk tego agenta, pozostałe są w pełnym pliku w repo z kodem:
✓ Sprawdzone na workspace'ie Premium (trial Azure, 2026-10-27): serwer Omnigent, local_reviewer lokalnie w Ollamie; Free Edition nie sprawdzałem
guardrails:
  policies:
    tool_allowlist:
      type: function
      function:
        path: omnigent.policies.builtins.cel.cel_policy
        arguments:
          expression: >-
            event.type != "tool_call" ? {"result": "ALLOW"} :
            (has(event.data.name) && event.data.name in
            ["sys_session_send", "sys_read_inbox", "sys_cancel_task", "ToolSearch",
            "read", "grep", "find", "ls"])
            ? {"result": "ALLOW"}
            : {"result": "DENY", "reason": "private-review: the cloud judge may only dispatch local_reviewer and read its final report; local_reviewer may only read files. Shell, write, browser and session-history tools are blocked."}
    # ... reviewer_stays_local, review_pii_gate, pii_in_user_message
Sędzia ocenił review jako „low-to-medium trust”. Bez czytania plików zauważył, że recenzent zgłosił sprawdzenie bronze.sql, którego w ogóle nie czytał, że jedno znalezisko ma odwróconą logikę oraz że numery linii się nie zgadzają. Lokalne review zajęło około 50 sekund, a całość od promptu do werdyktu około 2,5 minuty, razem z jedną rundą dopytania.
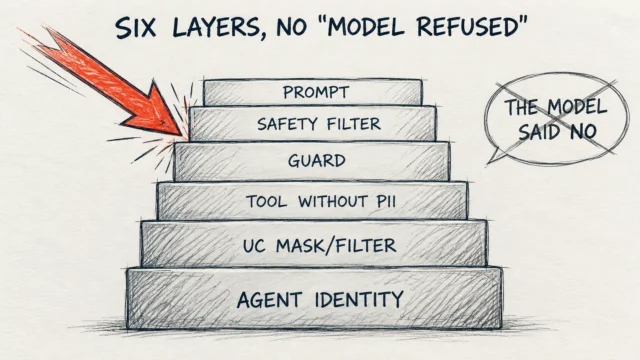
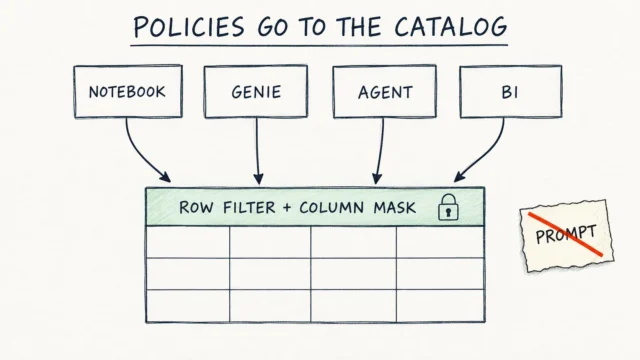
Na koniec poprosiłem sędziego, żeby otworzył silver.sql. Najpierw odmówił, ale tylko dlatego, że tak każe mu prompt. Potem kazałem mu wprost wywołać narzędzie ui_open_file i wtedy serwer odrzucił wywołanie z komunikatem „Denied by policy”. Blokada działa więc niezależnie od tego, czy model zachowa się tak, jak go poprosimy. Ten sam pomysł opisałem szerzej we wpisach Polityki idą do katalogu, nie do promptu i Sześć warstw obrony agenta.
Ochrona ma tu dwie osobne warstwy: sędzia nie dostaje od harnessu narzędzi do plików ani powłoki, a polityka CEL odrzuca resztę wywołań. Sama allowlista przepuściłaby read, bo potrzebuje go local_reviewer. Co jest wymuszone przez konfigurację i polityki Omnigent, a co tylko w prompcie:
| Wymuszone przez konfigurację i polityki Omnigent | Tylko w prompcie |
|---|---|
Sędzia nie ma narzędzi harnessu do plików ani powłoki, a ui_open_file blokuje polityka |
Co lokalny model zdecyduje się napisać w raporcie |
| Odczyt historii sesji i zmiana modelu są zablokowane | |
| Review zawierające adres e-mail nie trafia do sędziego |
Filtr review łapie jednak tylko adresy e-mail, więc imiona czy numery telefonów w raporcie by przeszły. Do tego connectory na poziomie konta w CLI modelu chmurowego są poza tą polityką i przy wrażliwej pracy trzeba je wyłączyć.
Demo 6: własny agent
W ostatnim demo zbudowałem własny zespół, lakehouse-reviewer. To cztery pliki config.yaml i jeden skill z checklistą. Poniżej pokazuję je bez promptów, pełne pliki są w repo z kodem.
lakehouse-reviewer/
  config.yaml                  # lead, claude-sdk
  agents/implementer/          # Claude Code
  agents/reviewer/             # Codex
  agents/local_scanner/        # Pi + Ollama
  skills/review-dabs/SKILL.md
Prowadzący nie pisze kodu. Planuje, deleguje i scala wyniki:
✓ Sprawdzone na workspace'ie Premium (trial Azure, 2026-10-26): serwer Omnigent, local_scanner lokalnie w Ollamie; Free Edition nie sprawdzałem
name: lakehouse-reviewer
executor:
  type: omnigent
  config:
    harness: claude-sdk
tools:
  agents:
    - implementer
    - reviewer
    - local_scanner
guardrails:
  policies:
    blast_radius:
      type: function
      function:
        path: omnigent.inner.nessie.policies.blast_radius
    spawn_bounds:
      type: function
      function:
        path: omnigent.inner.nessie.policies.spawn_bounds
        arguments:
          max_dispatches_per_turn: 4
W nowszych wersjach te same polityki są pod omnigent.policies.builtins.orchestration, a stara ścieżka zostaje dla zgodności. Lokalny skaner to kilka linijek:
✓ Sprawdzone na workspace'ie Premium (trial Azure, 2026-10-26): serwer Omnigent, local_scanner lokalnie w Ollamie (Pi + qwen3-coder 30B, MacBook 36 GB); Free Edition nie sprawdzałem
name: local_scanner
executor:
  type: omnigent
  config:
    harness: pi
    model: ollama/qwen3-coder-32k:latest
Agenta uruchomiłem z listy agentów w przeglądarce i poprosiłem o review PR #1. Codex i lokalny model pracowały równolegle, Codex przez 1 min 25 s, a lokalny skaner przez 1 min 54 s. Cały przebieg, od polecenia do scalonej tabeli, trwał 4 min 41 s i kosztował 0,97 USD (prowadzący na Claude 0,53 USD, Codex 0,44 USD). Wynik: 5 blockerów, 1 major i 1 minor. Oba modele zgłosiły tylko jedno wspólne znalezisko, czyli dane osobowe bez maskowania w silver. Pozostałe blockery znalazł Codex: zduplikowane zdarzenia, statusy inne niż sprzedaż i zwrot liczone jako przychód, expectations sprawdzane na złym poziomie agregacji oraz fan-out przy joinie w silver. Prowadzący nie uruchomił przy tym bundle validate i sam zaznaczył to w tabeli jako lukę w weryfikacji.
Takiego agenta możemy udostępnić na trzy sposoby. Prywatnie, gdzie omnigent agent add daje nam własną kopię, którą widzimy tylko my:
✓ Sprawdzone na workspace'ie Premium (trial Azure, 2026-10-26): serwer Omnigent; Free Edition nie sprawdzałem
omnigent agent add agents/lakehouse-reviewer
W zespole agent jest folderem w git, więc przechodzi przez pull requesty jak każdy kod, a koledzy instalują go prosto z repozytorium (tego wariantu nie testowałem). W całej organizacji operator serwera publikuje go jako agenta serwerowego, u mnie było to częścią deployu na Databricks Apps. W nagraniu drugi użytkownik widzi lakehouse-reviewer w Settings → Custom agents bez żadnej instalacji.
Chmura kontra lokalnie
Najuczciwsze porównanie daje demo 6, bo tam oba modele pracowały w tym samym przebiegu nad tym samym PR. Codex dostał pełną checklistę, a lokalny skaner tylko dane osobowe i expectations, więc zadania nie były identyczne:
| Codex (chmura) | Pi + qwen3-coder 30B (lokalnie) | |
|---|---|---|
| Czas review w demo 6 | 1 min 25 s | 1 min 54 s |
| Koszt review w demo 6 | 0,44 USD | 0 USD kosztu API |
| Znaleziska | Precyzyjne, z plikiem i linią | Dane osobowe znalezione, 1 fałszywy alarm, przybliżone linie (demo 4) |
| Tymczasowe review przy limicie Codexa (demo 3) | nie dotyczy | „PASS” z odwróconą logiką znaku, Polly to wyłapała |
| Kod wysłany do dostawcy modelu | Tak | Nie |
Koszty to szacunki według cennika z omnigent usage, a faktycznie płaciłem w ramach subskrypcji Claude i ChatGPT.
Zaskoczyło mnie, że ten sam PR dostał dwa bardzo różne werdykty. Codex wywołany przez Polly patrzył tylko na diff warstwy gold i dał PASS z trzema drobnymi uwagami. lakehouse-reviewer uruchomił Codexa z checklistą oraz lokalny skaner na całym pipeline'ie i zgłosił 5 blockerów. Sprawdziłem te blockery: na danych demo realny jest tylko brak maskowania danych osobowych w silver, który był w pipeline'ie już przed PR #1. Pozostałe cztery to zasadne zastrzeżenia na przyszłe dane (np. nowe statusy zamówień), ale dziś nie zmieniają wyniku. Różnica wynika głównie z innego promptu i zakresu (sam diff warstwy gold kontra cały pipeline z checklistą), a do tego to pojedyncze przebiegi, więc nie wyciągałbym z nich wniosków o samym Codexie. Na prelekcji ująłem to tak: „A single LLM review is a sample, not a verdict.” Pojedyncze review LLM to próbka, a nie werdykt, dlatego zakres i checklistę warto podać wprost.
Pułapki
- Codex wyczerpał limit planu ChatGPT w środku demo. Polly zachowała się dobrze, bo czekała, zamiast zmieniać dostawcę, ale cały przebieg wydłużył się o czas do resetu.
- Lokalny model nadaje się na pierwszy przebieg, ale nie na ostateczne review, co dobrze widać po tymczasowym review z demo 3.
- Zdanie „nic nie opuszcza laptopa” nie jest precyzyjne. Model lokalny oznacza, że kodu nie widzi dostawca modelu, ale transkrypt sesji jest zapisany na serwerze Omnigent, w Lakebase.
- Panel Pull Requests pokazał „No open PR for main”, bo PR powstał z gałęzi sub-agenta, więc trzeba go było podpiąć ręcznie przez „Link a PR”.
- Globalne ustawienia harnessu przechodzą na sub-agentów. Mój globalny Claude Code ma ustawiony język polski i raport sub-agenta zaczął się od „Gotowe. Raport…”, mimo że zadanie było po angielsku. Lokalny
CLAUDE.mdw repo przestawił na angielski resztę pracy, ale nie ten raport, dlatego w filmie jest zasłonięty. - Sub-agentów Polly nie da się ułożyć w siatce sesji obok siebie, bo siatka bierze tylko sesje najwyższego poziomu. Zostaje panel Agents i podgląd terminala każdego z nich.
- Siatka sesji i własni agenci w Settings są za feature flagami. Przy samodzielnym deployu trzeba je włączyć, a Databricks CLI czyta wartość z przecinkami jak listę, więc w moim buildzie trzeba było poprawić, jak
deploy.pyją przekazuje (stąd lokalna poprawka).
Gdzie to się opłaca, a gdzie nie
W data engineeringu widzę pięć miejsc, gdzie zespół agentów ma sens:
- review pipeline'ów i bundle'i przez model innego dostawcy przed merge'em,
- migracje rozdzielone na wielu agentów, z jednym worktree i jednym PR na notebook,
- analiza incydentów w jobach przez agentów tylko do odczytu, gdzie decyzję podejmuje człowiek,
- audyt danych osobowych i bezpieczeństwa lokalnym modelem,
- dokumentacja i opisy zmian generowane z diffów.
Nie ma to sensu, gdy jeden asystent dobrze radzi sobie z zadaniem, gdy nie mamy testów ani przebiegu na danych (agenci nie mają wtedy czego sprawdzić, a bundle validate sprawdza tylko konfigurację, nie logikę), przy pracy, w której liczy się czas odpowiedzi, oraz wtedy, gdy kilka modeli kosztuje więcej, niż daje.
Zanim pozwolimy pracować w ten sposób całemu zespołowi, przeszedłbym taką checklistę:
- tożsamość: SSO przez Databricks Apps, a w Sandbox agent działa jako użytkownik (tego nie testowałem),
- dane: dostęp przez uprawnienia w Unity Catalog,
- modele: Unity Gateway z atrybucją (tego też nie testowałem, od Omnigent 0.20.0),
- guardraile:
blast_radius,spawn_boundsi budżety kosztów, - merge: zawsze robi człowiek.
Czy potrzebujesz do tego Omnigent
Naturalne pytanie brzmi: czemu nie wystarczą sub-agenci w Claude Code. To zależy :) Sub-agenci w Claude Code dobrze dzielą pracę, ale natywnie działają na modelach jednego dostawcy, więc nie dają review innym modelem. Jeśli chodzi tylko o drugą parę oczu na PR, najprostsza jest akcja w CI, która wywołuje model innego dostawcy na diffie i wymaga pliku i linii przy każdej uwadze. To nie wymaga dodatkowego serwera.
Omnigent zaczyna się opłacać, gdy chcemy mieć w jednym miejscu kilku dostawców i model lokalny, sesje współdzielone z zespołem oraz polityki po stronie serwera, które działają tak samo na każdym harnessie. Kosztem jest dodatkowy serwer do utrzymania (u mnie Databricks App i Lakebase) oraz to, że projekt jest wciąż w wersji alpha.
Co dalej?
Jeśli chcecie spróbować, zacząłbym od czegoś małego. Weźcie jeden niewielki PR z pipeline'em i dajcie go do review modelowi innego dostawcy niż ten, który pisał kod. Wymagajcie, żeby każda uwaga miała plik i linię, a zmiana przechodziła bundle validate oraz testy albo przebieg na danych.
Omnigent można włączyć jako wersję zarządzaną (Beta, strona Previews, regiony z Unity Gateway) albo postawić samodzielnie na Databricks Apps według przewodnika z repo. Repo projektu jest na github.com/omnigent-ai/omnigent, a instrukcja instalacji na omnigent.ai/quickstart/install.
Prelekcję zamknąłem trzema zdaniami: „Let the agents disagree. Make them show their evidence. Own the merge.” Niech agenci się spierają i pokazują dowody, a merge niech zostanie po Waszej stronie.
Chcesz kolejne wpisy? Obserwuj przez RSS albo na LinkedInie.
Komentarze
Na razie cisza na szlaku. Napisz pierwszy komentarz.